Benchmaxxed oder brillant? Was mir eine kaputte Lavalampe über die Modellwahl beigebracht hat
13. Oktober 2026
Bild vom Autor. Diagramm: Artificial Analysis. Muse ist eine Marke von Meta.
Als Meta Muse Wonder veröffentlicht hat, habe ich auf Twitter nach ersten Erfahrungsberichten gescrollt und etwas Seltsames gefunden. Ich habe auf eine Lavalampe ohne Lava geschaut. Auch ohne Glas, nur ein roter Zylinder auf einem Lampenfuß. Das Bild stammte aus einem Lavalampen-Test , der vier Modellen denselben Prompt gegeben hat [4]. Drei davon haben eine Glaslampe mit orangem Wachs darin gerendert. Muse Wonder hat den roten Zylinder gerendert.
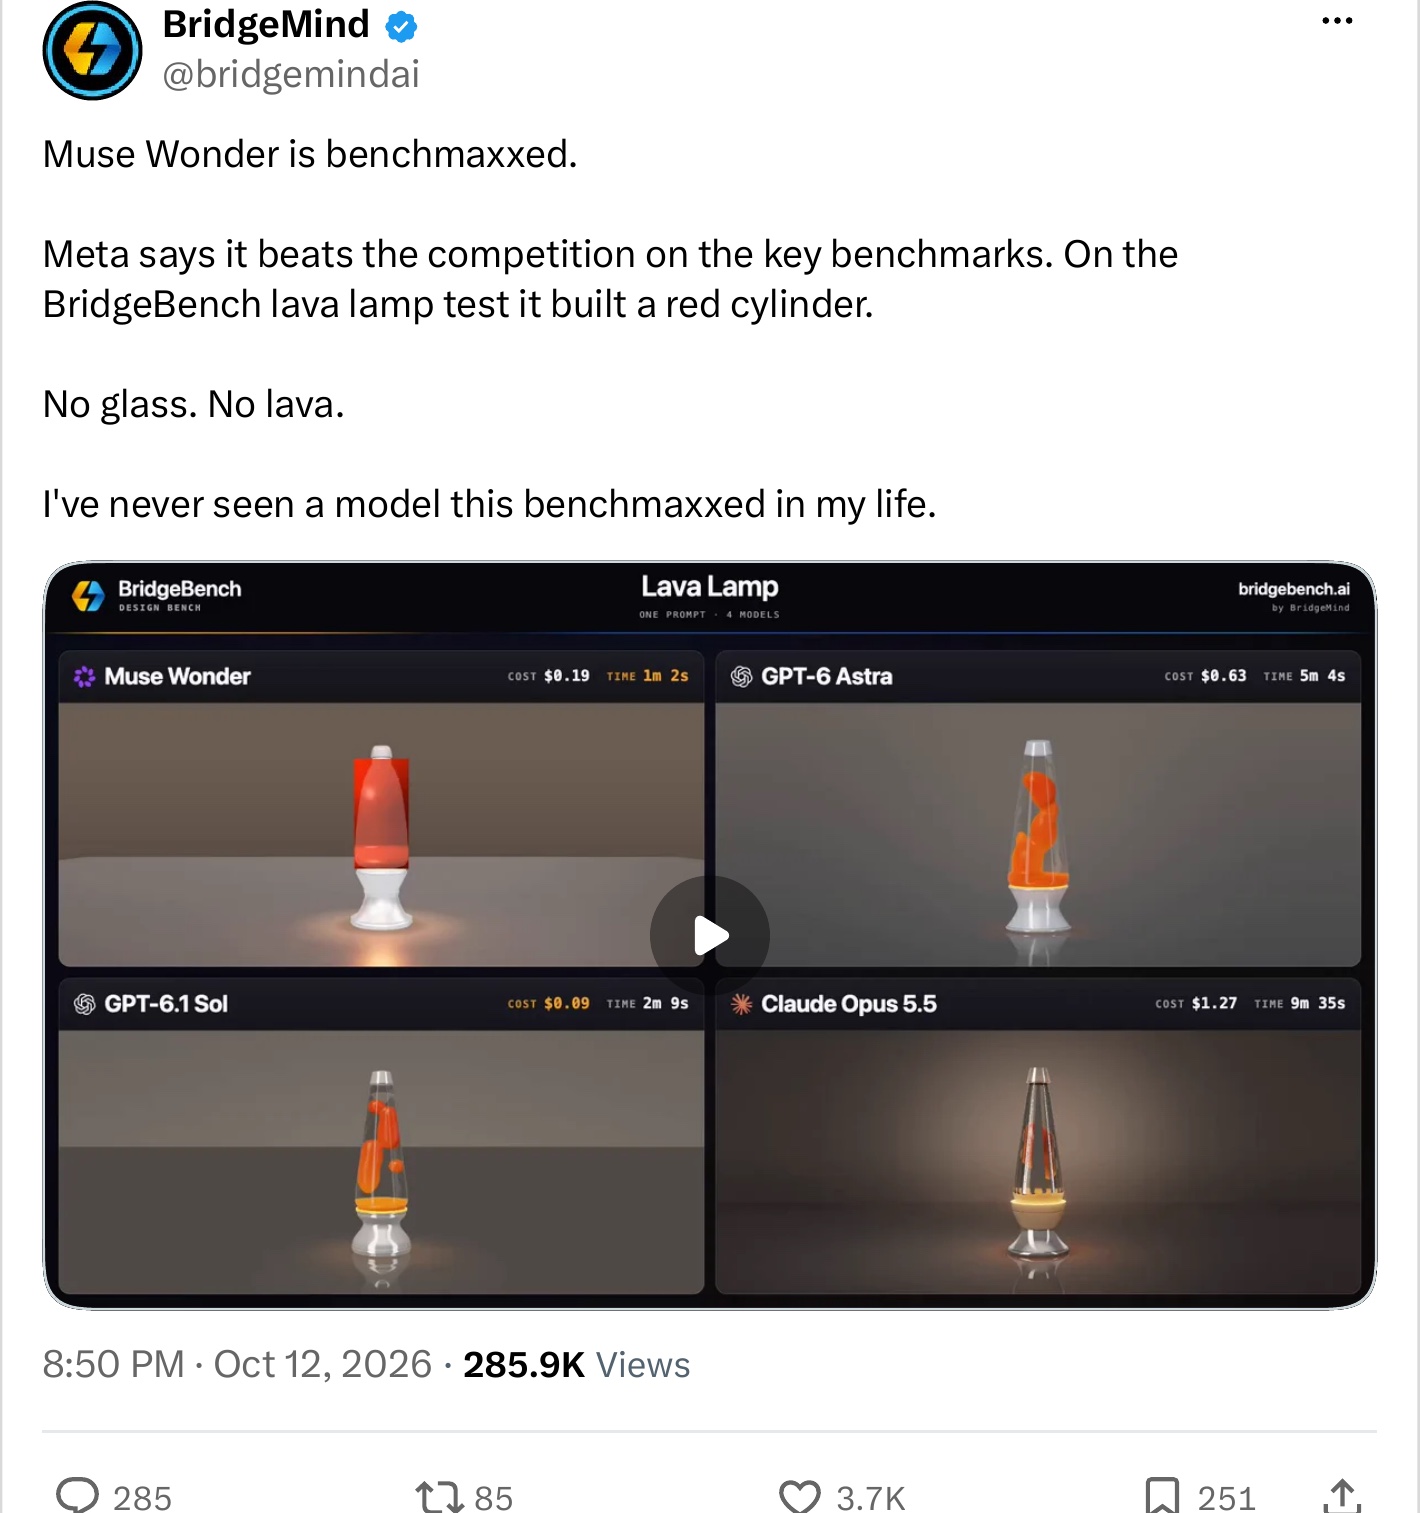
BridgeMind, 12 Oct 2026. https://x.com/bridgemindai/status/2109733498114417013
Es gab viele ähnliche Posts, die sagten, das Modell sei „benchmaxxed“ (also darauf getrimmt, in Benchmarks gut abzuschneiden, aber losgelöst von der Nutzung in der echten Welt). Ganz so einfach ist es aber nicht.
LLMs sind komplex, und ihre Fähigkeiten zu bewerten ist noch komplexer. Ja, was auf LinkedIn oder X zu sehen ist, ist ein Indikator. Aber wer auf Engagement aus ist, bekommt mit einem Empörungspost mehr Reichweite als mit einem differenzierten Post. Das sollte man als Einordnung im Kopf behalten und nicht komplett auf Internet-Hype oder einen Shitstorm hereinfallen. Ich mache das, was ich bei jedem neuen Modell mache: zuerst die Benchmarks, dann die echte Welt.
Ja, nach den unabhängigen Benchmarks würde ich Meta jetzt als Frontier-Lab zählen. Im Artificial Analysis Intelligence Index erreicht das größere Muse Wonder Full 56 Punkte, also nur zwei Punkte hinter Claude Opus 5.5 an der Spitze [2], und wenn die Presse es Metas erstes Frontier-Modell nennt, finde ich das nach diesen Zahlen fair [3].
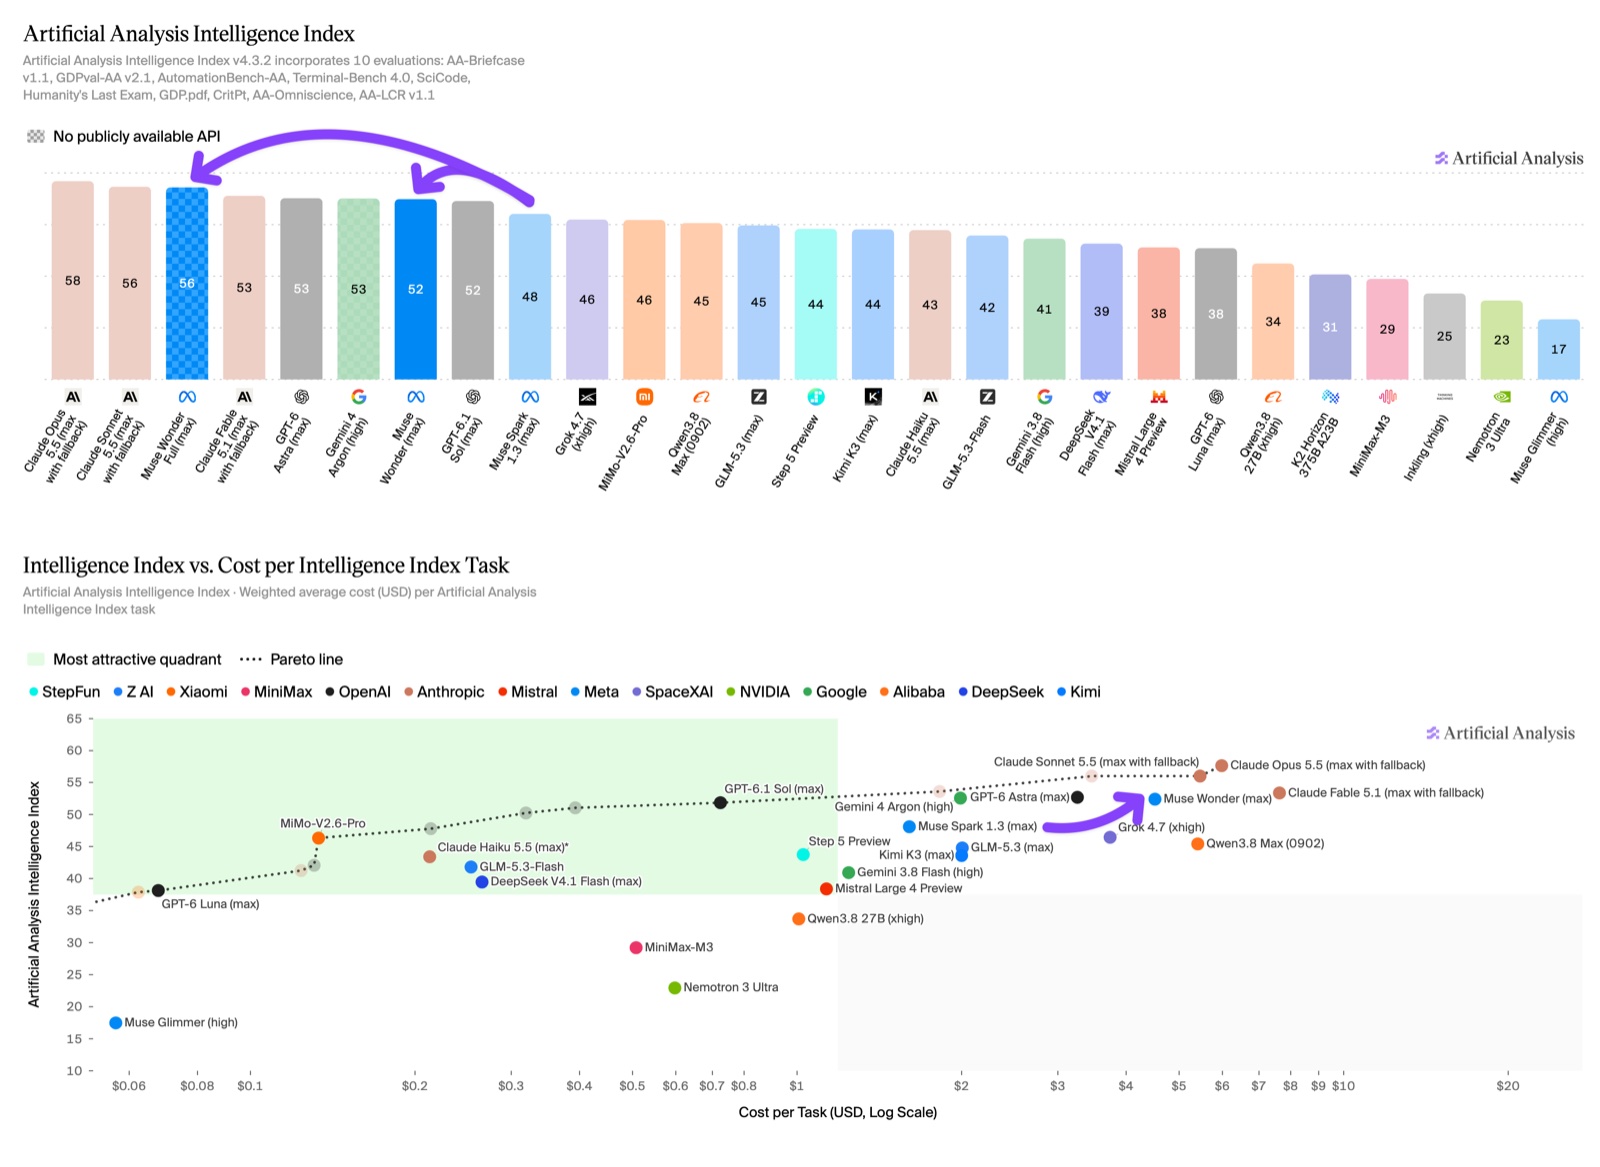
Artificial Analysis, Intelligence Index v4.3.2, accessed 13 Oct 2026. Screenshot unmodified. https://artificialanalysis.ai/articles/muse-wonder
Trotzdem sind Benchmarks nur die erste Hälfte meiner Prüfung. Man kann sie so lange anpassen und tunen, bis sie auf nichts mehr verallgemeinern, deshalb schaue ich mir als Nächstes immer praktische Ergebnisse an.
Empörungsposts auf X sind ein schwaches Signal, weil ein schlechtes Rendering sehr wenig über ein so komplexes Modell aussagt, aber ich sehe sie trotzdem als eine Art Indikator. Und nach den 3D-Screenshots, die ich gesehen habe, scheint Muse Wonder da wirklich nicht viel zu können.
Also schaue ich mir die Details hinter den Screenshots an. Die Lavalampe zum Beispiel lief auf dem kleineren Muse Wonder, und dieser Lauf hat nur einen Bruchteil dessen gekostet, was der Opus-Lauf gekostet hat [4]. Im Rasenmäher-Vergleichhat Opus klar das bessere Bild gemacht, zu etwa den 24-fachen Kosten [5]. Und Meta hat nie dafür trainiert. Alexandr Wang, der die Meta Superintelligence Labs leitet, hat das selbst gesagt [7].
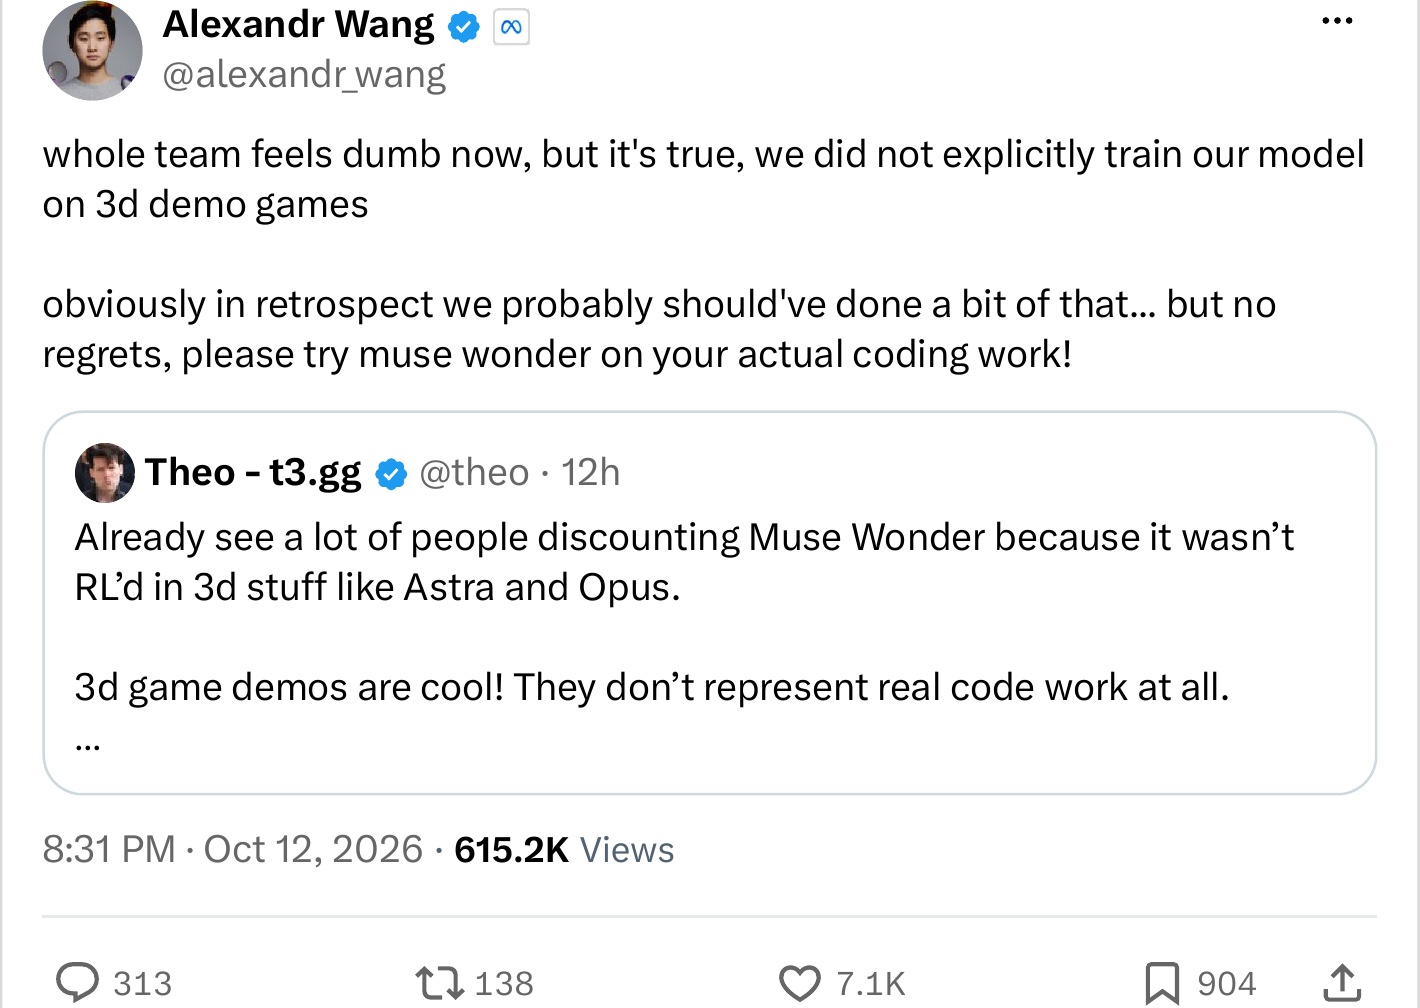
Alexandr Wang, 12 Oct 2026. https://x.com/alexandr_wang/status/2109728684802523156
Ist es also benchmaxxed? Ehrlich gesagt glaube ich nicht, dass man das nach einem Tag voller geposteter Renderings sagen kann. Ein roter Zylinder und ein Agenten-Benchmark messen völlig verschiedene Dinge, das eine hebt das andere also nicht auf [6]. Aber gut, Meta hat es ein bisschen herausgefordert, die erste Demo in ihrem eigenen Launch-Post ist „a playable 3D kitchen game“ [1], da kann man den Leuten kaum vorwerfen, genau das auszuprobieren. Für ein Kundenprojekt, das schon läuft, ändert das für mich sowieso nicht viel.
Nein, und ich würde sogar so weit gehen zu sagen, dass es eine schreckliche Idee ist, einen laufenden Workflow umzustellen, weil irgendein Benchmark um zwei Punkte gestiegen ist.
Die Modellauswahl ist ein großer Teil jedes Projekts, das wir machen, egal ob für einen Kunden oder für unsere eigenen Prozesse, und bei JadenX ist das der Grund, warum die Implementierungsphase ziemlich viel Zeit braucht. Wir lassen verschiedene Modelle auf dem echten Prozess des Kunden gegeneinander antreten und machen so lange weiter, bis wir das finden, das dafür am besten funktioniert. Dabei bauen wir die Qualitätskontrolle rund um dieses Modell auf und gewinnen Vertrauen darin, wie es sich verhält.
Deshalb behalten wir ein Modell so lange wie möglich. Ein Wechsel bedeutet eine Migration, und eine Migration bedeutet, einen Großteil dieser Tests noch einmal zu machen. Wenn es einen echten Grund für einen Wechsel gibt, machen wir ihn, klar. Sonst halte ich das Modell aber stabil, bis es einen echten Unterschied in Inhalt und Qualität gibt, also einen Generationssprung, der sich auf genau diesen Anwendungsfall wirklich auswirkt, und ein Plus von zwei Punkten in einem öffentlichen Index ist das einfach nicht.
Und selbst wenn der Sprung eine neue Generation ist, kommt in Europa dann das nächste Problem, und das hat mehr mit dem Vertrag zu tun als mit der Qualität.
Bei einem europäischen Kunden bleibt Muse Wonder meistens am Vertrag hängen. Wenn ich mit Datenschutzbeauftragten spreche, wollen sie wissen, wo die Daten liegen, ob sie fürs Training genutzt werden und wo sie verarbeitet werden. Laut Metas API-Datenbedingungenhängt die Nutzung fürs Training vom Service-Tarif ab, und ihre geografische Richtlinie erlaubt Meta im Grunde, den Zugang pro Land umzuschalten, wann immer sie wollen [8][9].
Ich gehe über die Cloud-Anbieter, mit denen meine Kunden schon Service Level Agreements haben. Ein Kunde auf AWS mit dem Modell auf AWS, das ist einfach. Meta ist aber kein großer Cloud-Anbieter, und fast kein Unternehmen hat einen Vertrag mit ihnen, also steht ein komplett neuer Beschaffungsprozess an, neue Auftragsverarbeitungsverträge und bei den größeren Kunden noch individuelle Bedingungen obendrauf. Für die meisten europäischen Unternehmen ist es der schwierigere Teil, Meta als neuen Anbieter unter Vertrag zu nehmen, viel schwieriger als alles am Modell selbst.
Dasselbe gilt für Active Memory, Metas wichtigstes Feature. Alle großen Assistenten merken sich inzwischen Dinge, und genau genommen ist es die Anwendung rund um das Modell, die sich etwas merkt. Wenn sich das Gedächtnis an- und ausschalten lässt, gut, dann passt es. Wenn nicht, kann das für Unternehmen ein Problem sein.
Ein Modell für ein Projekt wählt man aus, indem man zuerst auf den Prozess schaut, und das Modell kommt später. Die Frage ist also, ob für die konkrete Aufgabe ein Frontier-Modell auf diesem Niveau nötig ist oder ob etwas Günstigeres, und wahrscheinlich etwas Schnelleres, gut genug ist. Ein Backoffice-Prozess braucht keine Lavalampe, er braucht ein Modell, das die Aufgabe zu einem sinnvollen Preis erledigt.
Bei JadenX gehen wir das in vier Schritten durch. Wenn mich ein Kunde fragt „Sollen wir Muse Wonder nutzen?“, fange ich genau mit dieser Prozessfrage an. Dann schaue ich mir die Kandidaten an, zuerst die unabhängigen Benchmarks und danach die praktischen Tests, und dann den Vertrag, idealerweise über einen Cloud-Anbieter wie AWS, mit dem der Kunde schon einen Vertrag hat. Und wenn ein Modell einmal in Produktion ist, bleibt es dort, außer es kommt für diesen Anwendungsfall etwas Generationelles.
Muse Wonder macht Meta zu einem glaubwürdigen Frontier-Lab, aber wie jedes andere Modell muss es sich seinen Platz in jedem Prozess erst verdienen. Was ich aus diesem Launch mitnehme, ist wirklich, dass man nicht komplett auf Internet-Hype oder einen Shitstorm hereinfallen sollte. Was auf LinkedIn oder X zu sehen ist, ist ein Indikator, klar, aber Empörung bekommt einfach mehr Engagement als Differenzierung. In meinem Feed haben alle gefragt, ob Muse Wonder benchmaxxed ist, und mir wäre lieber, meine Kunden fragen, ob es ihren Prozess besteht, zu einem Preis, den sie akzeptieren, mit einem Anbieter, den sie tatsächlich unter Vertrag nehmen können. Ein guter Benchmark-Wert sagt das nicht, und ein viraler Fehlschlag auch nicht, das findet man nur heraus, wenn man es am eigenen Prozess testet.
Wer Muse Wonder oder ein anderes Modell am eigenen Geschäftsprozess testen möchte, erreicht mich einfach über jadenx.com.
Ist Muse Wonder benchmaxxed? Ich halte das nicht für bewiesen. Es erreicht 52 (Wonder) und 56 (Wonder Full) Punkte im Artificial Analysis Intelligence Index v4.3.2 (abgerufen am 13. Oktober 2026), auch wenn es bei einigen One-Shot-3D-Tests schlecht abgeschnitten hat.
Ist Muse Wonder gut für Unternehmensagenten? In den unabhängigen agentischen Tests sieht es stark aus. Bei einem europäischen Unternehmen würde ich mir mehr Sorgen um die Beschaffung und die Datenbedingungen machen.
Lohnt sich der Wechsel von Claude Opus 5.5? Nur wenn es die eigenen Prozesstests besteht und der Sprung wirklich eine neue Generation ist. Der Token-Preis ist gleich, also entscheidet der Preis die Frage nicht.
[1] Meta Superintelligence Labs, “Muse Wonder”, Meta AI Research, 12 Oct 2026. https://research.meta.ai/blog/muse-wonder. Meta makes no benchmark claim about 3D; its claims are about agent work and coding. Meta’s own comparison chart, as tabulated by Fello AI (https://felloai.com/muse-wonder/, 12 Oct 2026), has Wonder Full winning 7 of 14 rows against Fable 5.1, GPT-6 Astra and Opus 5.5; two of those wins are on Meta-internal benchmarks. These are vendor-reported numbers.
[2] Artificial Analysis, “Muse Wonder and Muse Wonder Full: a material jump in intelligence over previous Meta models”, Intelligence Index v4.3.2, 12 Oct 2026, accessed 13 Oct 2026. https://artificialanalysis.ai/articles/muse-wonder. Independent results at max effort: Intelligence Index v4.3.2 Claude Opus 5.5 58, Claude Sonnet 5.5 56, Muse Wonder Full 56, Muse Wonder 52, Muse Spark 1.3 48 (released six weeks earlier). Coding Agents Index: Wonder Full 68, Sonnet 5.5 68, Opus 5.5 66, Wonder 63. Wonder Full vs Spark 1.3: Terminal-Bench 4.0 from 33% to 57%, hallucination rate from 33% to 23%. Pricing: Muse Wonder $4 input / $20 output per million tokens, the same as Opus 5.5; Wonder Full is only available in Muse Code.
[3] TechCrunch, “Meta releases its first frontier model, Muse Wonder”, 12 Oct 2026. https://techcrunch.com/2026/10/12/meta-releases-its-first-frontier-model-muse-wonder/
[4] BridgeBench lava lamp test, X, 12 Oct 2026. https://x.com/bridgemindai/status/2109733498114417013. Per run, as shown in the screenshot: Muse Wonder (not Wonder Full) $0.19, 1m 2s; GPT-6 Astra $0.63, 5m 4s; GPT-6.1 Sol $0.09, 2m 9s; Claude Opus 5.5 $1.27, 9m 35s.
[5] Lawn mower game comparison, X, 12 Oct 2026. https://x.com/_MaxBlade/status/2109723440710066646. Same prompt; API-equivalent cost as posted: Muse Wonder Full $4.11, Claude Opus 5.5 $99.43 (about 24 times more).
[6] Further context on 12 to 13 Oct 2026: Meta’s own Minecraft clone run produced a working voxel world, and Meta suspected a bug in a failed public test (https://x.com/alexandr_wang/status/2109726240789905548). Meta also fixed a launch-day bug in how Muse Code counted usage limits (https://x.com/alexandr_wang/status/2109714291062620560). Design Arena ranks Muse Wonder (max) #4 for websites, 59% win rate over 276 tournaments, accessed 13 Oct 2026 (https://www.designarena.ai/models/muse-wonder-1.0). Arena had added the model to Agent Arena with no score published yet (https://x.com/arena/status/2109706854700044523).
[7] Alexandr Wang, “whole team feels dumb now, but it’s true, we did not explicitly train our model on 3d demo games”, X, 12 Oct 2026. https://x.com/alexandr_wang/status/2109728684802523156
[8] Meta, “Meta Model API Data Commitments”, accessed 13 Oct 2026. https://dev.meta.ai/legal/commitments. Standard Services content is not used for training; “Discounted Services” content may be.
[9] Meta, “Meta Model API Model Designation and Geographic Use Policy”, accessed 13 Oct 2026. https://dev.meta.ai/legal/geographic-use-policy. Meta may “enable or restrict access in any jurisdiction at any time in its sole discretion”.
Über diesen Artikel: Ich arbeite mit einem Diktat-Workflow. Ich spreche meine Gedanken ein, und mehrere KI-Agenten helfen mir, Quellen zu recherchieren und aus dem Diktat einen Entwurf zu machen. Jede Zeile prüfe und überarbeite ich, bevor sie rausgeht. Die Meinungen sind meine eigenen. JadenX hat keine geschäftliche Beziehung zu Meta.
Dieser Artikel erschien zuerst in Deep Tech Innovation auf Medium.