Benchmaxxed ou brillant ? Ce qu’une lampe à lave ratée m’a appris sur le choix des modèles
13 octobre 2026
Image de l’auteur. Graphique : Artificial Analysis. Muse est une marque de Meta.
Quand Meta a lancé Muse Wonder, je faisais défiler Twitter à la recherche des premiers retours d’utilisateurs et je suis tombé sur quelque chose de bizarre. Je regardais une lampe à lave sans lave. Sans verre non plus, juste un cylindre rouge sur un pied de lampe. Ça venait d’ un test de lampe à lave qui donnait le même prompt à quatre modèles [4]. Trois d’entre eux ont rendu une lampe en verre avec de la cire orange à l’intérieur. Muse Wonder a rendu le cylindre rouge.
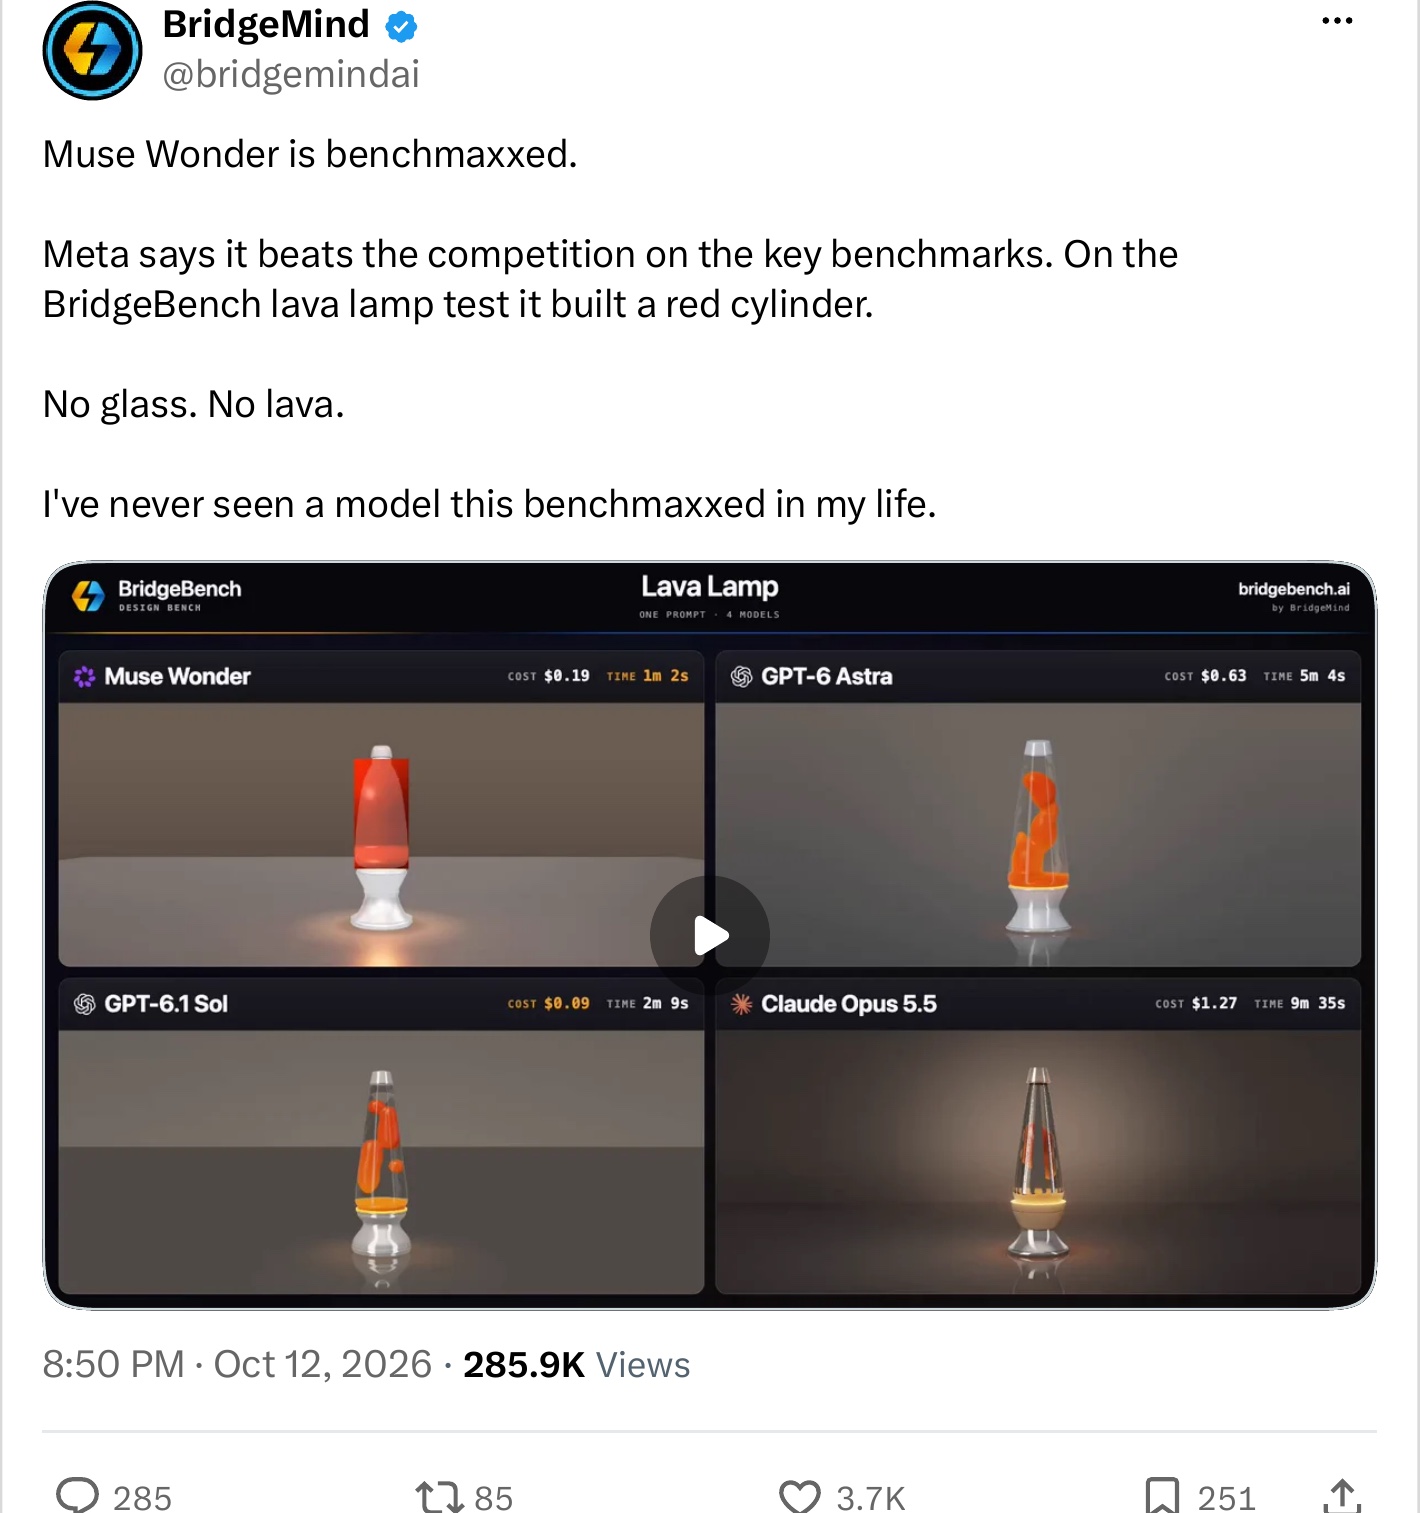
BridgeMind, 12 Oct 2026. https://x.com/bridgemindai/status/2109733498114417013
Il y a eu beaucoup de posts du même genre disant que le modèle est « benchmaxxed » (c’est-à-dire réglé pour bien réussir les benchmarks mais déconnecté de l’usage réel). Mais ce n’est pas aussi simple.
Les LLM sont complexes, et évaluer leurs capacités l’est encore plus. Oui, ce que vous voyez sur LinkedIn ou X est un indicateur. Mais ceux qui cherchent l’engagement gagnent plus avec un post d’indignation qu’avec un post nuancé, alors gardez ça en tête pour prendre du recul et ne tombez pas complètement dans le hype d’Internet ou dans un shitstorm. Je fais ce que je fais avec chaque nouveau modèle : d’abord les benchmarks, ensuite le monde réel.
Oui, d’après les benchmarks indépendants, je compterais désormais Meta parmi les laboratoires de pointe. Sur l’ Artificial Analysis Intelligence Index , le plus grand Muse Wonder Full obtient 56, donc seulement deux points derrière Claude Opus 5.5 en tête [2], et quand la presse parle du premier modèle de pointe de Meta, je trouve ça juste au vu de ces chiffres [3].
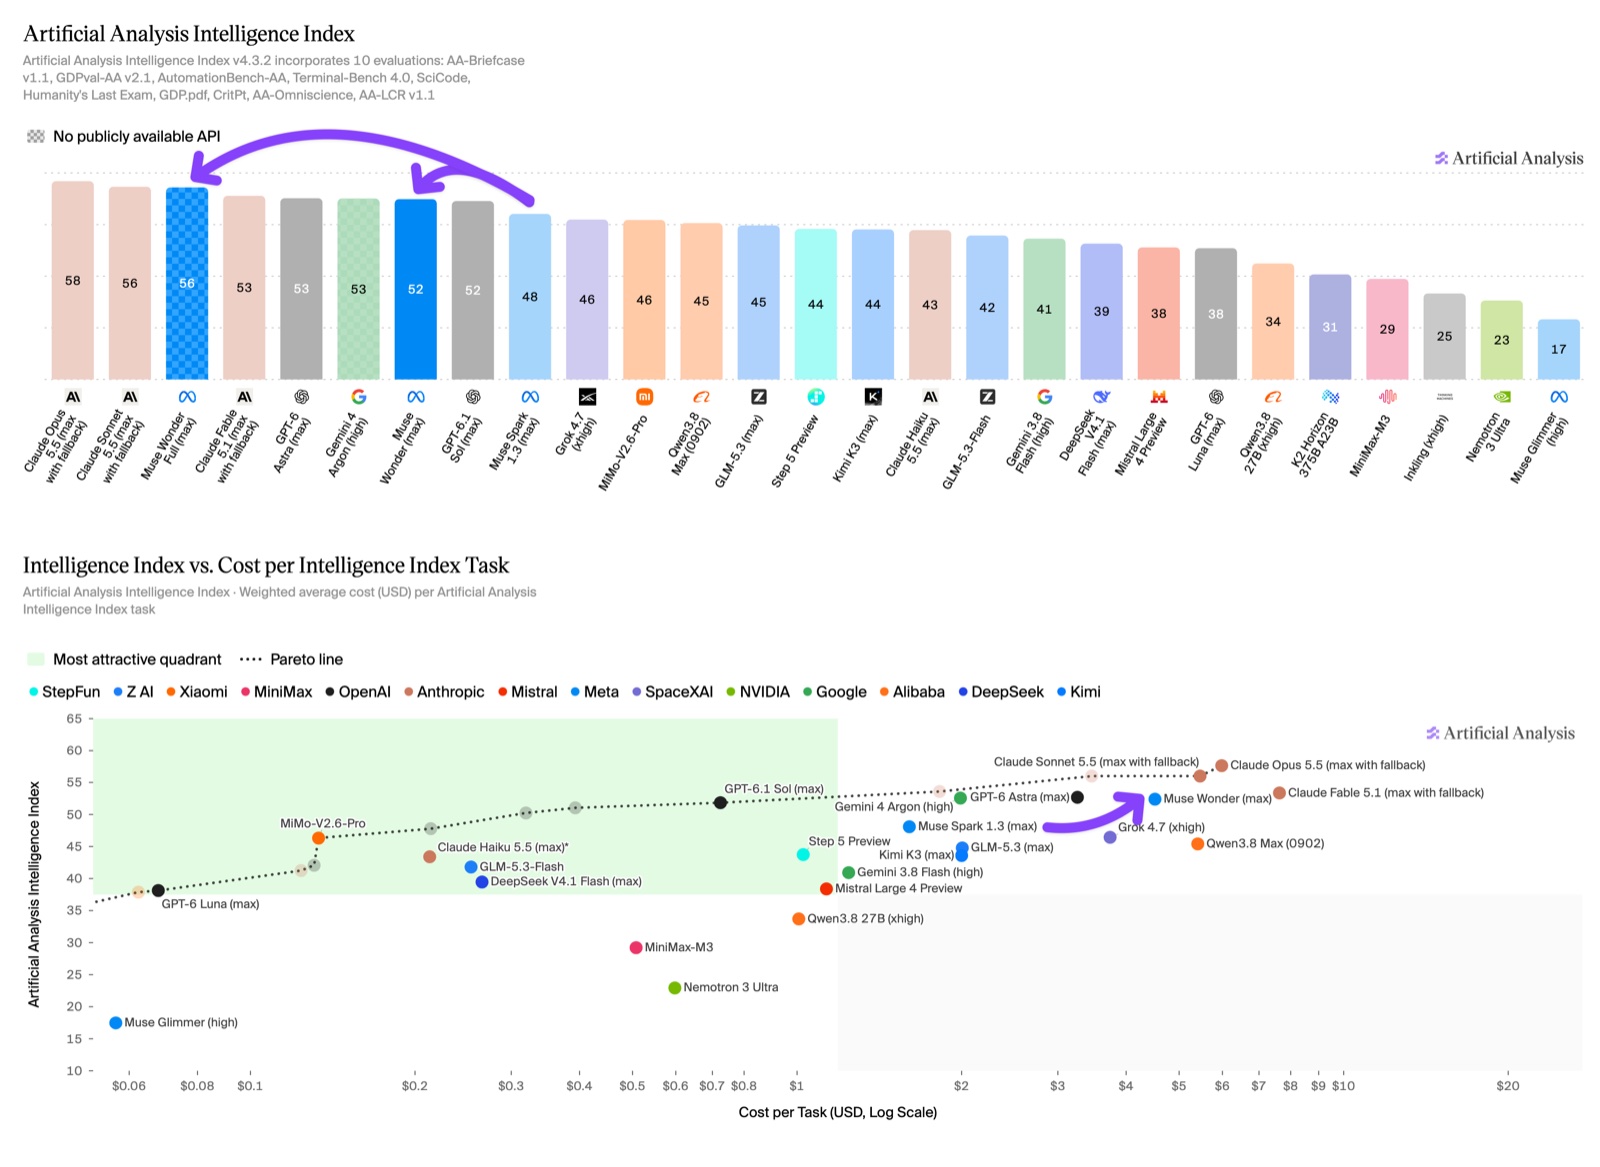
Artificial Analysis, Intelligence Index v4.3.2, accessed 13 Oct 2026. Screenshot unmodified. https://artificialanalysis.ai/articles/muse-wonder
Cela dit, les benchmarks ne sont que la première moitié de ma vérification. On peut les ajuster et les optimiser jusqu’à ce qu’ils ne se généralisent plus à rien, donc je regarde toujours ensuite les résultats pratiques.
Les posts d’indignation sur X sont un signal faible, parce qu’un mauvais rendu en dit très peu sur un modèle aussi complexe, mais je les regarde quand même comme une sorte d’indicateur. Et d’après les captures 3D que j’ai vues, Muse Wonder ne semble vraiment pas faire grand-chose de ce côté.
Alors je regarde les détails derrière les captures. La lampe à lave, par exemple, tournait sur le plus petit Muse Wonder, et ce run a coûté une fraction de ce qu’a coûté celui d’Opus [4]. Dans la comparaison de la tondeuse, Opus a clairement fait la meilleure image, pour environ 24 fois le coût [5]. Et Meta ne s’est jamais entraîné pour ça. Alexandr Wang, qui dirige Meta Superintelligence Labs, l’a dit lui-même [7].
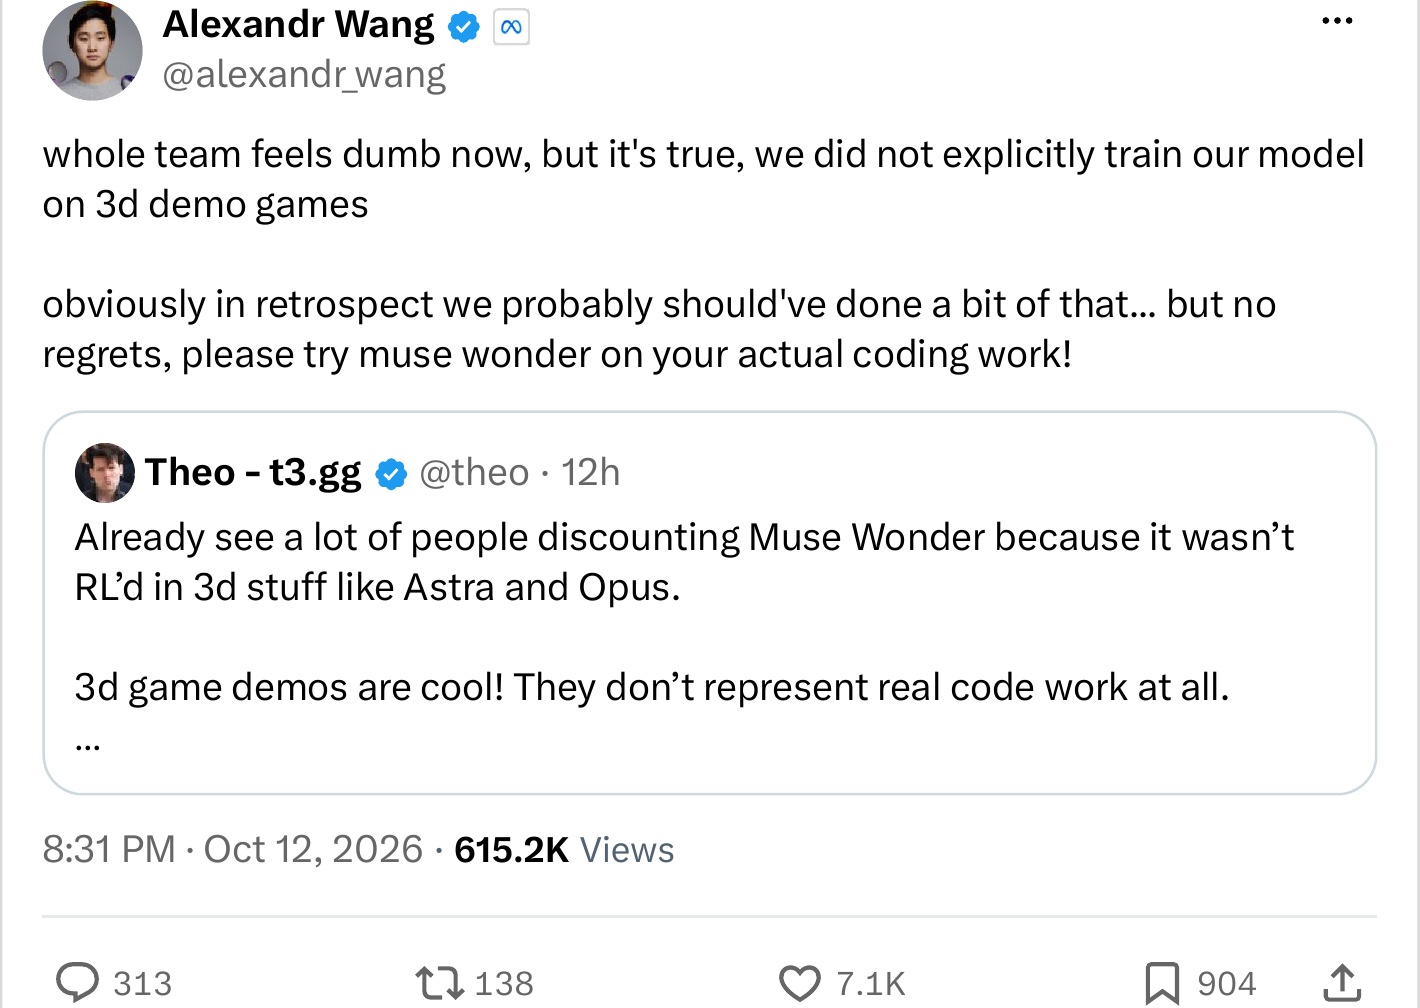
Alexandr Wang, 12 Oct 2026. https://x.com/alexandr_wang/status/2109728684802523156
Alors, est-ce benchmaxxed ? Honnêtement, je ne pense pas qu’on puisse le dire après une journée de rendus postés. Un cylindre rouge et un benchmark d’agents mesurent des choses totalement différentes, donc l’un n’annule pas l’autre [6]. Mais bon, Meta l’a un peu cherché, la première démo de leur propre post de lancement est « a playable 3D kitchen game » [1], donc on ne peut pas vraiment reprocher aux gens d’avoir essayé exactement ça. Pour un projet client déjà en cours, rien de tout ça ne change grand-chose pour moi de toute façon.
Non, et j’irais jusqu’à dire que c’est une très mauvaise idée de changer un workflow en production parce qu’un benchmark a gagné deux points.
Le choix du modèle est une grande partie de chaque projet que nous menons, que ce soit pour un client ou pour nos propres processus, et chez JadenX c’est la raison pour laquelle la phase d’implémentation prend pas mal de temps. Nous mettons différents modèles en concurrence sur le vrai processus du client et nous continuons jusqu’à trouver celui qui fonctionne le mieux. Pendant ce temps, nous construisons le contrôle qualité autour de ce modèle et nous gagnons confiance dans son comportement.
Donc nous gardons un modèle le plus longtemps possible. Un changement implique une migration, et une migration implique de refaire une grande partie de ces tests. S’il y a un vrai besoin de changer, nous le faisons, bien sûr. Sinon je garde le modèle stable jusqu’à ce qu’il y ait une vraie différence de contenu et de qualité, je veux dire un saut de génération qui a vraiment un impact sur ce cas d’usage bien précis, et deux points de plus sur un index public, ce n’est tout simplement pas ça.
Et même si le saut est générationnel, en Europe on se heurte alors au problème suivant, qui tient davantage au contrat qu’à la qualité.
Pour un client européen, c’est en général au niveau du contrat que Muse Wonder bloque. Quand je parle aux délégués à la protection des données, ils veulent savoir où les données sont stockées, si elles servent à l’entraînement et où elles sont traitées. Si vous lisez les conditions de données de l’APIde Meta, l’usage pour l’entraînement dépend du niveau de service, et leur politique géographique permet en gros à Meta de couper ou d’ouvrir l’accès pays par pays quand ils le veulent [8][9].
Moi, je passe par les fournisseurs cloud avec lesquels mes clients ont déjà des accords de niveau de service. Un client sur AWS avec le modèle sur AWS, c’est simple. Mais Meta n’est pas un grand fournisseur cloud, et presque aucune entreprise n’a d’accord avec eux, donc on part sur un tout nouveau processus d’achat, de nouveaux accords de traitement des données et, chez les plus gros clients, des conditions sur mesure en plus. Pour la plupart des entreprises européennes, signer avec Meta comme nouveau fournisseur est la partie la plus difficile, bien plus que tout ce qui concerne le modèle.
Même chose pour Active Memory, la fonctionnalité phare de Meta. Tous les grands assistants retiennent des choses maintenant, et à strictement parler c’est l’application autour du modèle qui mémorise. Si vous pouvez activer et désactiver la mémoire, très bien, ça va. Sinon, ça peut poser problème pour une entreprise.
Vous choisissez un modèle pour votre projet en regardant d’abord le processus, le modèle vient après. Demandez-vous donc si vous avez besoin d’un modèle de pointe de ce niveau pour votre tâche, ou si quelque chose de moins cher, et probablement un peu plus rapide, suffit. Un processus de back-office n’a pas besoin d’une lampe à lave, il a besoin d’un modèle qui fait la tâche à un prix qui a du sens.
Chez JadenX , nous procédons en quatre étapes. Quand un client me demande « Devons-nous utiliser Muse Wonder ? », je commence exactement par cette question de processus. Ensuite je regarde les candidats, d’abord les benchmarks indépendants puis les tests pratiques, et ensuite le contrat, idéalement via un fournisseur cloud comme AWS avec lequel le client a déjà un accord. Et une fois qu’un modèle est en production, il y reste, sauf si quelque chose de générationnel arrive pour ce cas d’usage.
Muse Wonder fait de Meta un laboratoire de pointe crédible, mais comme tout autre modèle, il doit encore gagner sa place dans chaque processus. Ce que je retiens de ce lancement, c’est vraiment qu’il ne faut pas tomber complètement dans le hype d’Internet ou dans un shitstorm. Ce que vous voyez sur LinkedIn ou X est un indicateur, bien sûr, mais l’indignation génère simplement plus d’engagement que la nuance. Dans mon fil, tout le monde se demandait si Muse Wonder est benchmaxxed, et je préfère que mes clients se demandent s’il passe leur processus, à un prix qu’ils acceptent, avec un fournisseur avec lequel ils peuvent réellement signer. Un bon score de benchmark ne vous le dira pas, un échec viral non plus, vous ne le saurez qu’en le testant sur votre propre processus.
Si vous voulez tester Muse Wonder, ou tout autre modèle, sur votre propre processus métier, contactez-moi simplement via jadenx.com.
Muse Wonder est-il benchmaxxed ? Je ne pense pas que ce soit prouvé. Il obtient 52 (Wonder) et 56 (Wonder Full) sur l’Artificial Analysis Intelligence Index v4.3.2 (consulté le 13 octobre 2026), même s’il a mal réussi plusieurs tests 3D en un seul essai.
Muse Wonder est-il bon pour les agents d’entreprise ? Sur les tests agentiques indépendants, il paraît solide. Pour une entreprise européenne, je m’inquiéterais davantage des achats et des conditions de données.
Dois-je quitter Claude Opus 5.5 ? Seulement s’il passe vos propres tests de processus et que le saut est vraiment générationnel. Le prix par token est le même, donc ce n’est pas le prix qui décidera.
[1] Meta Superintelligence Labs, “Muse Wonder”, Meta AI Research, 12 Oct 2026. https://research.meta.ai/blog/muse-wonder. Meta makes no benchmark claim about 3D; its claims are about agent work and coding. Meta’s own comparison chart, as tabulated by Fello AI (https://felloai.com/muse-wonder/, 12 Oct 2026), has Wonder Full winning 7 of 14 rows against Fable 5.1, GPT-6 Astra and Opus 5.5; two of those wins are on Meta-internal benchmarks. These are vendor-reported numbers.
[2] Artificial Analysis, “Muse Wonder and Muse Wonder Full: a material jump in intelligence over previous Meta models”, Intelligence Index v4.3.2, 12 Oct 2026, accessed 13 Oct 2026. https://artificialanalysis.ai/articles/muse-wonder. Independent results at max effort: Intelligence Index v4.3.2 Claude Opus 5.5 58, Claude Sonnet 5.5 56, Muse Wonder Full 56, Muse Wonder 52, Muse Spark 1.3 48 (released six weeks earlier). Coding Agents Index: Wonder Full 68, Sonnet 5.5 68, Opus 5.5 66, Wonder 63. Wonder Full vs Spark 1.3: Terminal-Bench 4.0 from 33% to 57%, hallucination rate from 33% to 23%. Pricing: Muse Wonder $4 input / $20 output per million tokens, the same as Opus 5.5; Wonder Full is only available in Muse Code.
[3] TechCrunch, “Meta releases its first frontier model, Muse Wonder”, 12 Oct 2026. https://techcrunch.com/2026/10/12/meta-releases-its-first-frontier-model-muse-wonder/
[4] BridgeBench lava lamp test, X, 12 Oct 2026. https://x.com/bridgemindai/status/2109733498114417013. Per run, as shown in the screenshot: Muse Wonder (not Wonder Full) $0.19, 1m 2s; GPT-6 Astra $0.63, 5m 4s; GPT-6.1 Sol $0.09, 2m 9s; Claude Opus 5.5 $1.27, 9m 35s.
[5] Lawn mower game comparison, X, 12 Oct 2026. https://x.com/_MaxBlade/status/2109723440710066646. Same prompt; API-equivalent cost as posted: Muse Wonder Full $4.11, Claude Opus 5.5 $99.43 (about 24 times more).
[6] Further context on 12 to 13 Oct 2026: Meta’s own Minecraft clone run produced a working voxel world, and Meta suspected a bug in a failed public test (https://x.com/alexandr_wang/status/2109726240789905548). Meta also fixed a launch-day bug in how Muse Code counted usage limits (https://x.com/alexandr_wang/status/2109714291062620560). Design Arena ranks Muse Wonder (max) #4 for websites, 59% win rate over 276 tournaments, accessed 13 Oct 2026 (https://www.designarena.ai/models/muse-wonder-1.0). Arena had added the model to Agent Arena with no score published yet (https://x.com/arena/status/2109706854700044523).
[7] Alexandr Wang, “whole team feels dumb now, but it’s true, we did not explicitly train our model on 3d demo games”, X, 12 Oct 2026. https://x.com/alexandr_wang/status/2109728684802523156
[8] Meta, “Meta Model API Data Commitments”, accessed 13 Oct 2026. https://dev.meta.ai/legal/commitments. Standard Services content is not used for training; “Discounted Services” content may be.
[9] Meta, “Meta Model API Model Designation and Geographic Use Policy”, accessed 13 Oct 2026. https://dev.meta.ai/legal/geographic-use-policy. Meta may “enable or restrict access in any jurisdiction at any time in its sole discretion”.
À propos de cet article : je travaille avec un workflow de dictée. Je dicte mes idées, et plusieurs agents IA m’aident à rechercher des sources et à transformer ma dictée en brouillon. Je relis et corrige chaque ligne avant publication. Les opinions sont les miennes. JadenX n’a aucune relation commerciale avec Meta.
Cet article a d’abord été publié dans Deep Tech Innovation sur Medium.