Pourquoi la qualité des applications d'IA générative est souvent mauvaise, et que faire
12 novembre 2025
L'engouement pour l'IA générative a déferlé sur le monde de l'entreprise ces deux dernières années. Cette technologie peut rendre l'exécution des processus métier plus efficace, réduire les temps d'attente et les défauts. Des interfaces comme ChatGPT rendent l'interaction avec un LLM simple et accessible. Quiconque a déjà utilisé une messagerie peut saisir une requête sans effort, et ChatGPT générera toujours a une réponse. Pourtant, la qualité et l'adéquation à l' usage prévu de vos contenus générés peuvent varier. C'est particulièrement vrai pour les entreprises qui veulent utiliser l'IA générative dans leurs opérations.
J'ai échangé avec d'innombrables managers et entrepreneurs qui ont échoué faute de pouvoir mettre en production des applications d'IA générative de qualité et d'obtenir des résultats réutilisables d'un modèle non déterministe. J'ai aussi construit plus de trois douzaines d'applications d'IA et constaté une idée reçue fréquente sur la qualité des applications d'IA générative : on pense que tout dépend de la puissance du modèle sous-jacent. Ce n'est pourtant que 30 % de l'histoire.
Il existe des dizaines de techniques, de patterns et d'architectures pour créer des applications à base de LLM utiles et de la qualité qu'attendent les entreprises. Les différents modèles de fondation, les modèles affinés, les architectures avec Retrieval-Augmented Generation (RAG) et les pipelines de traitement avancés ne sont que la partie émergée de l'iceberg.
Cet article montre comment évaluer qualitativement et quantitativement les applications d'IA générative dans le contexte de processus métier concrets. Nous n'en restons pas aux benchmarks génériques : nous présentons des approches pour évaluer les applications d'IA générative. Après une brève analyse de ces applications et de leurs processus métier, nous examinons les questions suivantes :
Ce panorama aboutit à un cadre d'évaluation de bout en bout pour les applications d'IA générative en entreprise, que j'appelle PEEL (performance evaluation for enterprise LLM applications). Sur la base de ce cadre conceptuel, nous présentons un concept de mise en œuvre qui complète le module entAIngine Test Bed de la plateforme entAIngine.
Une organisation vit de ses processus métier. Tout dans une entreprise peut être un processus métier : support client, développement logiciel, opérations. L'IA générative peut rendre ces processus plus rapides et plus efficaces, réduire les temps d'attente et améliorer la qualité des résultats. Chaque activité qui utilise l'IA générative peut toutefois être décomposée encore davantage.
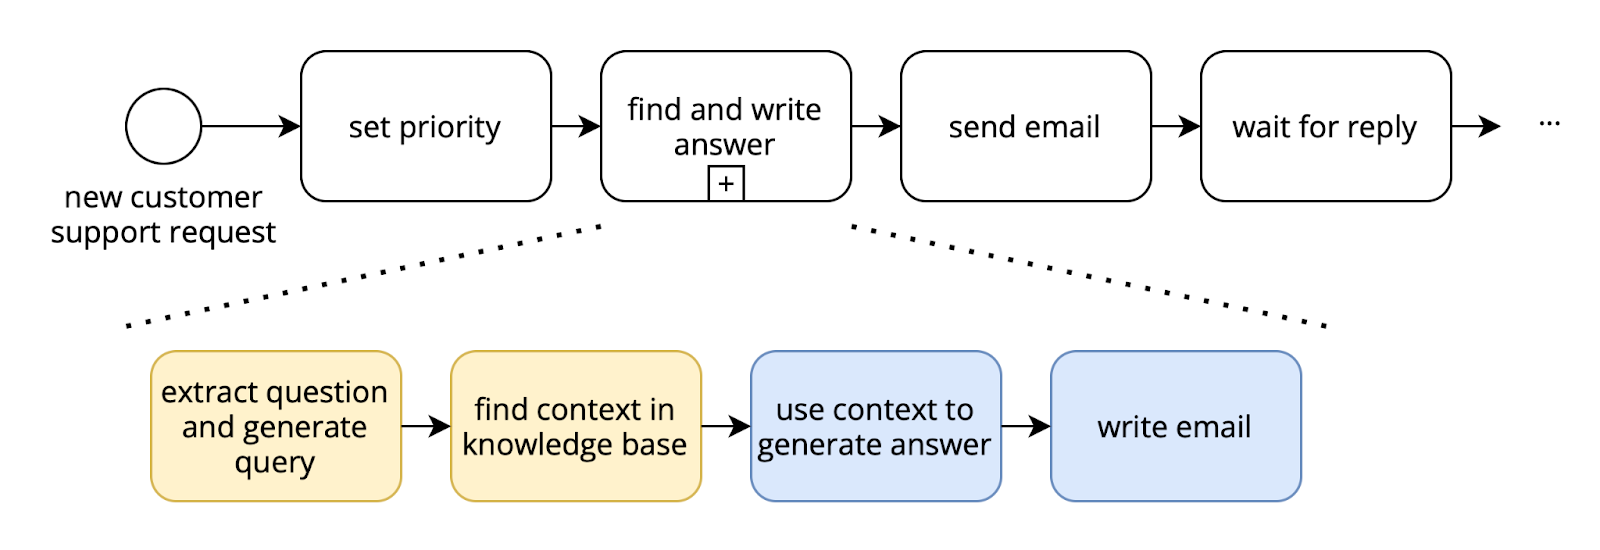
Processus pour les applications d'IA générative. (c) 2025, Marcel Müller
L'illustration montre le début d'un processus simple que suit un agent du support client d'un opérateur télécom. À chaque nouvelle demande, l'agent lui attribue un niveau de priorité. Quand la demande arrive en tête de sa liste, il doit trouver la bonne réponse et rédiger un e-mail. Il l'envoie ensuite au client, attend sa réponse et recommence jusqu'à la résolution de la demande.
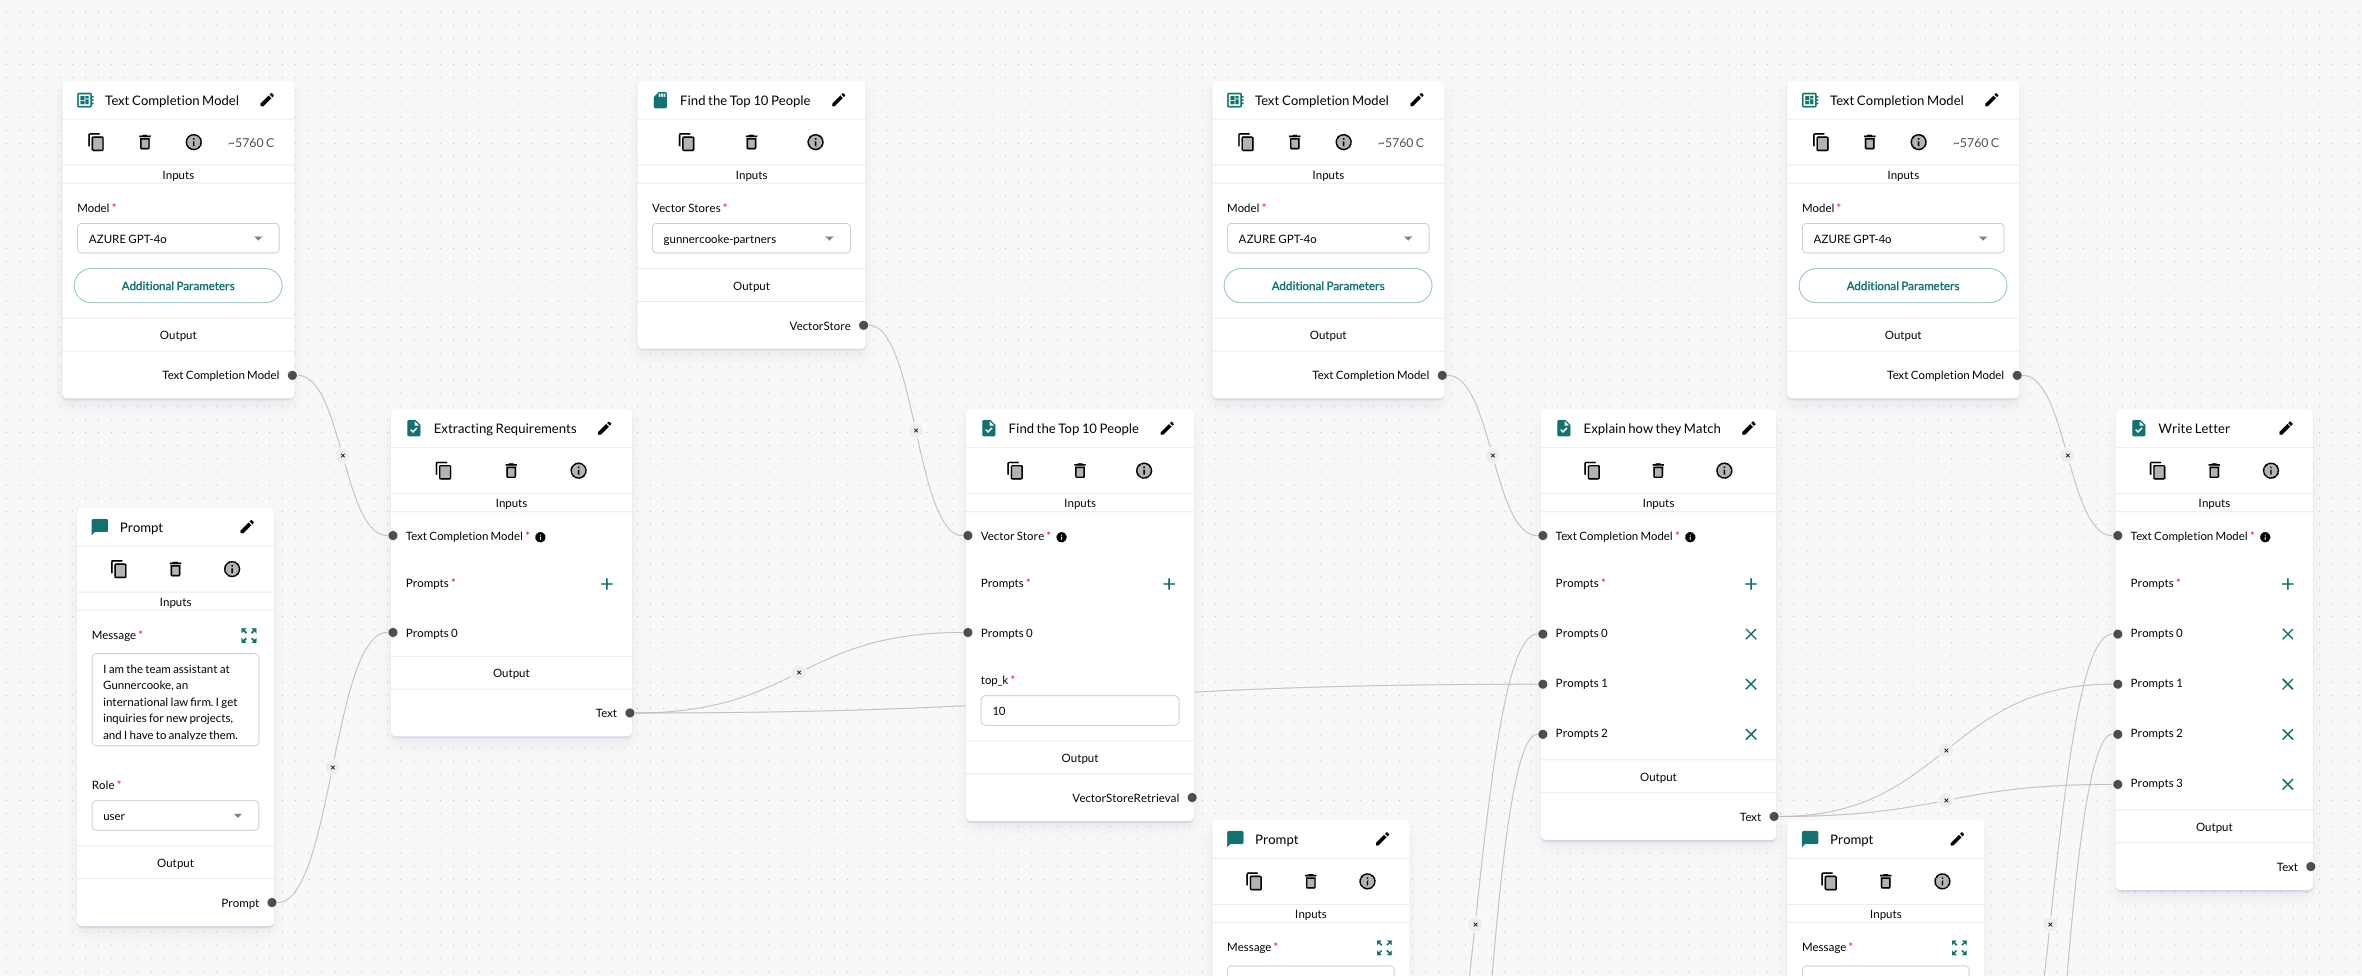
Un workflow d'IA générative peut rendre l'activité « trouver et rédiger la réponse » plus efficace. Mais cette activité n'est souvent pas un simple appel à ChatGPT ou à un autre LLM : c'est un ensemble de tâches. Dans notre exemple, l'opérateur a construit avec la plateforme de processus entAIngine un pipeline composé des étapes suivantes.
L'exécution de tels processus s'appelle l' orchestration d'un workflow LLM avancé. Il existe des dizaines d'autres architectures d'orchestration en entreprise. Une interface de chat qui utilise le prompt courant et l'historique est aussi une forme simple d'orchestration. Mais pour des workflows d'entreprise reproductibles manipulant des données sensibles, une simple orchestration de chat ne suffit souvent pas, et il faut des workflows avancés comme celui présenté ci-dessus.
Quand on évalue des processus complexes d'orchestration d'IA générative en entreprise, s'en tenir aux capacités d'un modèle de fondation (ou affiné) n'est donc souvent qu'un début. La section suivante précise dans quel contexte et quelle orchestration il faut évaluer les applications d'IA générative.
Les sections suivantes présentent les concepts clés de notre approche.
Mon équipe a construit la plateforme entAIngine , assez unique en ce qu'elle permet de générer en low-code des applications d'IA générative qui ne sont pas forcément des chatbots. Nous y avons aussi mis en œuvre l'approche suivante. Si vous voulez l'essayer, écrivez-moi. Ou inspirez-vous du concept ci-dessous pour construire votre propre banc d'essai.
Pour évaluer les performances d'applications d'IA générative dans leurs orchestrations, nous avons plusieurs options : évaluer un modèle de fondation isolément, un modèle affiné, ou l'un des deux au sein d'une orchestration plus large comprenant plusieurs appels à différents modèles et du RAG. Cela a les implications suivantes.
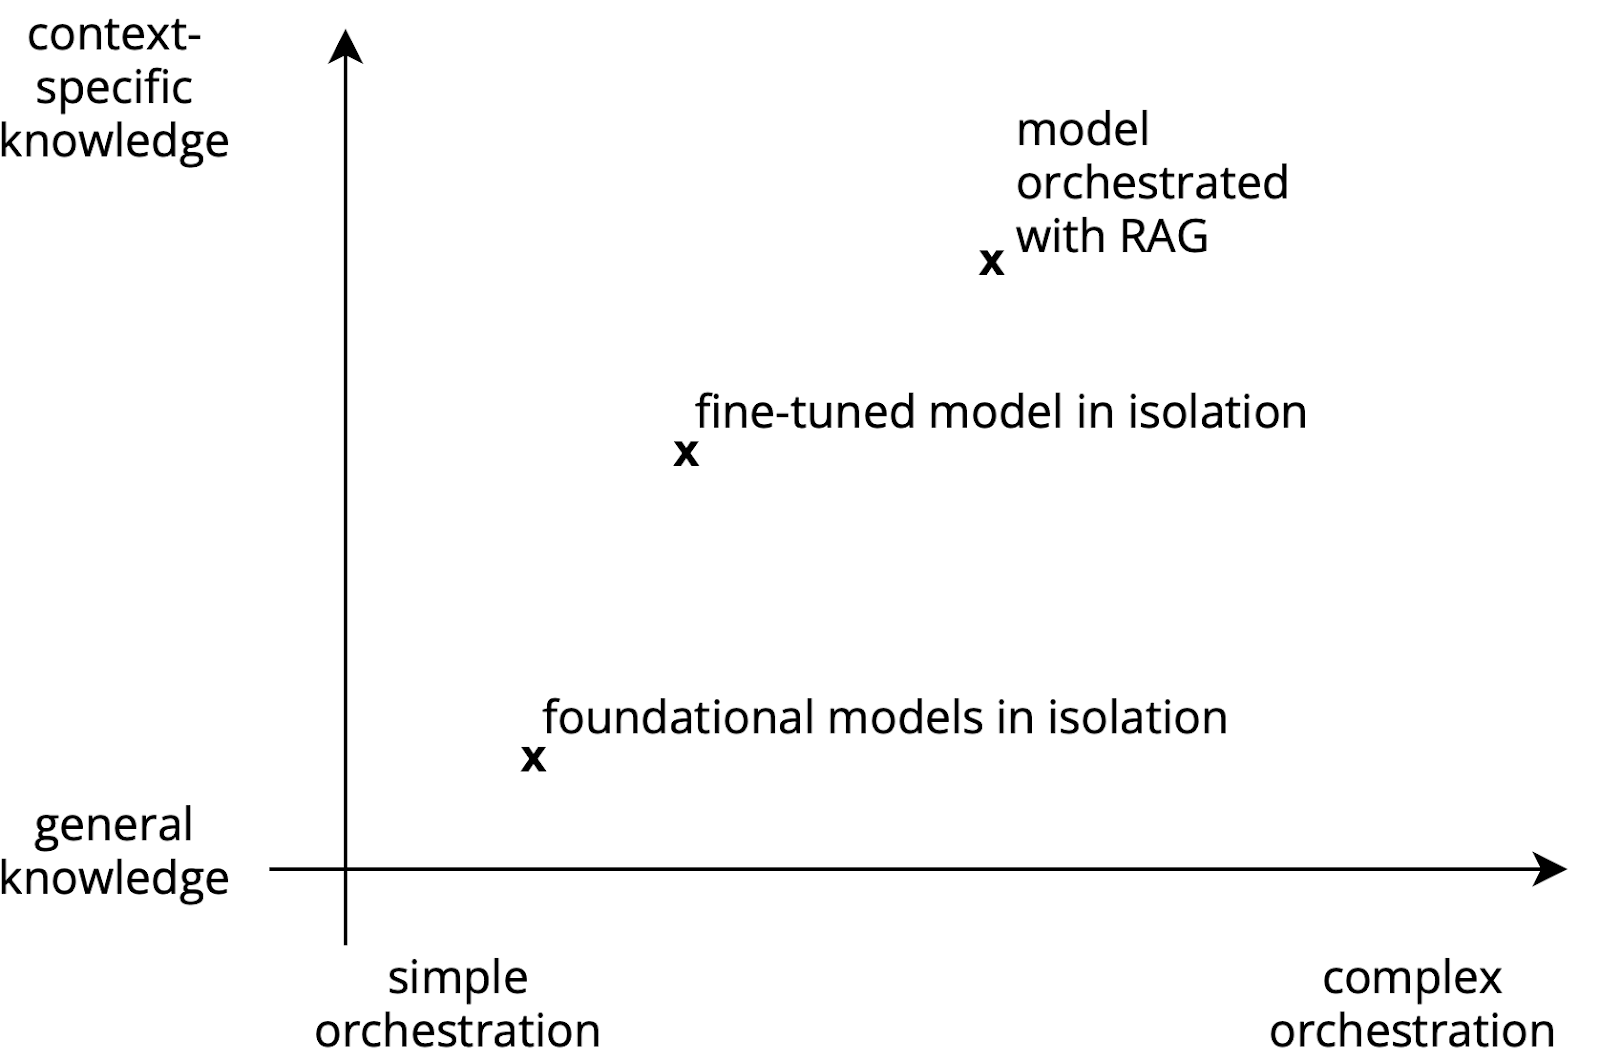
Contexte et orchestration des applications à base de LLM. (c) Marcel Müller, 2025
Les modèles d'IA générative publics comme (pour les LLM) GPT-4o, Llama 3.2 et bien d'autres ont été entraînés sur la « sagesse publique d'Internet ». Leurs données d'entraînement comprennent un vaste corpus de livres, de littérature mondiale, d'articles Wikipédia et d'autres contenus collectés sur des forums et des blogs. Aucun savoir interne d'entreprise n'est encodé dans les modèles de fondation. En évaluant un modèle de fondation, on ne peut donc évaluer que la manière générale dont comment il répond aux requêtes. L'étendue des connaissances propres à l'entreprise, autrement dit « ce que le modèle sait », ne peut pas être jugée. Un modèle de fondation ne dispose de connaissances propres à l'entreprise que via une orchestration avancée qui injecte ce contexte.
Avec un compte ChatGPT gratuit, chacun peut demander : « Comment Goethe est-il mort ? » Le modèle répondra, car les informations clés sur la vie et la mort de Goethe figurent dans sa base de connaissances. En revanche, la question « Quel chiffre d'affaires notre entreprise a-t-elle réalisé au T3 de l'an dernier en EMEA ? » produira très probablement une réponse largement hallucinée, qui semblera plausible à un utilisateur inexpérimenté. On peut néanmoins évaluer la forme et la présentation des réponses, dont le style et le ton, ainsi que les capacités linguistiques, de raisonnement et de déduction logique. Des benchmarks synthétiques comme ARC, HellaSwag et MMLU fournissent des métriques comparatives sur ces dimensions. Nous y reviendrons dans une section ultérieure.
Les modèles affinés s'appuient sur des modèles de fondation. Un entraînement supplémentaire sur de nouveaux jeux de données leur apporte des connaissances qu'ils n'avaient pas. Ils disposent donc de plus de connaissances contextuelles. Si on les orchestre isolément, sans autres données injectées, on peut évaluer leur base de connaissances au regard de scénarios réels d'un processus métier donné. Le fine-tuning sert souvent à apprendre à un modèle de fondation le vocabulaire et les structures de phrases d'un domaine.
Si l'on entraîne un modèle sur un corpus de décisions de justice, le modèle affiné adoptera le vocabulaire et la syntaxe propres au domaine juridique. Il pourra combiner des extraits d'anciennes affaires, mais ne citera pas les bonnes sources.
Orchestrer des modèles de fondation ou affinés avec du Retrieval-Augmented Generation (RAG) produit des résultats très dépendants du contexte, mais exige un pipeline d'orchestration plus complexe.
Un opérateur télécom comme celui de notre exemple peut utiliser un modèle de langage pour créer des embeddings de sa base de connaissances du support et les stocker dans une base vectorielle, interrogeable efficacement par recherche sémantique. En traçant les segments récupérés, on peut indiquer très précisément la source de chaque extrait et l'utiliser comme contexte dans un appel à un grand modèle de langage. On répond ainsi à la question de bout en bout.
Pour de telles orchestrations comprenant plusieurs étapes de traitement, on peut évaluer de bout en bout dans quelle mesure l'application remplit sa fonction.
L'évaluation de ces différentes configurations fournit des enseignements différents, utiles au développement d'applications d'IA générative. Nous approfondissons ce point dans la section suivante.
Nous développons les applications d'IA générative en plusieurs étapes : 1) avant la construction, 2) pendant la construction et les tests, 3) en production. En agile, ces étapes ne s'enchaînent pas de façon linéaire mais itérative. Les objectifs et méthodes d'évaluation de chaque étape restent toutefois les mêmes, quel que soit l'ordre.
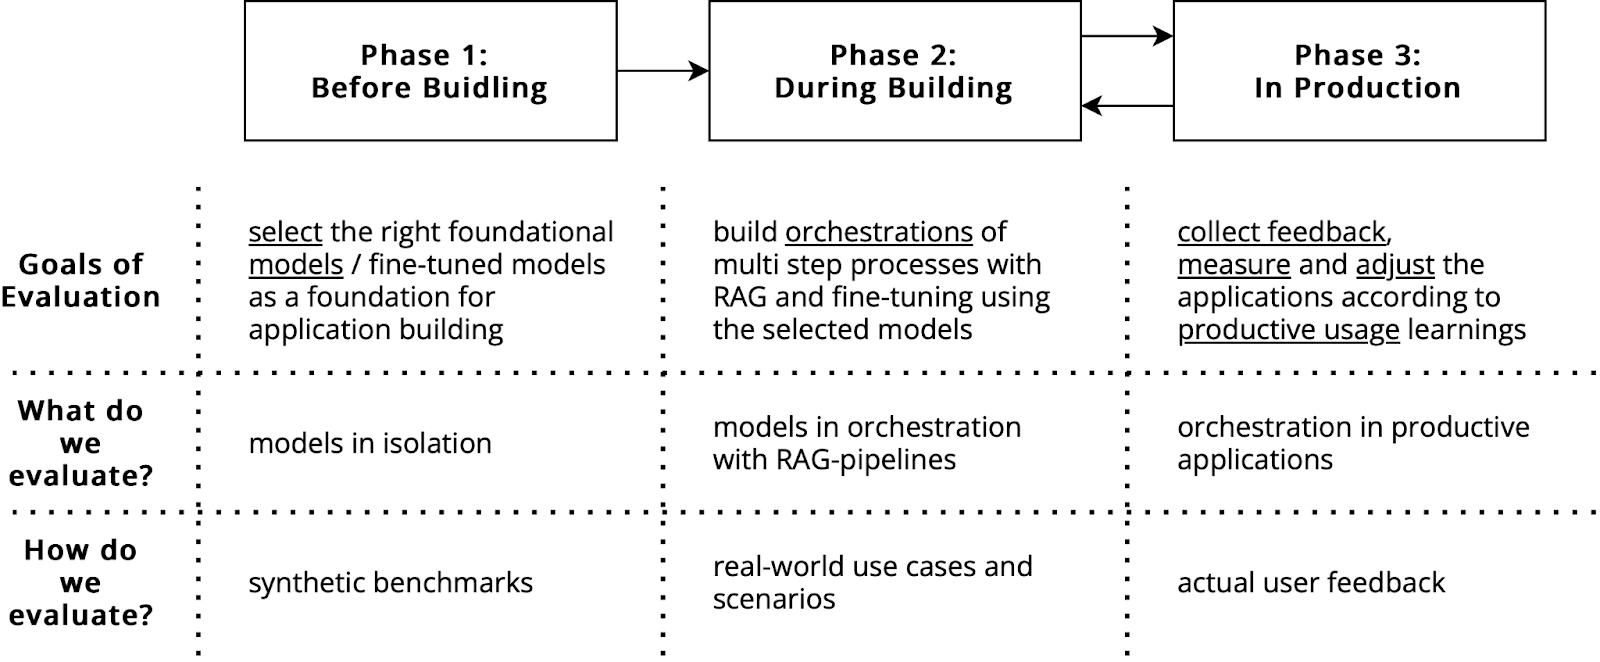
Avant la construction, il faut choisir un modèle de fondation ou décider d'en créer un. On définit d'abord ses attentes et exigences, notamment en matière de temps d'exécution, d'efficacité, de prix et de qualité. Aujourd'hui, très peu d'entreprises construisent leur propre modèle de fondation, en raison des coûts et de l'effort de mise à jour. Le fine-tuning et le Retrieval-Augmented Generation sont les outils standard pour bâtir des pipelines très personnalisés, avec des connaissances internes traçables et des résultats reproductibles. À ce stade, les benchmarks synthétiques sont l'approche de référence pour comparer. Pour une application qui aide des avocats à préparer leurs dossiers, il faut par exemple un modèle doué pour l'argumentation logique et la compréhension d'un langage spécialisé.
Pendant la construction, l'évaluation doit viser à satisfaire les exigences de qualité et de performance sur les cas d'exemple de l'application. Pour une application destinée à des avocats, on sélectionne un nombre limité d'anciennes affaires représentatives. Ces affaires servent de base pour définir les scénarios standard de l'application, à partir desquels on la réalise. Si l'avocat est spécialisé en droit financier et fiscal, on choisit quelques cas types pour lesquels il doit créer des scénarios. Chaque activité de construction et d'évaluation de cette phase a une vision limitée à des scénarios représentatifs et ne couvre pas tous les cas. Il faut néanmoins évaluer ces scénarios tout au long du développement.
En production, l'évaluation porte sur la mesure quantitative de l'usage réel de l'application au regard des attentes des utilisateurs. En production, on découvre des scénarios non couverts pendant la construction. Le but de l'évaluation est alors de les identifier et de recueillir les retours des utilisateurs pour continuer à améliorer l'application.
La production doit toujours alimenter le développement pour améliorer l'application de façon itérative. Les trois phases ne se suivent donc pas linéairement : elles s'entremêlent.
Le « quoi » et le « quand » étant posés, reste le « comment ». Nous disposons de trois méthodes : les benchmarks synthétiques, les scénarios limités et l'évaluation par boucle de retour en production.
Pour les benchmarks synthétiques, nous examinons et comparons les approches les plus courantes.
L' AI2 Reasoning Challenge (ARC) teste les connaissances et le raisonnement d'un LLM à l'aide de 7787 questions scientifiques à choix multiples, du niveau CE2 à la quatrième, réparties en un jeu Easy et un jeu Challenge. ARC permet d'évaluer différents types de connaissances et pousse les modèles à combiner des informations issues de plusieurs phrases. Son principal atout est une évaluation complète du raisonnement, mais il se limite aux questions scientifiques.
HellaSwag teste le raisonnement de sens commun et l'inférence en langage naturel par des exercices de complétion de phrases tirés de situations réelles. Chaque exercice comprend un contexte issu d'une légende vidéo et quatre fins possibles. Ce benchmark mesure la compréhension des situations du quotidien par un LLM. Son principal atout est la difficulté ajoutée par le filtrage adversarial, mais il porte surtout sur la culture générale, ce qui limite les tests dans des domaines spécialisés.
Le benchmark MMLU (Massive Multitask Language Understanding) mesure la compréhension du langage d'un LLM sur 57 tâches couvrant des domaines variés, des sciences aux lettres. Il comprend 15 908 questions du niveau élémentaire au niveau avancé. MMLU est idéal pour une évaluation complète des connaissances. Sa large couverture aide à repérer les lacunes, mais le manque de détails sur sa construction et certaines erreurs peuvent nuire à sa fiabilité.
TruthfulQA évalue la capacité d'un LLM à fournir des réponses véridiques, en s'attaquant aux hallucinations des modèles de langage. Il mesure la précision des réponses, surtout lorsque les données d'entraînement sont insuffisantes ou de faible qualité. Ce benchmark est utile pour évaluer exactitude et véracité, avec l'avantage de se concentrer sur des réponses factuellement correctes. Son jeu de données de culture générale peut toutefois mal refléter la véracité dans des domaines spécialisés.
L' framework RAGAS sert à évaluer les pipelines de Retrieval Augmented Generation (RAG). Il est particulièrement utile pour les applications LLM qui exploitent des données externes pour enrichir le contexte du LLM. Il introduit des métriques de fidélité, de pertinence des réponses, de rappel, de précision et de pertinence du contexte, de rappel des entités et de score de synthèse, qui permettent d'évaluer finement la qualité des résultats récupérés.
WinoGrande teste le raisonnement de sens commun d'un LLM à travers des problèmes de résolution de pronoms inspirés du Winograd Schema Challenge. Il présente des phrases presque identiques dont la réponse change selon un mot déclencheur. Ce benchmark aide à lever les ambiguïtés de référence des pronoms, avec un grand jeu de données et un biais réduit. Les artefacts d'annotation restent toutefois une limite.
L' GSM8K benchmark mesure le raisonnement mathématique en plusieurs étapes d'un LLM à l'aide d'environ 8 500 problèmes de niveau primaire. Chaque problème demande plusieurs étapes d'arithmétique de base. Ce benchmark met en évidence les faiblesses en raisonnement mathématique grâce à des formulations variées. La simplicité des problèmes peut toutefois limiter sa pertinence à long terme.
SuperGLUE enrichit le benchmark GLUE en testant les capacités de compréhension du langage (NLU) d'un LLM sur huit sous-tâches variées, dont Boolean Questions et le Winograd Schema Challenge. Il offre une évaluation approfondie des connaissances linguistiques et du sens commun. SuperGLUE est idéal pour une évaluation NLU large, avec des tâches complètes et des résultats détaillés. Moins de modèles y sont toutefois testés que sur des benchmarks comme MMLU.
HumanEval mesure la capacité d'un LLM à générer du code fonctionnellement correct à travers des exercices de programmation et des tests unitaires. Il comprend 164 problèmes avec plusieurs tests unitaires chacun. Ce benchmark évalue les compétences en programmation et en résolution de problèmes, en se concentrant sur l'exactitude fonctionnelle, à la manière d'une évaluation humaine. Il ne couvre toutefois qu'une partie des tâches pratiques, ce qui limite sa portée.
MT-Bench évalue les capacités d'un LLM dans des dialogues à plusieurs tours en simulant des conversations réelles. Il mesure l'efficacité des chatbots à mener une conversation selon un déroulement naturel. Grâce à un jeu de données soigneusement constitué, MT-Bench est utile pour évaluer les capacités conversationnelles. Son jeu de données restreint et la difficulté de simuler de vraies conversations restent toutefois à améliorer.
Toutes ces métriques sont synthétiques et visent à comparer différents LLM entre eux. Leur impact concret pour un cas d'usage en entreprise dépend toutefois de la correspondance entre le défi du scénario et le benchmark. Par exemple, pour des cas d'usage en comptabilité fiscale nécessitant beaucoup de calculs, GSM8K serait un bon candidat pour évaluer cette capacité. HumanEval est l'outil de premier choix pour un LLM utilisé dans un contexte de programmation.
L'impact de ces benchmarks reste toutefois assez abstrait et ne donne qu'une indication de leurs performances dans un cas d'usage en entreprise. C'est là que le travail avec des scénarios réels devient nécessaire.
Les scénarios réels se composent des éléments suivants :
des données de contexte spécifiques au cas (entrée),
des données de contexte indépendantes du cas,
une séquence de tâches à accomplir et
la sortie attendue.
Avec des scénarios de test réels, nous pouvons modéliser différentes situations, comme
des échanges de chat en plusieurs étapes avec plusieurs questions et réponses,
des tâches d'automatisation complexes avec plusieurs interactions IA,
des processus impliquant du RAG et
des interactions de processus multimodales.
Autrement dit, avoir le meilleur modèle du monde ne sert à rien si le pipeline RAG renvoie toujours des résultats médiocres à cause d'une mauvaise stratégie de découpage. De même, sans les bonnes données pour répondre aux requêtes, vous obtiendrez toujours des hallucinations plus ou moins proches de la vérité. Les résultats varient aussi selon les hyperparamètres des modèles choisis (température, pénalité de fréquence, etc.). Et nous ne pouvons pas utiliser le modèle le plus puissant pour chaque cas d'usage s'il est coûteux.
Les benchmarks standards se concentrent sur les modèles individuels plutôt que sur la vue d'ensemble. C'est pourquoi nous présentons le framework PEEL d'évaluation des performances des applications LLM d'entreprise, qui offre une vue de bout en bout.
Le concept central de PEEL est le scénario d'évaluation. Nous distinguons la scénario d'évaluation définition et l' scénario d'évaluation exécution. L'illustration conceptuelle montre les concepts généraux en noir, un exemple de définition en bleu et le résultat d'une exécution en vert.
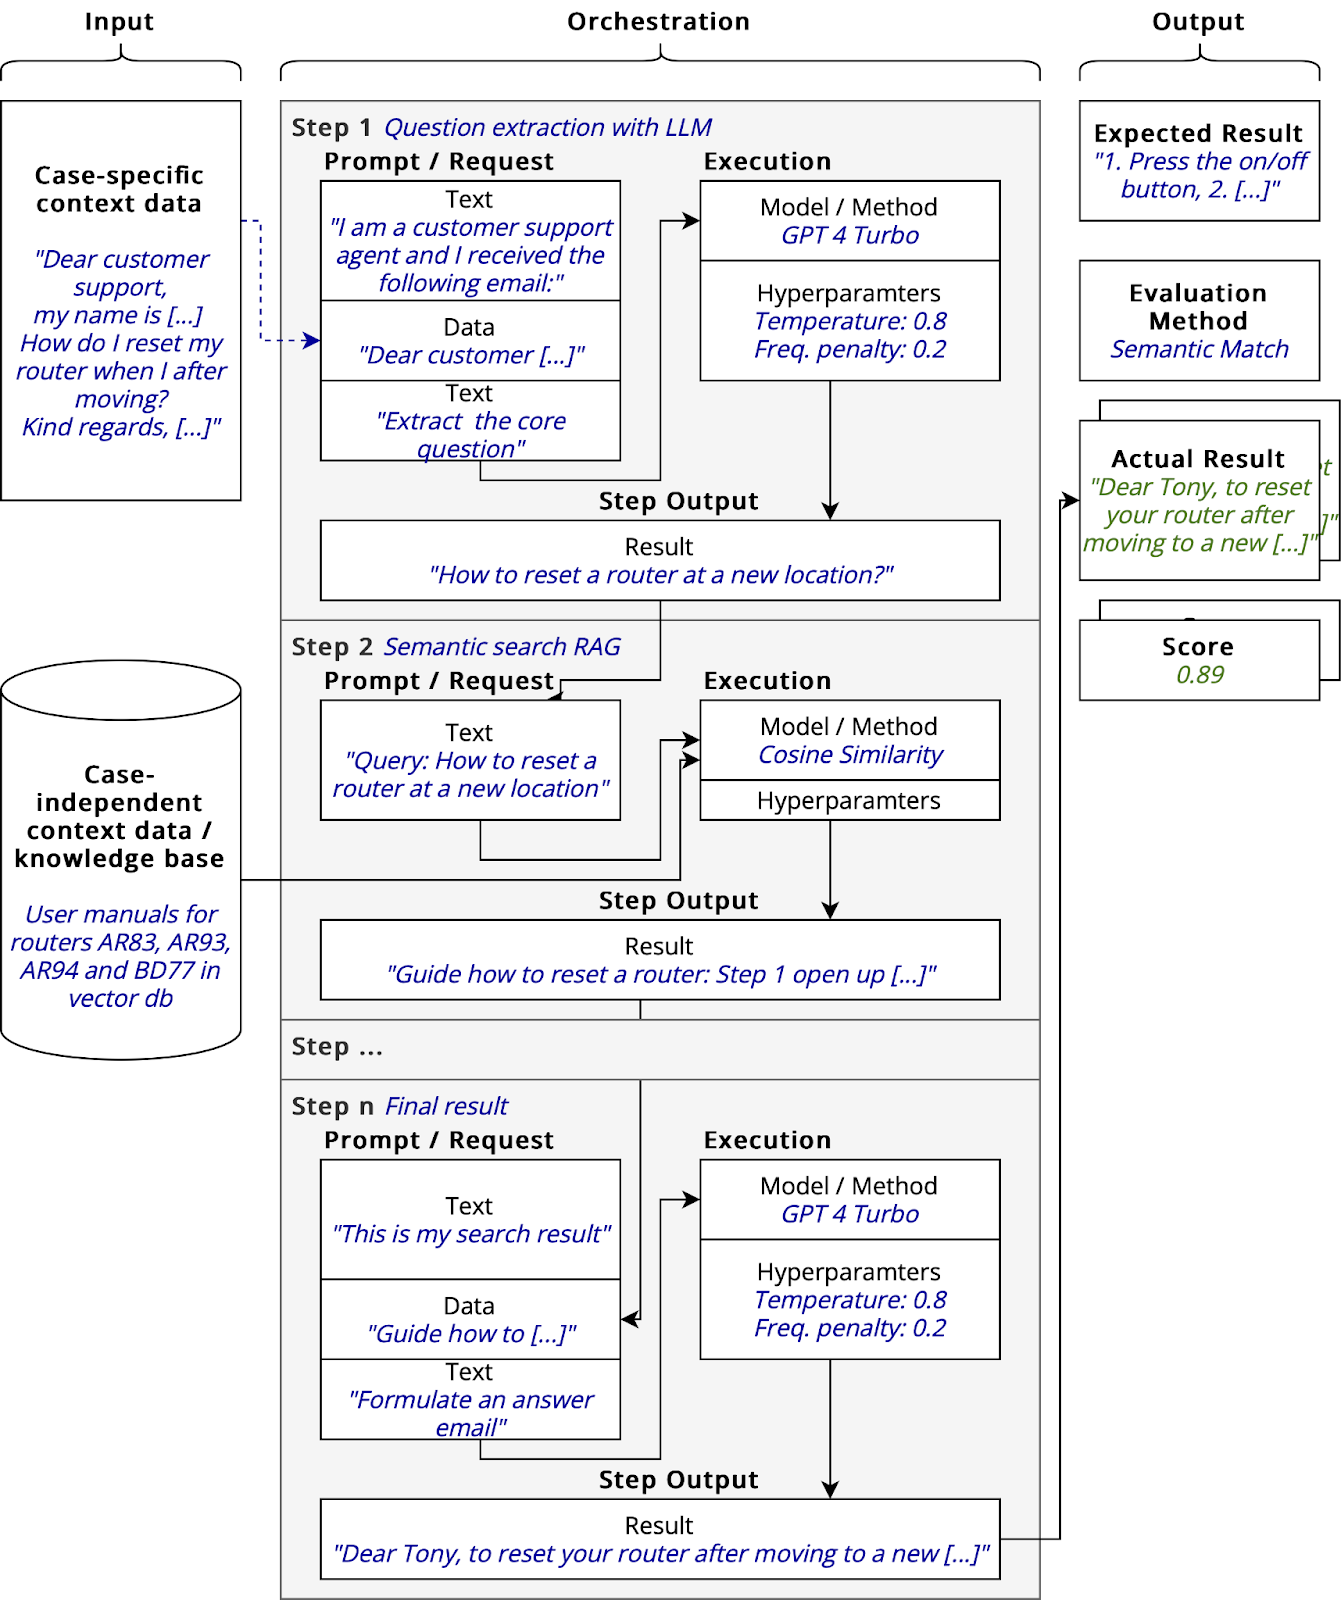
Le concept de scénarios d'évaluation du framework PEEL © Marcel Müller
Une définition de scénario d'évaluation se compose de définitions d'entrée, une définition d'orchestration et une définition de sortie attendue.
Pour l'entrée, nous distinguons les données de contexte spécifiques au cas et celles indépendantes du cas. Les données spécifiques changent d'un cas à l'autre. Dans le support client, par exemple, la question posée diffère pour chaque client. Dans notre exemple d'exécution, nous avons représenté un cas où la demande par e-mail est la suivante :
"Cher service client,
je m'appelle [...]. Comment réinitialiser mon routeur lorsque je déménage dans un autre appartement ?
Cordialement, [...] "
La base de connaissances, où les réponses se trouvent dans de longs documents, est en revanche indépendante du cas. Dans notre exemple, elle contient les manuels PDF des routeurs AR83, AR93, AR94 et BD77, stockés dans une base vectorielle.
Une définition de scénario d'évaluation possède une orchestration. Une orchestration se compose d'une série de n >= 1 étapes exécutées successivement lors de l'exécution du scénario. Chaque étape reçoit des entrées provenant des étapes précédentes ou de l'entrée de l'exécution du scénario. Les étapes peuvent être des interactions avec des LLM (ou d'autres modèles), des tâches de récupération de contexte (par exemple depuis une base vectorielle) ou d'autres appels à des sources de données. Pour chaque étape, nous distinguons le prompt / la requête et les paramètres d'exécution. Les paramètres d'exécution comprennent le modèle ou la méthode à exécuter ainsi que les hyperparamètres. Le prompt / la requête est un ensemble de données statiques ou dynamiques qui sont concaténées (voir l'illustration).
Dans notre exemple, l'orchestration comporte trois étapes. À l'étape 1, nous extrayons une question unique du contexte d'entrée spécifique au cas (la demande du client par e-mail). À l'étape 2, nous utilisons cette question pour une recherche sémantique dans notre base vectorielle avec la similarité cosinus. La dernière étape prend les résultats et rédige un e-mail à l'aide d'un LLM.
Une définition de scénario d'évaluation comprend une sortie attendue et une méthode d'évaluation. Nous définissons ici, pour chaque scénario, comment comparer le résultat réel au résultat attendu. Les options sont les suivantes :
Correspondance exacte/regex : nous vérifions la présence d'une série précise de termes/concepts et renvoyons un booléen, où 0 signifie que les termes définis n'apparaissent pas dans la sortie et 1 qu'ils apparaissent. Par exemple, l'idée centrale pour installer un routeur dans un nouveau lieu est d'appuyer 3 secondes sur le bouton de réinitialisation. Si les termes "bouton de réinitialisation" et "3 secondes" ne figurent pas dans la réponse, nous la considérons comme un échec.
Correspondance sémantique : nous vérifions si le texte est sémantiquement proche de la réponse attendue. Pour cela, un LLM évalue par un nombre entre 0 et 1 dans quelle mesure la réponse correspond à celle attendue.
Évaluation manuelle : des humains notent la sortie sur une échelle de 0 à 1.
Un scénario d'évaluation doit être exécuté de nombreuses fois, car les LLM sont des modèles non déterministes. Nous voulons un nombre raisonnable d'exécutions afin d'agréger les scores et d'obtenir un résultat statistiquement significatif .
L'avantage de ces scénarios est de pouvoir les utiliser pendant la construction et le débogage des orchestrations. Si 80 exécutions sur 100 du même prompt obtiennent un score inférieur à 0,3, nous nous en servons pour ajuster nos prompts ou ajouter d'autres données au fine-tuning avant l'orchestration.
La collecte de feedback en production suit le même principe que l'approche par scénarios. Nous associons chaque interaction utilisateur à un scénario. Si l'utilisateur dispose de plus de liberté, il peut être nécessaire de créer de nouveaux scénarios non prévus lors de la construction.
L'utilisateur dispose d'un curseur entre 0 et 1 pour indiquer sa satisfaction vis-à-vis d'un résultat. Du point de vue de l'expérience utilisateur, ce chiffre peut être simplifié, par exemple avec un smiley souriant, neutre ou triste. Cette évaluation correspond donc à l'évaluation manuelle présentée plus haut.
En production, nous créons les mêmes agrégations et métriques qu'auparavant, mais avec de vrais utilisateurs et potentiellement beaucoup plus de données.
Avec l'équipe entAIngine , nous avons implémenté cette fonctionnalité sur la plateforme. Cette section montre comment procéder et vise à vous inspirer. Et si vous souhaitez utiliser ce que nous avons développé, n'hésitez pas.
Nous transposons nos concepts de scénarios d'évaluation et de leurs définitions aux concepts classiques du test logiciel. Le point de départ pour créer un nouveau test est le tableau de bord des applications entAIngine.
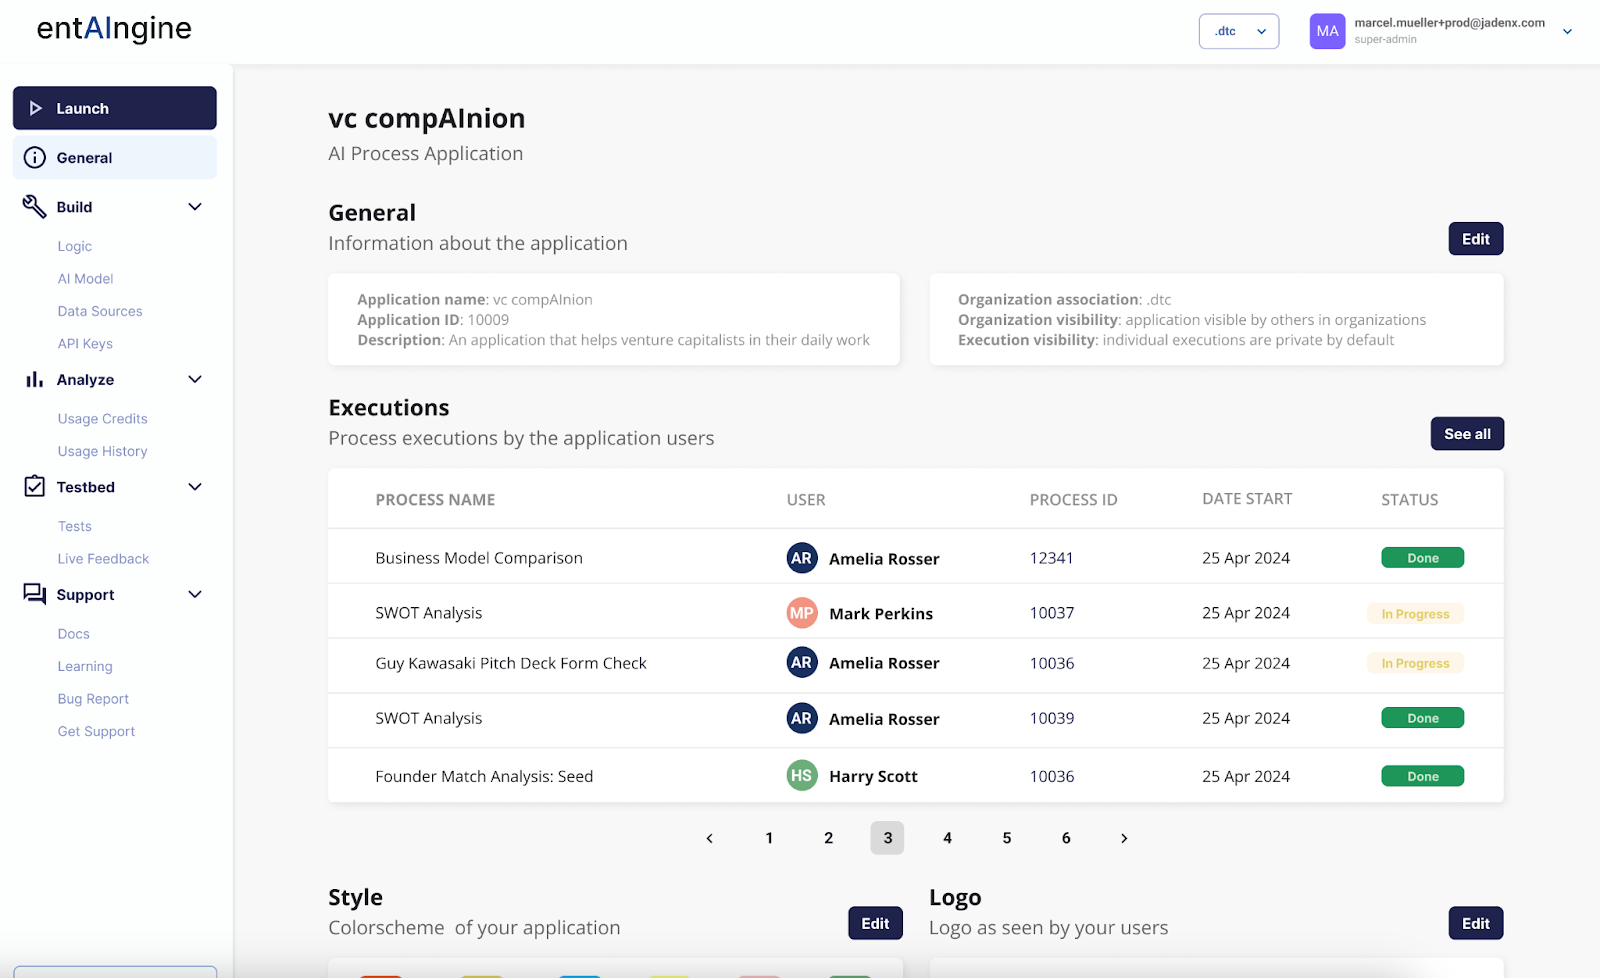
Tableau de bord entAIngine © Marcel Müller
Dans entAIngine, les utilisateurs peuvent créer de nombreuses applications. Chaque application est un ensemble de processus qui définissent des workflows dans une interface no-code. Les processus se composent de modèles d'entrée (variables), de composants RAG, d'appels à des LLM, de modules TTS, image et audio, d'intégrations de documents et d'OCR. Avec ces composants, nous construisons des processus réutilisables, intégrables via une API, utilisables comme flux de chat, comme bloc de texte dynamique dans un éditeur ou dans une interface de recherche documentaire qui affiche les sources des réponses. Cette fonctionnalité est déjà entièrement implémentée dans la plateforme entAIngine et peut être utilisée en SaaS ou déployée à 100 % sur site. Elle s'intègre aux passerelles, sources de données et modèles existants via API. Nous utilisons le générateur de modèles de processus pour les définitions de scénarios d'évaluation.
Pour créer un nouveau test, l'utilisateur va dans "test bed" puis "tests".
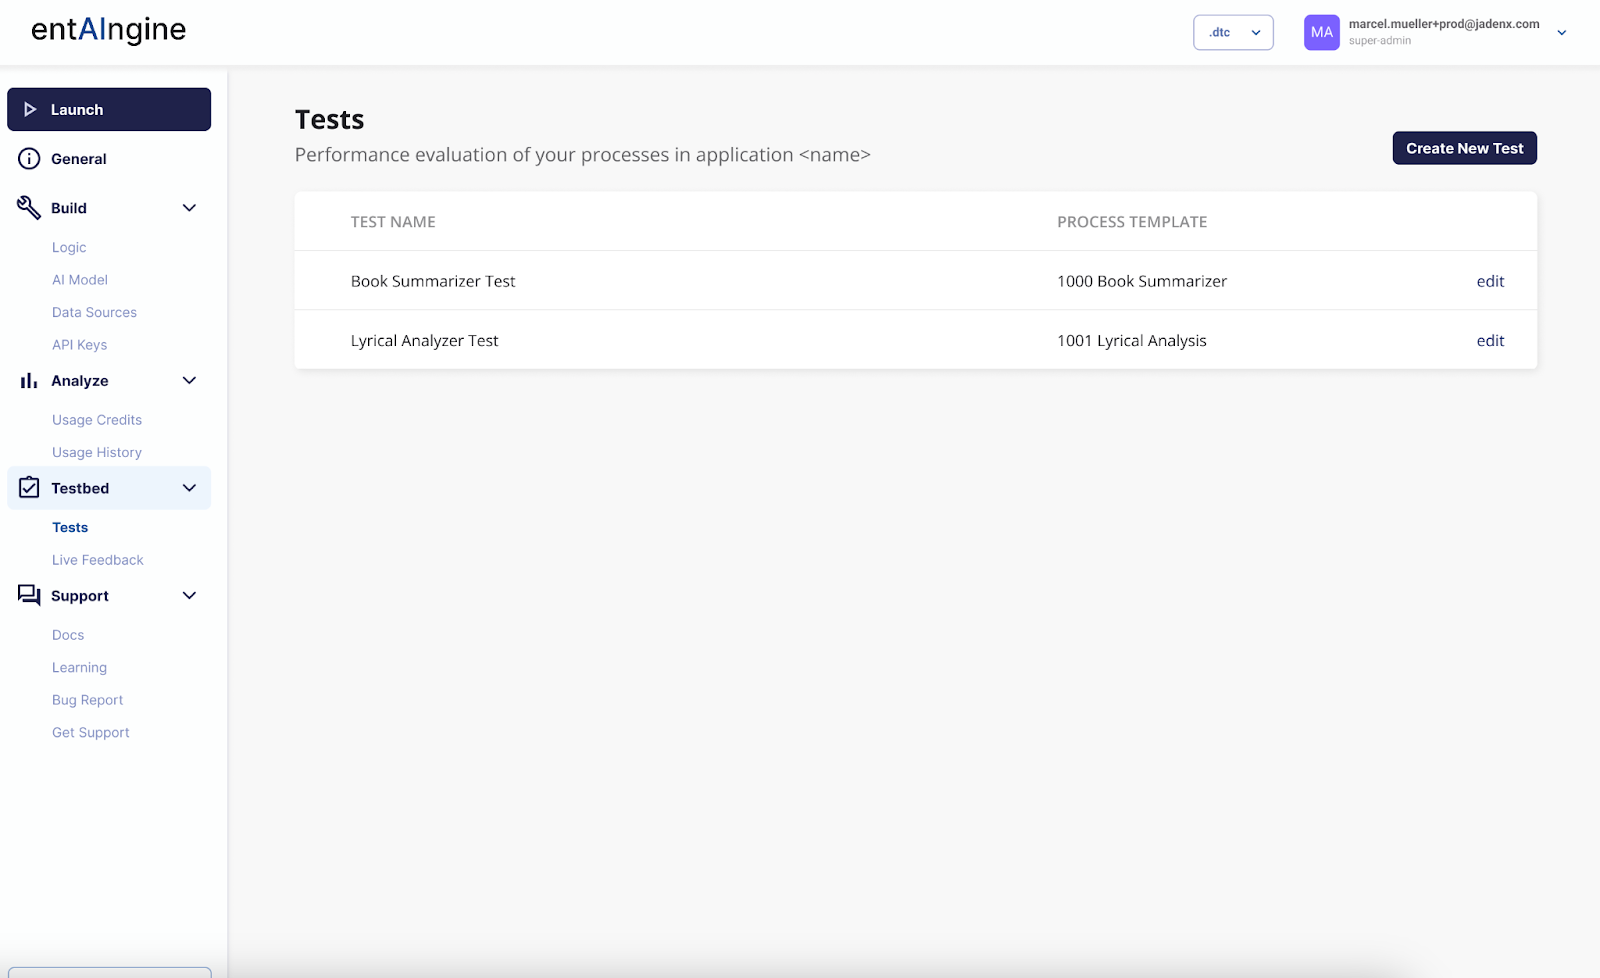
Sur l'écran des tests, l'utilisateur peut créer de nouveaux scénarios d'évaluation ou modifier les existants. Lors de la création, il faut définir l'orchestration (un modèle de processus entAIngine) et un ensemble de métriques. Prenons un scénario de support client où l'on récupère d'abord des données via RAG pour répondre à une question, puis où l'on rédige un e-mail de réponse. Avec le nouveau module, nous nommons le test, définissons ou sélectionnons un modèle de processus et choisissons un évaluateur qui calcule un score pour chaque cas de test.
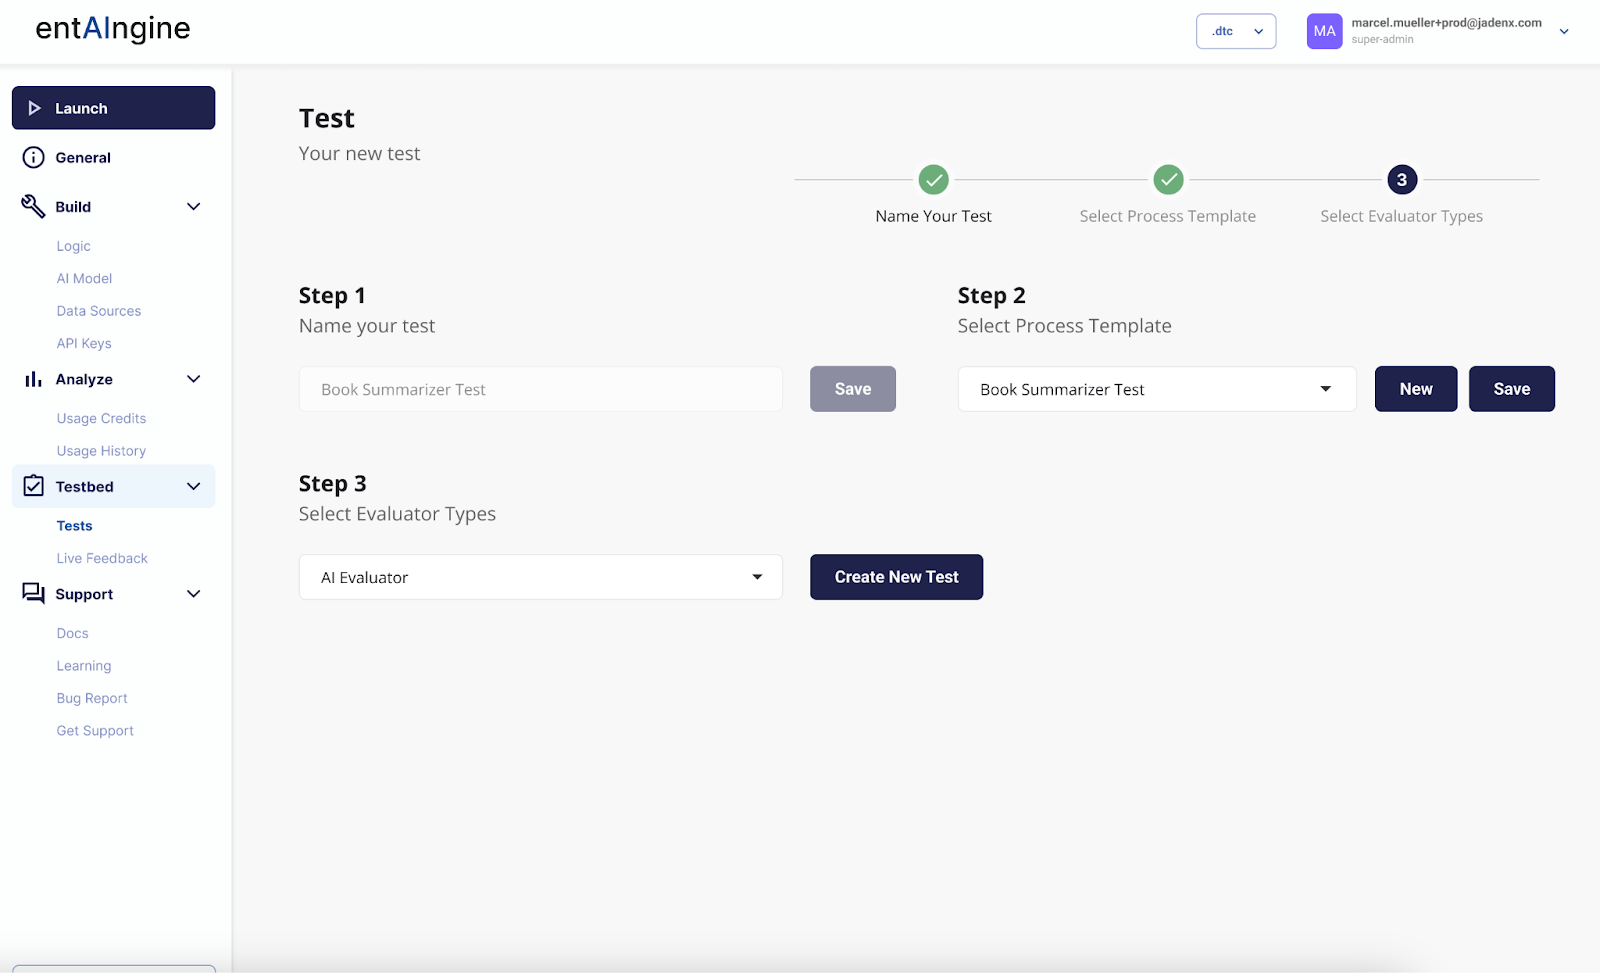
Définition du test © Marcel Müller, 2025
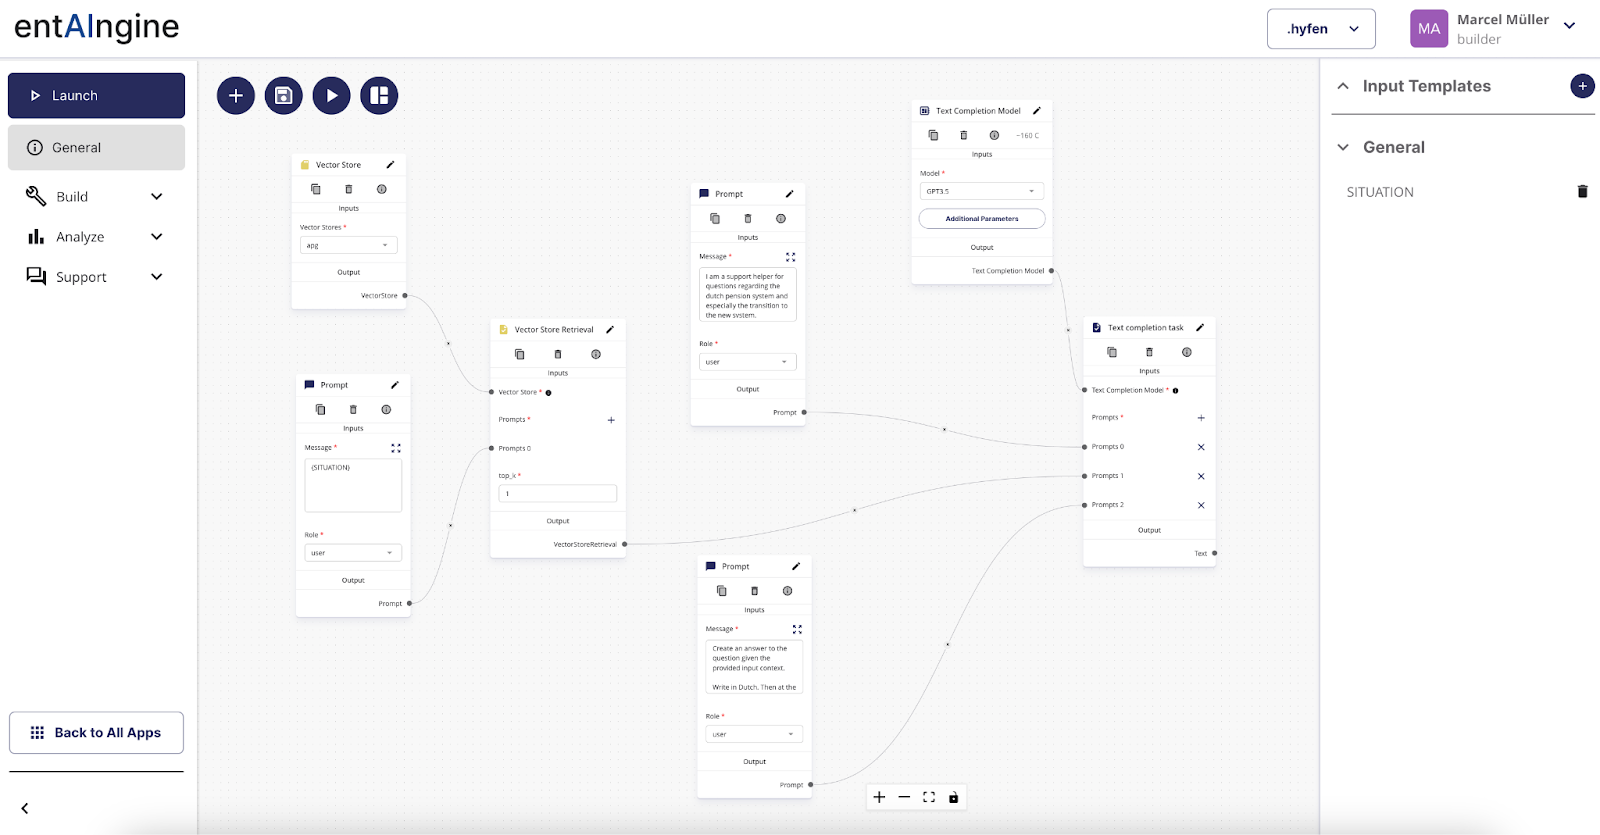
Définition d'un cas de test (modèle de processus) © Marcel Müller, 2025
Les métriques sont celles définies plus haut : correspondance regex, correspondance sémantique et évaluation manuelle. L'écran de définition des processus existe déjà et fonctionne avec l'orchestration. La possibilité de définir des tests en lot, présentée ci-dessous, est nouvelle.
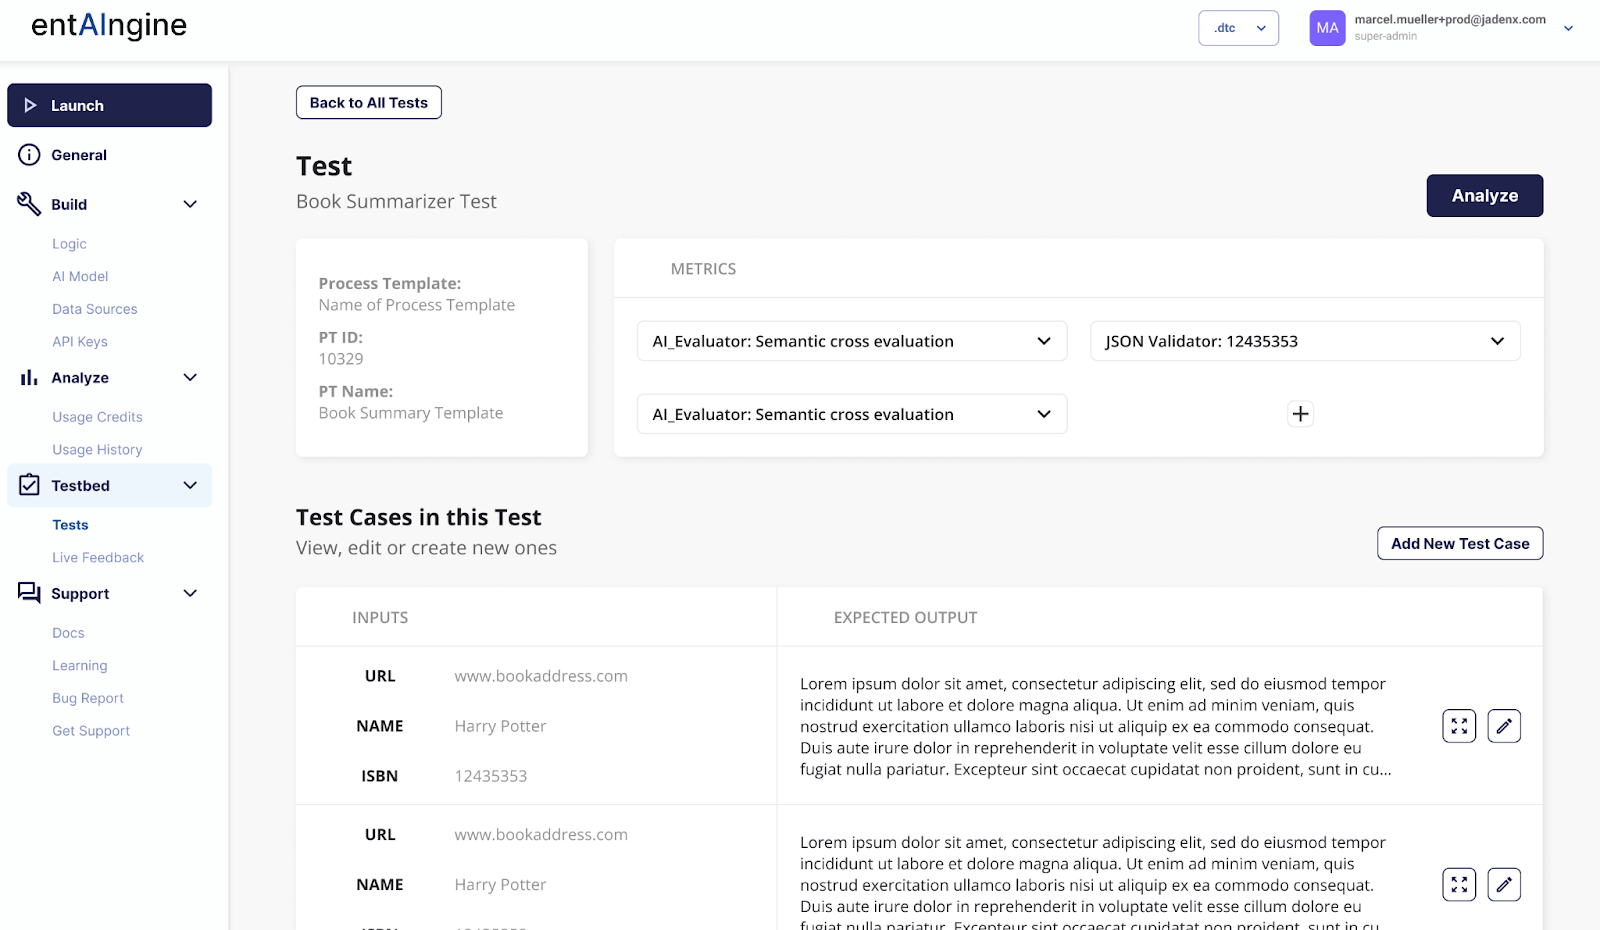
Tests et cas de test © Marcel Müller, 2025
Dans l'éditeur de tests, nous travaillons sur une définition de scénario d'évaluation ("évaluer la qualité de notre RAG de réponse au support client") et y définissons différents cas de test. Un cas de test attribue des valeurs aux variables du test. Nous pouvons essayer 50 ou 100 cas de test, les évaluer et les agréger. Par exemple, pour évaluer nos réponses au support client, nous définissons 100 demandes différentes avec le résultat attendu, les exécutons et analysons la qualité des réponses. Une fois l'ensemble de cas de test conçu, nous exécutons leurs scénarios avec les bonnes variables via le moteur d'orchestration existant et les évaluons.
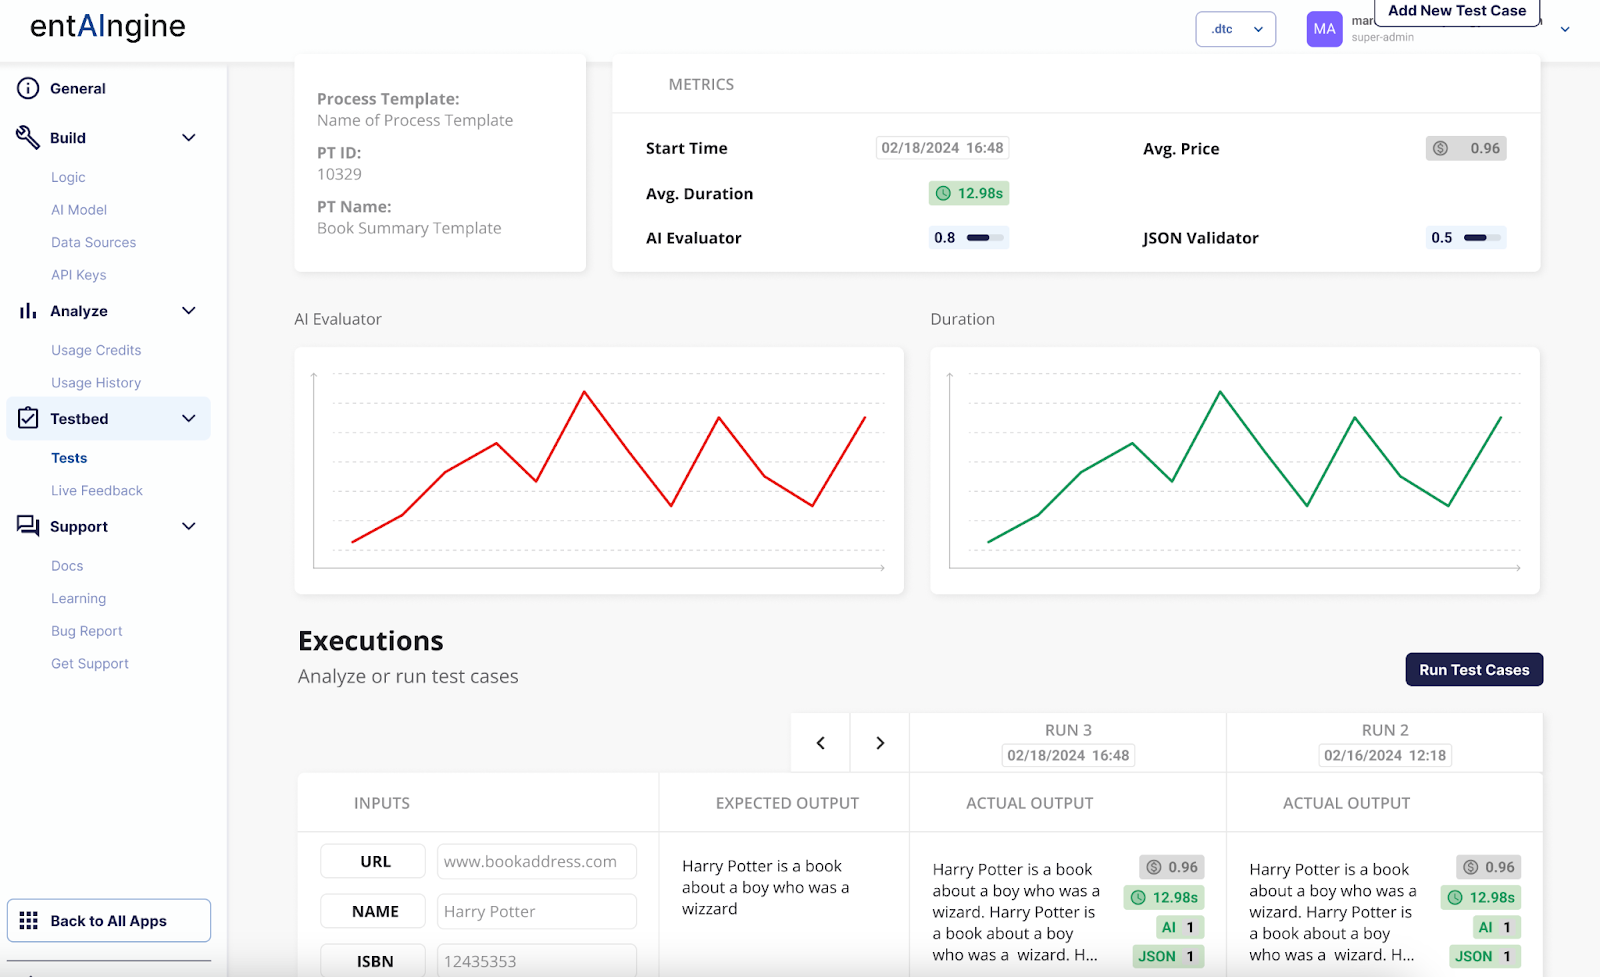
Métriques et évaluation © Marcel Müller, 2025
Ces tests ont lieu pendant la phase de construction. Un écran supplémentaire sert à évaluer le feedback réel des utilisateurs en production. Les contenus proviennent de ce feedback (via notre moteur et notre API).
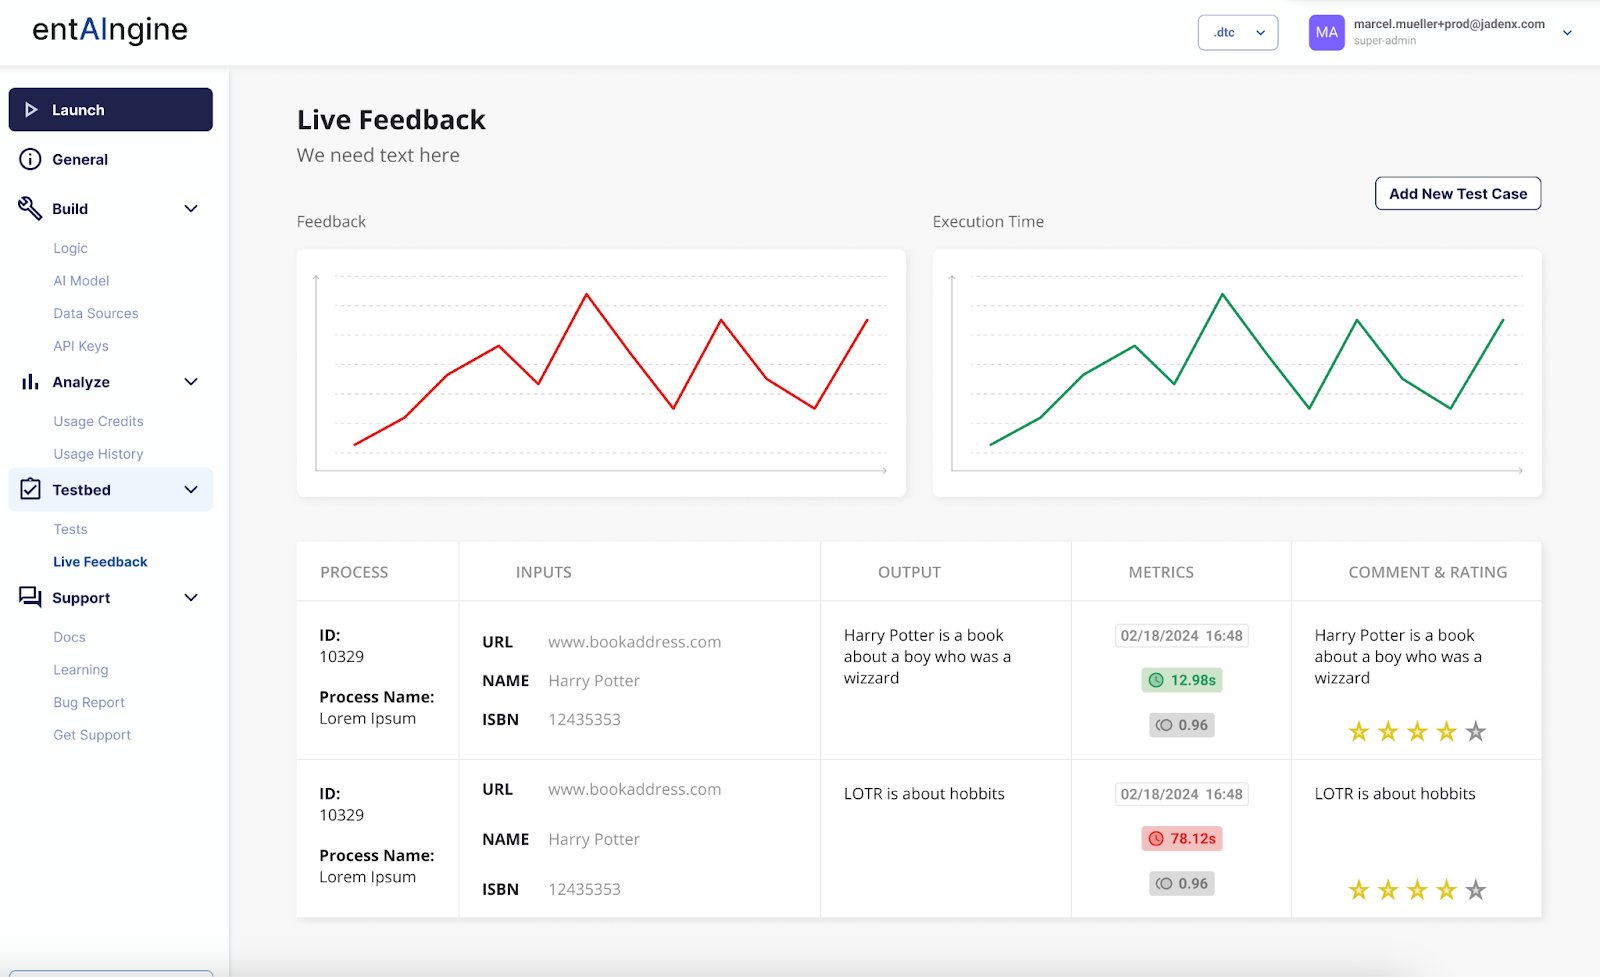
Les métriques de la section feedback en direct sont recueillies auprès des utilisateurs via une notation par étoiles.
Dans cet article, nous avons examiné des concepts avancés de test et d'ingénierie qualité pour les applications d'IA générative, en particulier celles plus complexes que de simples chatbots. Le framework PEEL présenté est une nouvelle approche de test par scénarios, plus proche de l'implémentation que les benchmarks génériques utilisés pour tester les modèles. Pour de bonnes applications, il est important de tester le modèle non seulement isolément, mais aussi dans son orchestration.
Je travaille au quotidien sur des applications concrètes d'IA générative, en particulier en entreprise. Si vous souhaitez échanger, ajoutez-moi ou envoyez-moi un message sur LinkedIn.