Warum die Qualität von Generative-AI-Apps oft mies ist und was Sie dagegen tun können
12. November 2025
Der Generative-AI-Hype ist in den letzten zwei Jahren durch die Geschäftswelt gerollt. Die Technologie kann Geschäftsprozesse effizienter machen, Wartezeiten verkürzen und Prozessfehler verringern. Oberflächen wie ChatGPT machen die Interaktion mit einem LLM einfach und zugänglich. Wer schon einmal eine Chat-App genutzt hat, tippt mühelos eine Anfrage ein, und ChatGPT erzeugt immer a eine Antwort. Doch die Qualität und Eignung für den vorgesehenen Zweck Ihrer generierten Inhalte kann schwanken. Das gilt besonders für Unternehmen , die Generative AI in ihrem operativen Geschäft einsetzen wollen.
Ich habe mit unzähligen Managern und Unternehmern gesprochen, die gescheitert sind, weil sie keine hochwertigen Generative-AI-Anwendungen in Produktion bringen und aus einem nichtdeterministischen Modell keine wiederverwendbaren Ergebnisse gewinnen konnten. Gleichzeitig habe ich mehr als drei Dutzend KI-Anwendungen gebaut und dabei ein verbreitetes Missverständnis über die Qualität von Generative-AI-Anwendungen erkannt: Man glaubt, alles hänge davon ab, wie leistungsfähig das zugrunde liegende Modell ist. Das ist aber nur 30 % der ganzen Geschichte.
Es gibt Dutzende Techniken, Muster und Architekturen, mit denen sich wirksame LLM-basierte Anwendungen in der Qualität bauen lassen, die Unternehmen erwarten. Verschiedene Foundation Models, feinabgestimmte Modelle, Architekturen mit Retrieval-Augmented Generation (RAG) und fortgeschrittene Verarbeitungspipelines sind nur die Spitze des Eisbergs.
Dieser Artikel zeigt, wie wir Generative-AI-Anwendungen qualitativ und quantitativ bewerten können, und zwar im Kontext konkreter Geschäftsprozesse. Wir bleiben nicht bei generischen Benchmarks stehen, sondern stellen Ansätze zur Bewertung von Anwendungen mit Generative AI vor. Nach einer kurzen Analyse von Generative-AI-Anwendungen und ihren Geschäftsprozessen betrachten wir diese Fragen:
Dieser Überblick ergibt ein durchgängiges Bewertungsframework für Generative-AI-Anwendungen in Unternehmensszenarien, das ich PEEL nenne (performance evaluation for enterprise LLM applications). Auf Basis dieses Konzeptrahmens stellen wir ein Umsetzungskonzept als Erweiterung des Moduls entAIngine Test Bed der Plattform entAIngine vor.
Eine Organisation lebt von ihren Geschäftsprozessen. Alles in einem Unternehmen kann ein Geschäftsprozess sein, etwa Kundensupport, Softwareentwicklung oder Betriebsprozesse. Generative AI kann diese Prozesse schneller und effizienter machen, Wartezeiten verkürzen und die Ergebnisqualität verbessern. Jede Prozessaktivität, die Generative AI nutzt, lässt sich jedoch noch weiter zerlegen.
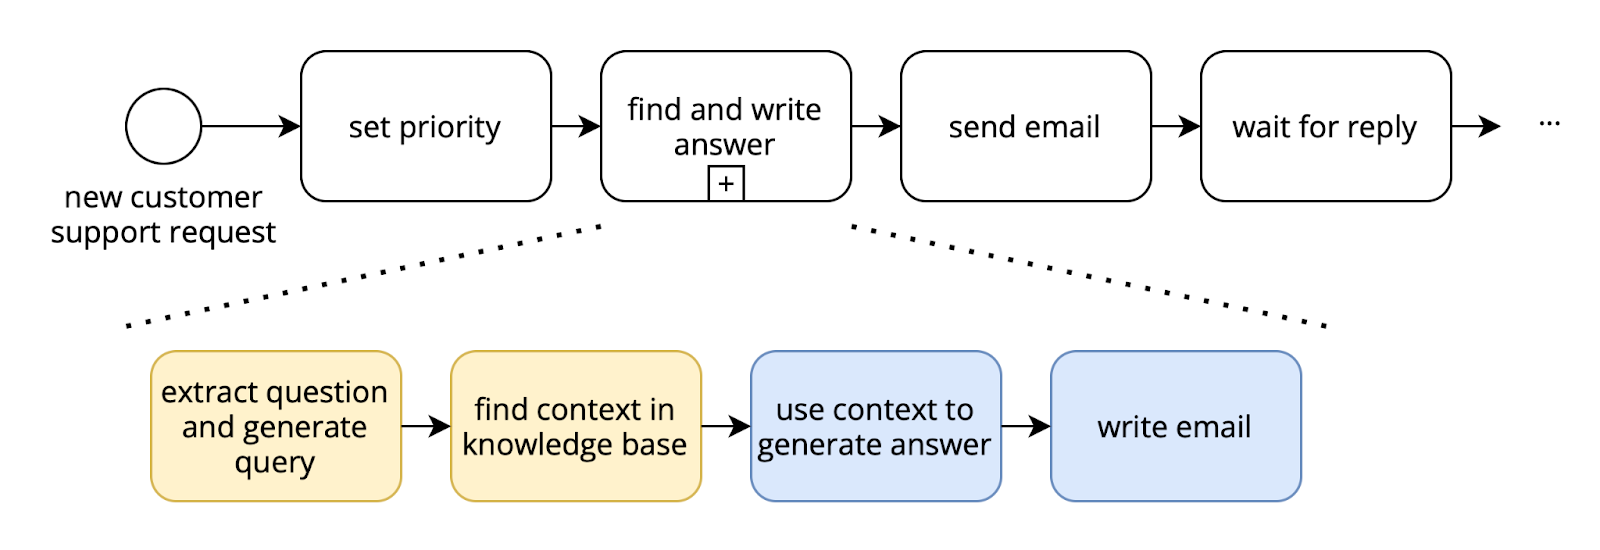
Prozesse für Generative-AI-Anwendungen. (c) 2025, Marcel Müller
Die Abbildung zeigt den Beginn eines einfachen Prozesses, den ein Supportmitarbeiter eines Telekommunikationsunternehmens durchläuft. Bei jeder neuen Supportanfrage muss er eine Priorität vergeben. Ist die Anfrage auf seiner Liste an der Reihe, muss er die richtige Antwort finden und eine Antwort-E-Mail schreiben. Danach schickt er die E-Mail an den Kunden, wartet auf eine Rückmeldung und wiederholt das, bis die Anfrage gelöst ist.
Mit einem Generative-AI-Workflow lässt sich die Aktivität „Antwort finden und schreiben“ effizienter machen. Diese Aktivität ist aber oft kein einzelner Aufruf von ChatGPT oder einem anderen LLM, sondern eine Sammlung verschiedener Aufgaben. In unserem Beispiel hat das Telekommunikationsunternehmen mit der Prozessplattform entAIngine eine Pipeline aus diesen Schritten gebaut.
Die Ausführung solcher Prozesse nennt man die Orchestrierung eines fortgeschrittenen LLM-Workflows. Im Unternehmensumfeld gibt es Dutzende weitere Orchestrierungsarchitekturen. Auch eine Chat-Oberfläche, die den aktuellen Prompt und den Chatverlauf nutzt, ist eine einfache Form der Orchestrierung. Für reproduzierbare Unternehmensabläufe mit sensiblen Firmendaten reicht eine einfache Chat-Orchestrierung jedoch oft nicht, und es braucht fortgeschrittene Workflows wie den oben gezeigten.
Wenn wir komplexe Prozesse für Generative-AI-Orchestrierungen im Unternehmen bewerten, ist der Blick auf die Fähigkeiten eines Foundation Models (oder eines feinabgestimmten Modells) daher oft nur der Anfang. Der nächste Abschnitt zeigt genauer, in welchem Kontext und welcher Orchestrierung wir Generative-AI-Anwendungen bewerten müssen.
Die folgenden Abschnitte stellen die Kernkonzepte unseres Ansatzes vor.
Mein Team hat die Plattform entAIngine gebaut. Sie ist insofern ziemlich einzigartig, als sie per Low-Code Anwendungen mit Generative-AI-Aufgaben erzeugt, die nicht zwingend Chatbots sind. Den folgenden Ansatz haben wir ebenfalls in entAIngine umgesetzt. Wenn Sie ihn ausprobieren möchten, schreiben Sie mir. Oder lassen Sie sich vom folgenden Konzept inspirieren, wenn Sie eine eigene Testumgebung bauen wollen.
Bei der Leistungsbewertung von Generative-AI-Anwendungen in ihren Orchestrierungen haben wir diese Optionen: Wir können ein Foundation Model isoliert bewerten, ein feinabgestimmtes Modell oder beides als Teil einer größeren Orchestrierung mit mehreren Aufrufen verschiedener Modelle und RAG. Das hat folgende Konsequenzen.
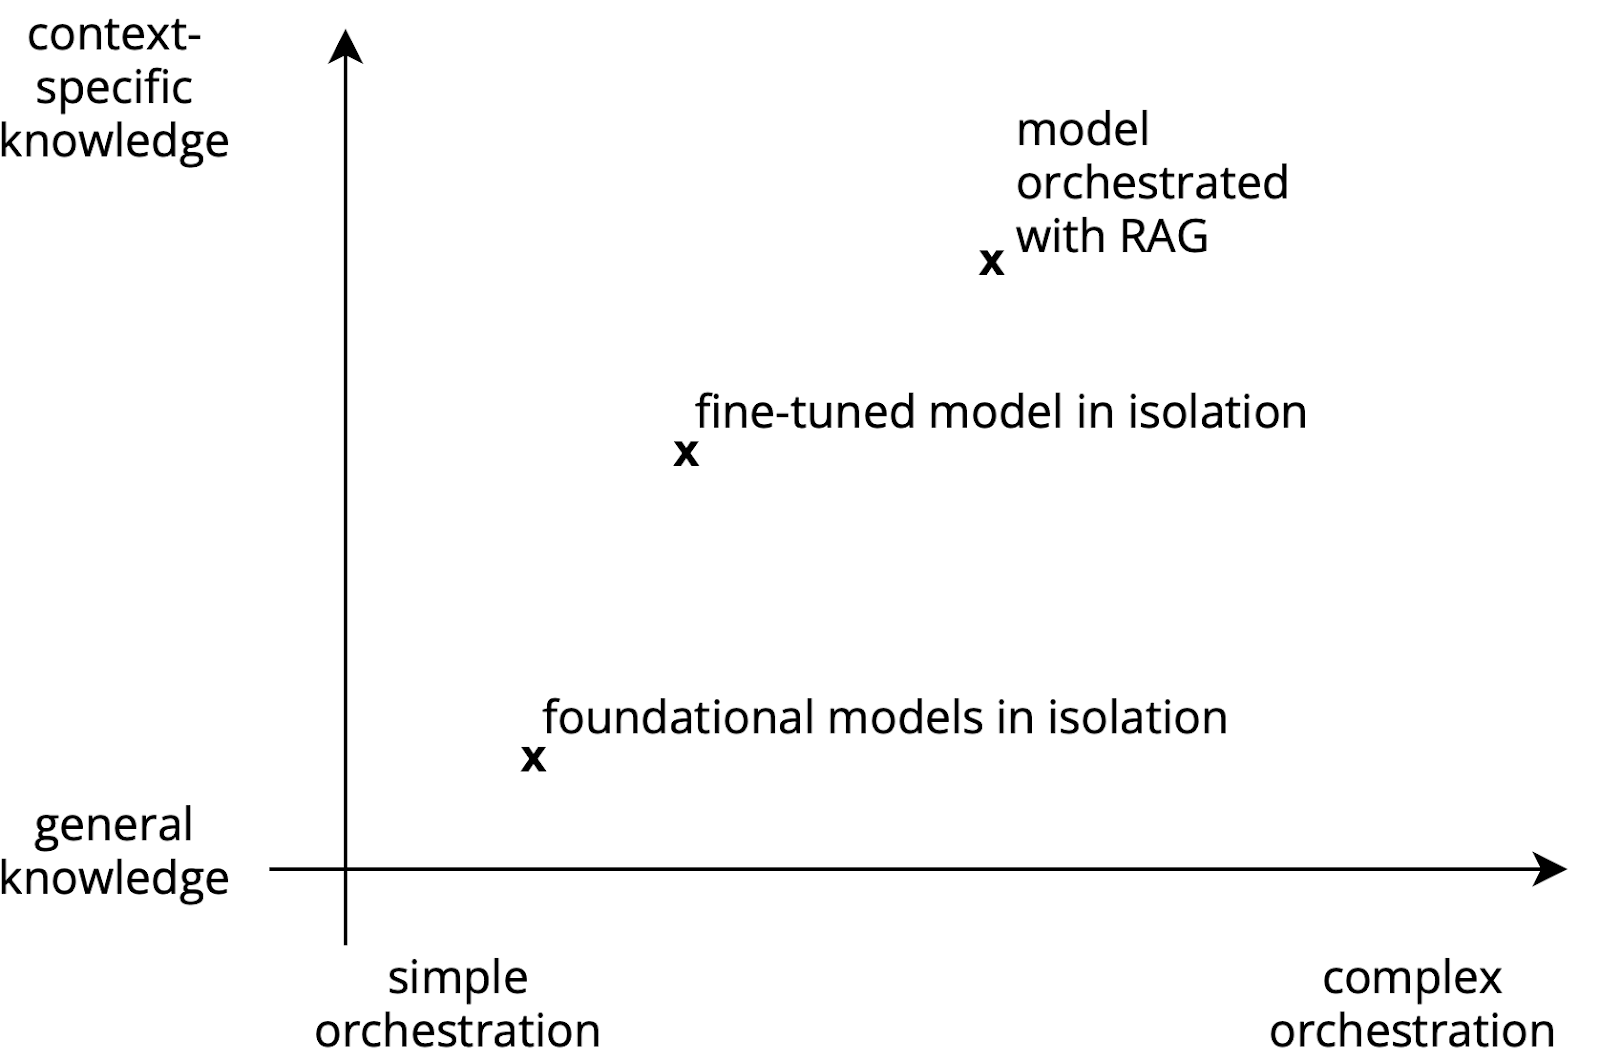
Kontext und Orchestrierung für LLM-basierte Anwendungen. (c) Marcel Müller, 2025
Öffentlich verfügbare Generative-AI-Modelle wie (bei LLMs) GPT-4o, Llama 3.2 und viele andere wurden mit der „öffentlichen Weisheit des Internets“ trainiert. Ihre Trainingsdaten umfassen einen großen Wissensbestand aus Büchern, Weltliteratur, Wikipedia-Artikeln und weiteren Crawls von Foren und Blogbeiträgen. Internes Unternehmenswissen steckt nicht in Foundation Models. Bewerten wir also die Fähigkeiten eines Foundation Models, können wir nur allgemein bewerten, wie Anfragen beantwortet werden. Wie umfangreich unternehmensspezifisches Wissen ist, also „wie viel das Modell weiß“, lässt sich nicht beurteilen. Unternehmensspezifisches Wissen kommt nur über eine fortgeschrittene Orchestrierung in ein Foundation Model, die entsprechenden Kontext einspeist.
Mit einem kostenlosen ChatGPT-Konto kann zum Beispiel jeder fragen: „Wie ist Goethe gestorben?“ Das Modell antwortet, weil die wichtigsten Informationen über Goethes Leben und Tod in seiner Wissensbasis stecken. Die Frage „Wie viel Umsatz hat unser Unternehmen im dritten Quartal des Vorjahres in EMEA gemacht?“ führt dagegen höchstwahrscheinlich zu einer stark halluzinierten Antwort, die unerfahrenen Nutzern plausibel erscheint. Bewerten können wir aber Form und Darstellung der Antworten, einschließlich Stil und Ton, sowie Sprachfähigkeiten und Fähigkeiten im Schlussfolgern und logischen Ableiten. Synthetische Benchmarks wie ARC, HellaSwag und MMLU liefern dafür Vergleichswerte. Diese Benchmarks betrachten wir in einem späteren Abschnitt genauer.
Feinabgestimmte Modelle bauen auf Foundation Models auf. Durch weiteres Training des zugrunde liegenden Machine-Learning-Modells mit zusätzlichen Datensätzen erhalten sie Wissen, das vorher nicht im Modell war. Sie haben mehr kontextspezifisches Wissen. Orchestrieren wir sie isoliert, ohne weitere eingespeiste Daten, können wir ihre Wissensbasis daraufhin bewerten, wie gut sie zu realen Szenarien eines Geschäftsprozesses passt. Fine-Tuning wird oft genutzt, um einem Foundation Model fachspezifisches Vokabular und typische Satzstrukturen beizubringen.
Trainieren wir ein Modell etwa mit einem Korpus von Gerichtsurteilen, beginnt das feinabgestimmte Modell, das Vokabular und den Satzbau der juristischen Fachsprache zu verwenden. Es kann Auszüge aus alten Fällen kombinieren, zitiert aber nicht die richtigen Quellen.
Foundation Models oder feinabgestimmte Modelle mit Retrieval-Augmented Generation (RAG) zu orchestrieren, liefert stark kontextabhängige Ergebnisse. Das erfordert allerdings eine komplexere Orchestrierungspipeline.
Ein Telekommunikationsunternehmen wie in unserem Beispiel kann mit einem Sprachmodell Embeddings seiner Support-Wissensbasis erzeugen und in einem Vector Store speichern. Diese Wissensbasis lässt sich dann effizient per semantischer Suche abfragen. Weil wir nachverfolgen, welche Textsegmente abgerufen werden, können wir die Quelle jedes Abschnitts sehr genau zeigen und ihn als Kontext an ein Large Language Model übergeben. So beantworten wir die Frage von Anfang bis Ende.
Für solche großen Orchestrierungen mit verschiedenen Verarbeitungsschritten können wir durchgängig bewerten, wie gut die Anwendung ihren Zweck erfüllt.
Die Bewertung dieser verschiedenen Setups liefert unterschiedliche Erkenntnisse, die wir in der Entwicklung von Generative-AI-Anwendungen nutzen können. Diesen Aspekt vertiefen wir im nächsten Abschnitt.
Wir entwickeln Generative-AI-Anwendungen in verschiedenen Phasen: 1) vor dem Bau, 2) während Bau und Test und 3) in Produktion. In einem agilen Vorgehen laufen diese Phasen nicht linear, sondern iterativ ab. Ziele und Methoden der Bewertung bleiben in jeder Phase jedoch gleich, unabhängig von der Reihenfolge.
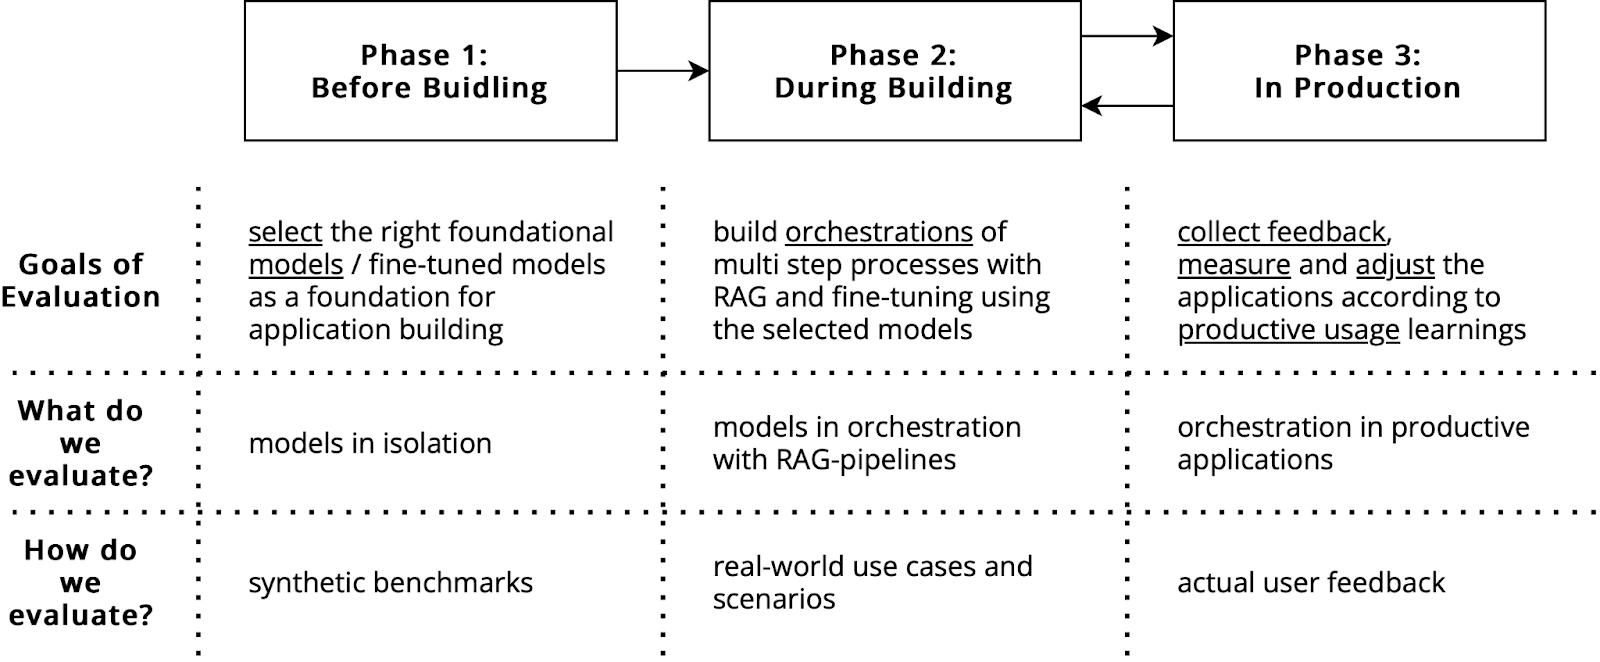
Vor dem Baumüssen wir bewerten, welches Foundation Model wir wählen oder ob wir ein neues von Grund auf bauen. Dazu definieren wir zuerst unsere Erwartungen und Anforderungen, vor allem an Ausführungszeit, Effizienz, Preis und Qualität. Derzeit bauen wegen Kosten und Pflegeaufwand nur sehr wenige Unternehmen eigene Foundation Models. Fine-Tuning und Retrieval-Augmented Generation sind die Standardwerkzeuge für stark personalisierte Pipelines mit nachvollziehbarem internem Wissen und reproduzierbaren Ergebnissen. In dieser Phase sind synthetische Benchmarks das Mittel der Wahl für Vergleichbarkeit. Wollen wir etwa eine Anwendung bauen, die Anwälte bei der Fallvorbereitung unterstützt, brauchen wir ein Modell, das gut logisch argumentiert und eine bestimmte Fachsprache versteht.
Während des Baus muss sich die Bewertung darauf konzentrieren, die Qualitäts- und Leistungsanforderungen der Beispielfälle zu erfüllen. Bei einer Anwendung für Anwälte treffen wir eine repräsentative Auswahl einiger alter Fälle. Diese Fälle bilden die Grundlage, um Standardszenarien der Anwendung zu definieren, auf deren Basis wir sie umsetzen. Ist der Anwalt etwa auf Finanz- und Steuerrecht spezialisiert, wählen wir einige Standardfälle aus, für die er Szenarien erstellen muss. Jede Bau- und Bewertungsaktivität in dieser Phase hat eine begrenzte Sicht auf repräsentative Szenarien und deckt nicht jeden Fall ab. Trotzdem müssen wir die Szenarien in den laufenden Entwicklungsschritten bewerten.
In Produktionkonzentriert sich die Bewertung darauf, die reale Nutzung der Anwendung quantitativ an den Erwartungen echter Nutzer zu messen. In Produktion stoßen wir auf Szenarien, die unsere Entwicklungsszenarien nicht abdecken. Ziel der Bewertung in dieser Phase ist, diese Szenarien zu entdecken und Feedback echter Nutzer zu sammeln, um die Anwendung weiter zu verbessern.
Die Produktionsphase sollte immer in die Entwicklung zurückfließen, damit die Anwendung iterativ besser wird. Die drei Phasen laufen also nicht linear, sondern greifen ineinander.
Nachdem das „Was“ und „Wann“ der Bewertung geklärt ist, stellt sich die Frage, „wie“ wir unsere Generative-AI-Anwendungen bewerten. Dafür gibt es drei Methoden: synthetische Benchmarks, begrenzte Szenarien und die Bewertung über Feedbackschleifen in Produktion.
Bei den synthetischen Benchmarks betrachten und vergleichen wir die gängigsten Ansätze.
Die AI2 Reasoning Challenge (ARC) testet Wissen und Schlussfolgern eines LLM mit 7787 naturwissenschaftlichen Multiple-Choice-Fragen. Die Fragen reichen von der 3. bis zur 9. Klasse und sind in einen Easy- und einen Challenge-Satz unterteilt. ARC eignet sich, um verschiedene Wissensarten zu bewerten und Modelle zu fordern, Informationen aus mehreren Sätzen zu verknüpfen. Der Hauptvorteil ist die umfassende Bewertung des Schlussfolgerns, allerdings beschränkt auf naturwissenschaftliche Fragen.
HellaSwag testet Alltagslogik und natürlichsprachliche Inferenz mit Satzergänzungsaufgaben aus realen Szenarien. Jede Aufgabe enthält einen Kontext aus einer Videobeschreibung und vier mögliche Enden. Der Benchmark misst, wie gut ein LLM Alltagssituationen versteht. Sein Hauptvorteil ist die zusätzliche Schwierigkeit durch Adversarial Filtering, er konzentriert sich aber vor allem auf Allgemeinwissen, was Tests in Fachdomänen einschränkt.
Der Benchmark MMLU (Massive Multitask Language Understanding) misst das Sprachverständnis eines LLM in 57 Aufgaben aus verschiedenen Fachgebieten, von MINT bis zu den Geisteswissenschaften. Er umfasst 15.908 Fragen vom Einstiegs- bis zum Expertenniveau. MMLU eignet sich ideal für eine umfassende Wissensbewertung. Die breite Abdeckung hilft, Schwächen zu erkennen, doch fehlende Details zur Erstellung und Fehler können die Zuverlässigkeit beeinträchtigen.
TruthfulQA bewertet die Fähigkeit eines LLM, wahrheitsgemäße Antworten zu geben, und adressiert damit Halluzinationen in Sprachmodellen. Er misst, wie genau ein LLM antworten kann, besonders wenn die Trainingsdaten unzureichend oder von geringer Qualität sind. Der Benchmark eignet sich zur Bewertung von Genauigkeit und Wahrhaftigkeit, mit dem Vorteil, sich auf faktisch korrekte Antworten zu konzentrieren. Sein Datensatz mit Allgemeinwissen spiegelt die Wahrhaftigkeit in Spezialgebieten jedoch möglicherweise nicht wider.
Die RAGAS-Framework dient der Evaluation von Retrieval-Augmented-Generation-Pipelines (RAG). Das Framework ist besonders nützlich für LLM-Anwendungen, die externe Daten nutzen, um den Kontext des LLM anzureichern. Es führt Metriken für Faithfulness, Answer Relevancy, Context Recall, Context Precision, Context Relevancy, Context Entity Recall und Summarization Score ein, mit denen sich die Qualität der abgerufenen Ergebnisse differenziert bewerten lässt.
WinoGrande testet das Alltagsverständnis eines LLM anhand von Aufgaben zur Pronomenauflösung auf Basis der Winograd Schema Challenge. Er enthält nahezu identische Sätze, deren Antwort sich durch ein Schlüsselwort ändert. Der Benchmark hilft beim Auflösen mehrdeutiger Pronomenbezüge und bietet einen großen Datensatz mit reduziertem Bias. Annotationsartefakte bleiben jedoch eine Einschränkung.
Die GSM8K Benchmark misst das mehrstufige mathematische Denken eines LLM anhand von rund 8.500 Matheaufgaben auf Grundschulniveau. Jede Aufgabe erfordert mehrere Schritte mit einfachen Rechenoperationen. Der Benchmark zeigt Schwächen im mathematischen Denken auf und bietet vielfältige Aufgabenstellungen. Die Einfachheit der Aufgaben kann jedoch ihre langfristige Relevanz begrenzen.
SuperGLUE erweitert den GLUE-Benchmark und testet die Sprachverständnisfähigkeiten (NLU) eines LLM in acht unterschiedlichen Teilaufgaben, darunter Boolean Questions und die Winograd Schema Challenge. Er bietet eine gründliche Bewertung von sprachlichem Wissen und Allgemeinwissen. SuperGLUE eignet sich ideal für eine breite NLU-Evaluation, mit umfassenden Aufgaben und detaillierten Erkenntnissen. Allerdings werden weniger Modelle getestet als bei Benchmarks wie MMLU.
HumanEval misst die Fähigkeit eines LLM, funktional korrekten Code zu erzeugen, anhand von Programmieraufgaben und Unit-Tests. Er umfasst 164 Programmieraufgaben mit jeweils mehreren Unit-Tests. Der Benchmark bewertet Programmier- und Problemlösungsfähigkeiten mit Fokus auf funktionale Korrektheit, ähnlich einer menschlichen Bewertung. Er deckt jedoch nur einen Teil praktischer Programmieraufgaben ab, was seine Aussagekraft begrenzt.
MT-Bench bewertet die Fähigkeit eines LLM in mehrstufigen Dialogen, indem er reale Gesprächssituationen simuliert. Er misst, wie gut Chatbots Gespräche in einem natürlichen Dialogfluss führen. Mit einem sorgfältig kuratierten Datensatz eignet sich MT-Bench zur Bewertung von Gesprächsfähigkeiten. Der kleine Datensatz und die Schwierigkeit, echte Gespräche zu simulieren, bieten jedoch noch Verbesserungspotenzial.
All diese Metriken sind synthetisch und sollen einen relativen Vergleich zwischen verschiedenen LLMs ermöglichen. Ihre konkrete Bedeutung für einen Anwendungsfall im Unternehmen hängt jedoch von der Zuordnung der Herausforderung im Szenario zum jeweiligen Benchmark ab. In Anwendungsfällen der Steuerbuchhaltung etwa, wo viel gerechnet wird, wäre GSM8K ein guter Kandidat, um diese Fähigkeit zu bewerten. Für den Einsatz eines LLM im Programmierumfeld ist HumanEval das Mittel der ersten Wahl.
Die Aussagekraft dieser Benchmarks ist jedoch eher abstrakt und liefert nur einen Anhaltspunkt auf ihre Leistung in einem Unternehmensanwendungsfall. Hier ist die Arbeit mit realen Szenarien gefragt.
Reale Szenarien bestehen aus folgenden Komponenten:
fallspezifischen Kontextdaten (Eingabe),
fallunabhängigen Kontextdaten,
eine Abfolge zu erledigender Aufgaben und
der erwarteten Ausgabe.
Mit realen Testszenarien können wir verschiedene Situationen abbilden, etwa
mehrstufige Chat-Interaktionen mit mehreren Fragen und Antworten,
komplexe Automatisierungsaufgaben mit mehreren KI-Interaktionen,
Prozesse mit RAG und
multimodale Prozessinteraktionen.
Mit anderen Worten: Das beste Modell der Welt hilft niemandem, wenn die RAG-Pipeline immer nur mittelmäßige Ergebnisse liefert, weil die Chunking-Strategie nicht gut ist. Fehlen zudem die richtigen Daten zur Beantwortung der Anfragen, gibt es immer Halluzinationen, die mal näher, mal weiter von der Wahrheit entfernt sind. Ebenso schwanken die Ergebnisse je nach Hyperparametern der gewählten Modelle (Temperature, Frequency Penalty usw.). Und das leistungsstärkste Modell können wir nicht für jeden Anwendungsfall nutzen, wenn es teuer ist.
Standard-Benchmarks konzentrieren sich auf einzelne Modelle statt auf das Gesamtbild. Deshalb stellen wir das PEEL-Framework zur Performance-Evaluation von Enterprise-LLM-Anwendungen vor, das uns eine durchgängige Sicht von Anfang bis Ende gibt.
Das Kernkonzept von PEEL ist das Evaluationsszenario. Wir unterscheiden zwischen Evaluationsszenario Definition und Evaluationsszenario Ausführung. Die konzeptionelle Darstellung zeigt die übergreifenden Konzepte in Schwarz, eine Beispieldefinition in Blau und das Ergebnis einer einzelnen Ausführung in Grün.
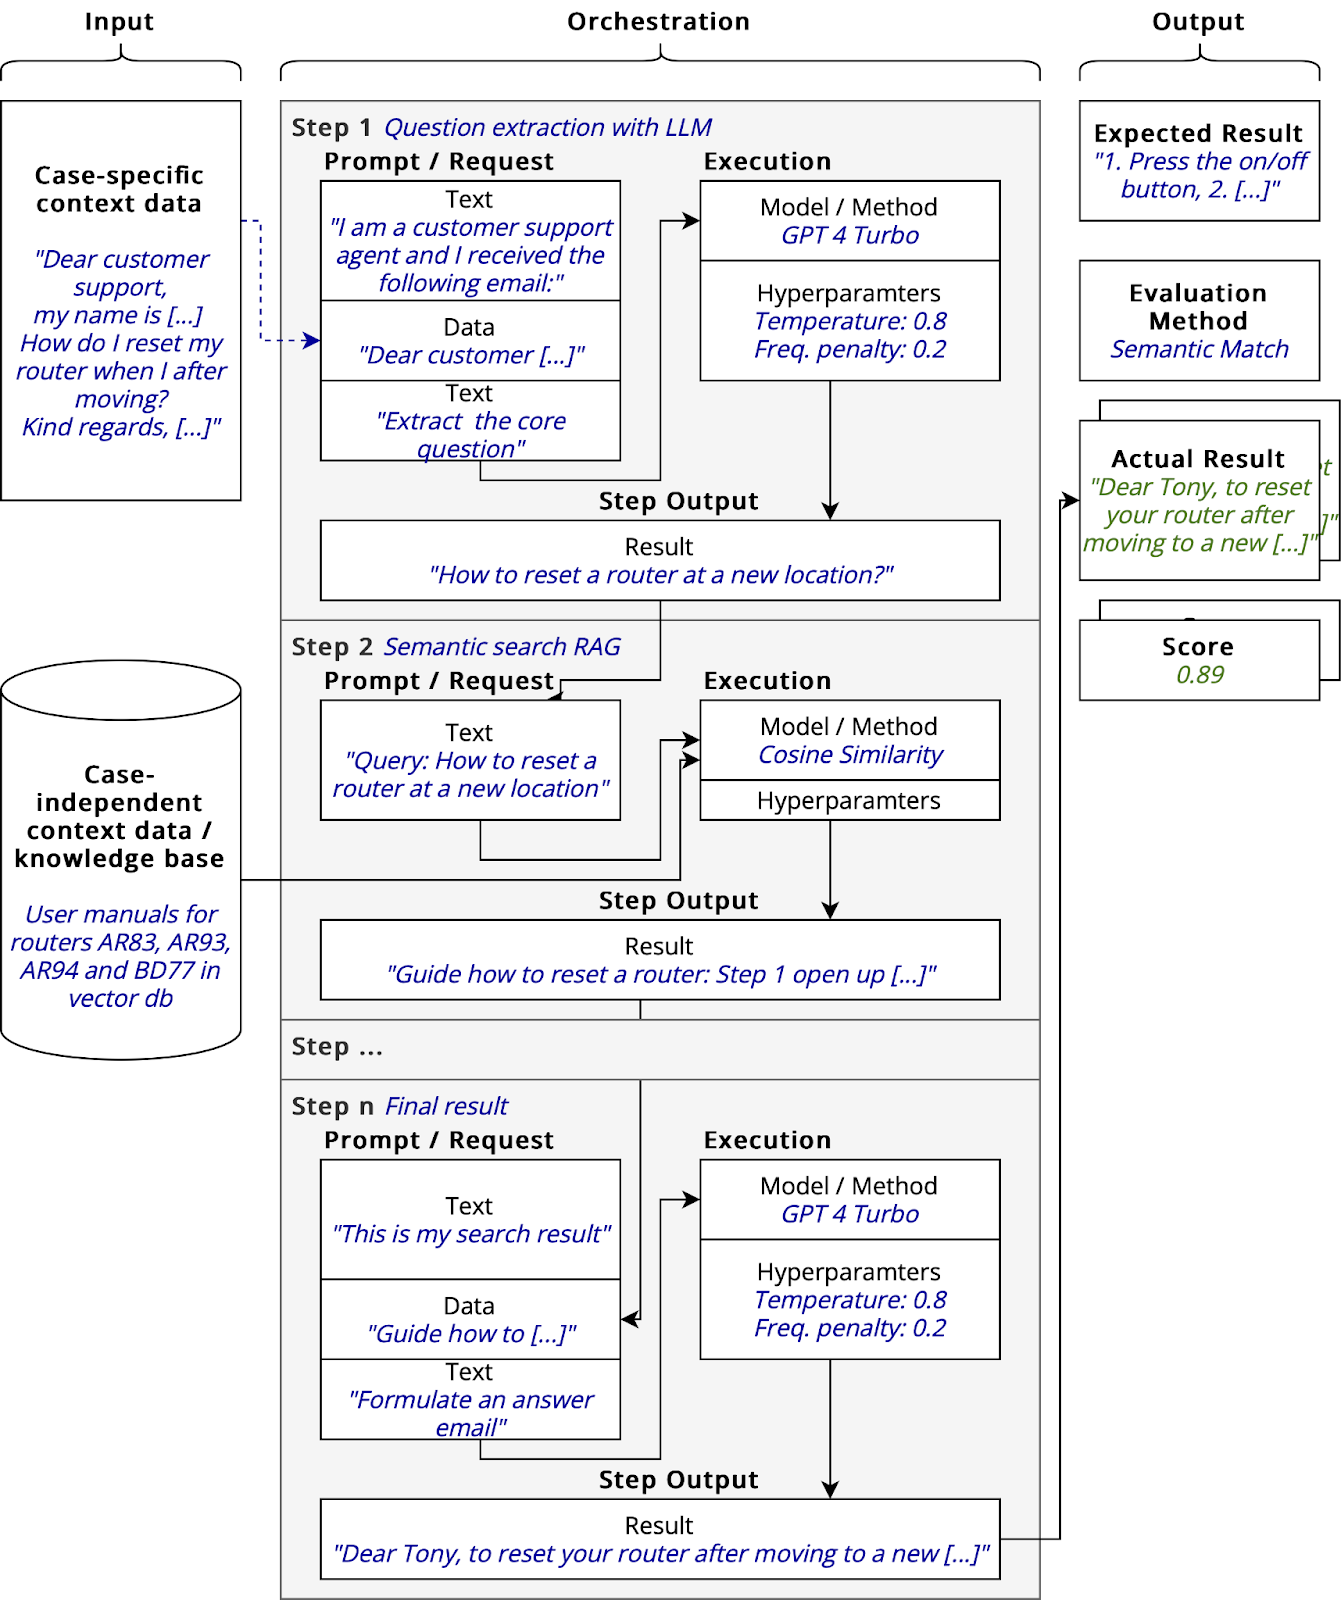
Das Konzept der Evaluationsszenarien im PEEL-Framework © Marcel Müller
Eine Evaluationsszenario-Definition besteht aus Eingabedefinitionen, einer Orchestrierungsdefinition und einer erwarteten Ausgabedefinition.
Bei der Eingabe unterscheiden wir zwischen fallspezifischen und fallunabhängigen Kontextdaten. Fallspezifische Kontextdaten ändern sich von Fall zu Fall. Im Kundensupport ist zum Beispiel die Frage eines Kunden in jedem Fall eine andere. In unserer Beispielausführung haben wir einen Fall dargestellt, in dem die E-Mail-Anfrage wie folgt lautet:
"Sehr geehrter Kundensupport,
mein Name ist [...]. Wie setze ich meinen Router zurück, wenn ich in eine andere Wohnung umziehe?
Mit freundlichen Grüßen, [...] "
Die Wissensbasis, in der die Antworten in umfangreichen Dokumenten stehen, ist dagegen fallunabhängig. In unserem Beispiel liegt eine Wissensbasis mit den PDF-Handbüchern der Router AR83, AR93, AR94 und BD77 in einem Vektorspeicher.
Eine Evaluationsszenario-Definition hat eine Orchestrierung. Eine Orchestrierung besteht aus einer Folge von n >= 1 Schritten, die bei der Ausführung des Evaluationsszenarios nacheinander ausgeführt werden. Jeder Schritt erhält Eingaben aus einem der vorherigen Schritte oder aus der Eingabe der Szenarioausführung. Schritte können Interaktionen mit LLMs (oder anderen Modellen), Aufgaben zum Abruf von Kontext (zum Beispiel aus einer Vektordatenbank) oder andere Aufrufe von Datenquellen sein. Für jeden Schritt unterscheiden wir zwischen Prompt / Anfrage und Ausführungsparametern. Die Ausführungsparameter umfassen das auszuführende Modell oder Verfahren sowie die Hyperparameter. Der Prompt / die Anfrage ist eine Sammlung verschiedener statischer oder dynamischer Datenbausteine, die zusammengefügt werden (siehe Abbildung).
In unserem Beispiel haben wir eine dreistufige Orchestrierung. In Schritt 1 extrahieren wir eine einzelne Frage aus dem fallspezifischen Eingabekontext (der E-Mail-Anfrage des Kunden). Diese Frage nutzen wir in Schritt 2 für eine semantische Suchanfrage in unserer Vektordatenbank mit der Kosinus-Ähnlichkeit. Der letzte Schritt nimmt die Suchergebnisse und formuliert mit einem LLM eine E-Mail.
In einer Evaluationsszenario-Definition gibt es eine erwartete Ausgabe und eine Evaluationsmethode. Hier legen wir für jedes Szenario fest, wie wir das tatsächliche Ergebnis mit dem erwarteten vergleichen. Dafür gibt es folgende Optionen:
Exakte Übereinstimmung/Regex-Match: Wir prüfen, ob eine bestimmte Folge von Begriffen/Konzepten vorkommt, und geben als Antwort einen booleschen Wert zurück. 0 bedeutet, dass die definierten Begriffe in der Ausgabe nicht vorkamen, 1 bedeutet, dass sie vorkamen. Zum Beispiel besteht das Kernkonzept bei der Installation eines Routers an einem neuen Standort darin, den Reset-Knopf 3 Sekunden lang zu drücken. Wenn die Begriffe "Reset-Knopf" und "3 Sekunden" nicht in der Antwort vorkommen, werten wir dies als Fehlschlag.
Semantische Übereinstimmung: Wir prüfen, ob der Text semantisch nah an der erwarteten Antwort liegt. Dazu lassen wir ein LLM mit einer Zahl zwischen 0 und 1 beurteilen, wie gut die Antwort zur erwarteten Antwort passt.
Manuelle Bewertung: Menschen bewerten die Ausgabe auf einer Skala von 0 bis 1.
Ein Evaluationsszenario sollte viele Male ausgeführt werden, weil LLMs nichtdeterministische Modelle sind. Wir brauchen eine sinnvolle Anzahl von Ausführungen, damit wir die Scores aggregieren und ein statistisch signifikantes Ergebnis erhalten.
Der Vorteil solcher Szenarien ist, dass wir sie beim Aufbau und Debugging unserer Orchestrierungen nutzen können. Sehen wir, dass 80 von 100 Ausführungen desselben Prompts einen Score unter 0,3 haben, nutzen wir das, um unsere Prompts anzupassen oder vor der Orchestrierung weitere Daten ins Fine-Tuning aufzunehmen.
Das Sammeln von Feedback im Produktivbetrieb folgt demselben Prinzip wie der Szenario-Ansatz. Wir ordnen jede Nutzerinteraktion einem Szenario zu. Haben Nutzer mehr Freiheitsgrade, müssen wir eventuell neue Szenarien anlegen, die wir in der Aufbauphase nicht vorhergesehen haben.
Der Nutzer erhält einen Schieberegler zwischen 0 und 1, mit dem er angibt, wie zufrieden er mit einem Ergebnis war. Aus UX-Sicht lässt sich diese Zahl auch vereinfachen, zum Beispiel mit einem lachenden, neutralen und traurigen Smiley. Diese Bewertung entspricht also der zuvor vorgestellten manuellen Bewertung.
Im Produktivbetrieb erstellen wir dieselben Aggregationen und Metriken wie zuvor, nur mit echten Nutzern und potenziell deutlich mehr Daten.
Gemeinsam mit dem entAIngine Team haben wir die Funktionalität auf der Plattform umgesetzt. Dieser Abschnitt zeigt, wie es gehen kann, und soll Sie inspirieren. Wenn Sie nutzen möchten, was wir umgesetzt haben, tun Sie das gerne.
Wir übertragen unsere Konzepte für Evaluationsszenarien und deren Definitionen auf klassische Konzepte des Softwaretestens. Ausgangspunkt für das Anlegen eines neuen Tests ist das entAIngine-Anwendungsdashboard.
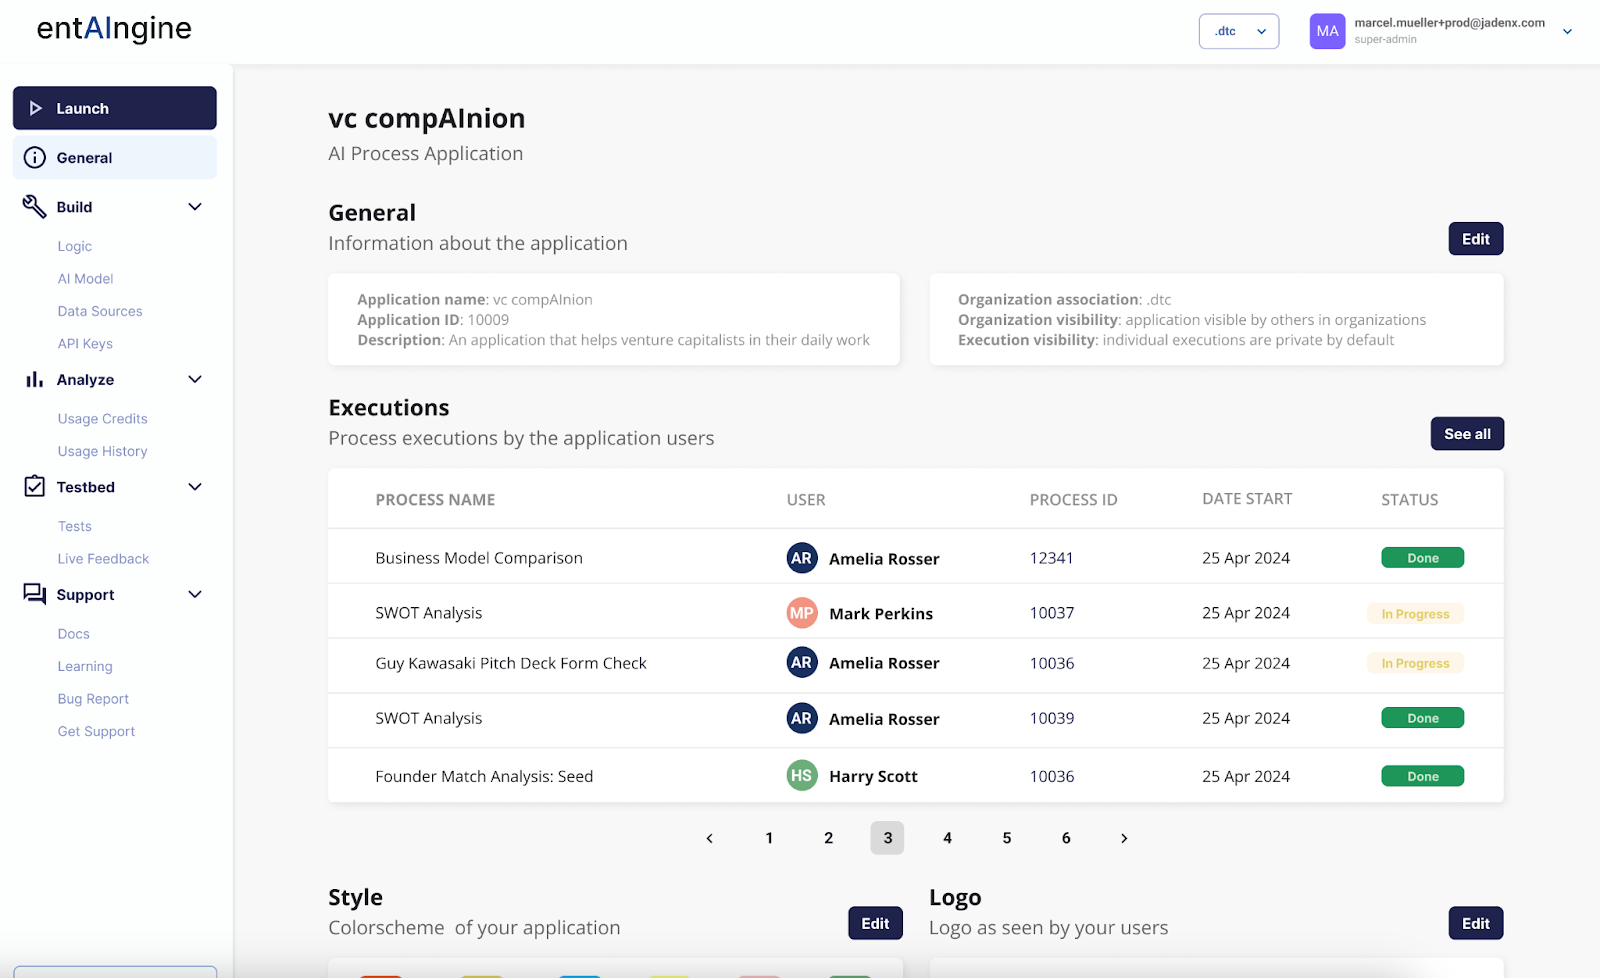
entAIngine-Dashboard © Marcel Müller
In entAIngine können Nutzer viele verschiedene Anwendungen erstellen. Jede Anwendung ist eine Menge von Prozessen, die Workflows in einer No-Code-Oberfläche definieren. Prozesse bestehen aus Eingabevorlagen (Variablen), RAG-Komponenten, LLM-Aufrufen, TTS-, Bild- und Audiomodulen, Dokumentanbindungen und OCR. Mit diesen Komponenten bauen wir wiederverwendbare Prozesse, die per API integriert, als Chat-Flows genutzt, in einem Texteditor als dynamischer Textbaustein eingesetzt oder in einer Wissensmanagement-Suche verwendet werden können, die die Quellen der Antworten anzeigt. Diese Funktionalität ist in der entAIngine-Plattform bereits vollständig umgesetzt und kann als SaaS oder zu 100 % on-premise betrieben werden. Sie bindet bestehende Gateways, Datenquellen und Modelle per API an. Den Prozessvorlagen-Generator nutzen wir für Evaluationsszenario-Definitionen.
Um einen neuen Test anzulegen, geht der Nutzer zu "Test Bed" und "Tests".
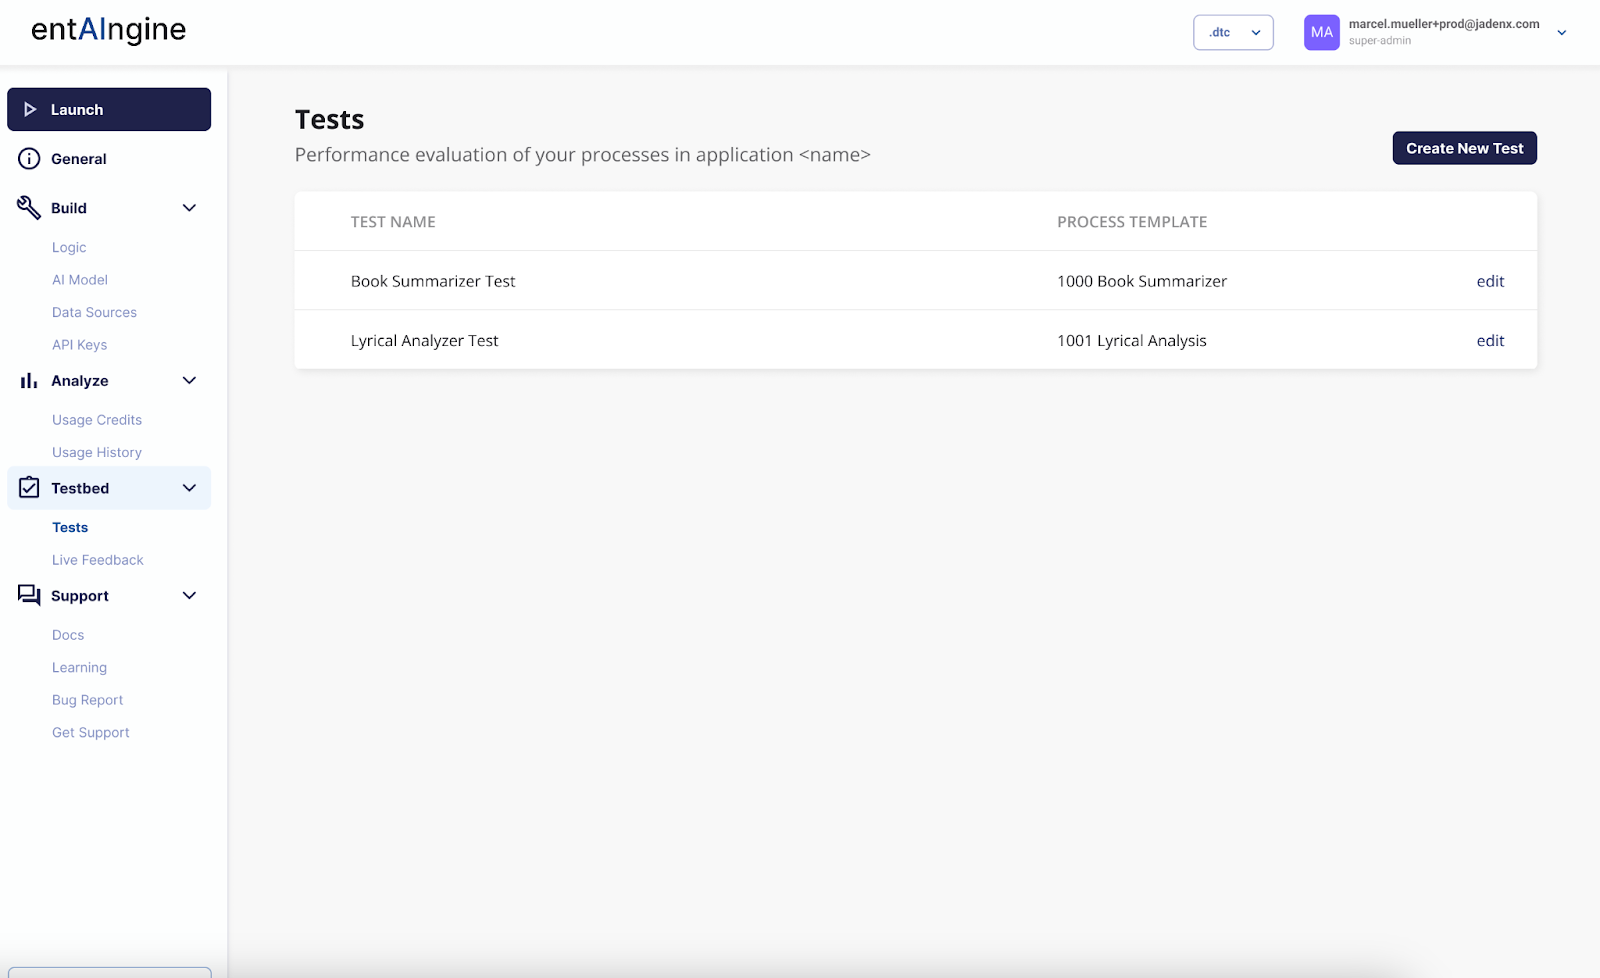
In der Testansicht kann der Nutzer neue Evaluationsszenarien anlegen oder bestehende bearbeiten. Beim Anlegen eines neuen Szenarios müssen die Orchestrierung (eine entAIngine-Prozessvorlage) und eine Reihe von Metriken festgelegt werden. Wir nehmen ein Kundensupport-Szenario an, in dem wir im ersten Schritt per RAG Daten abrufen, um eine Frage zu beantworten, und im zweiten Schritt eine Antwort-E-Mail formulieren. Mit dem neuen Modul benennen wir dann den Test, definieren bzw. wählen eine Prozessvorlage und einen Evaluator, der für jeden einzelnen Testfall einen Score berechnet.
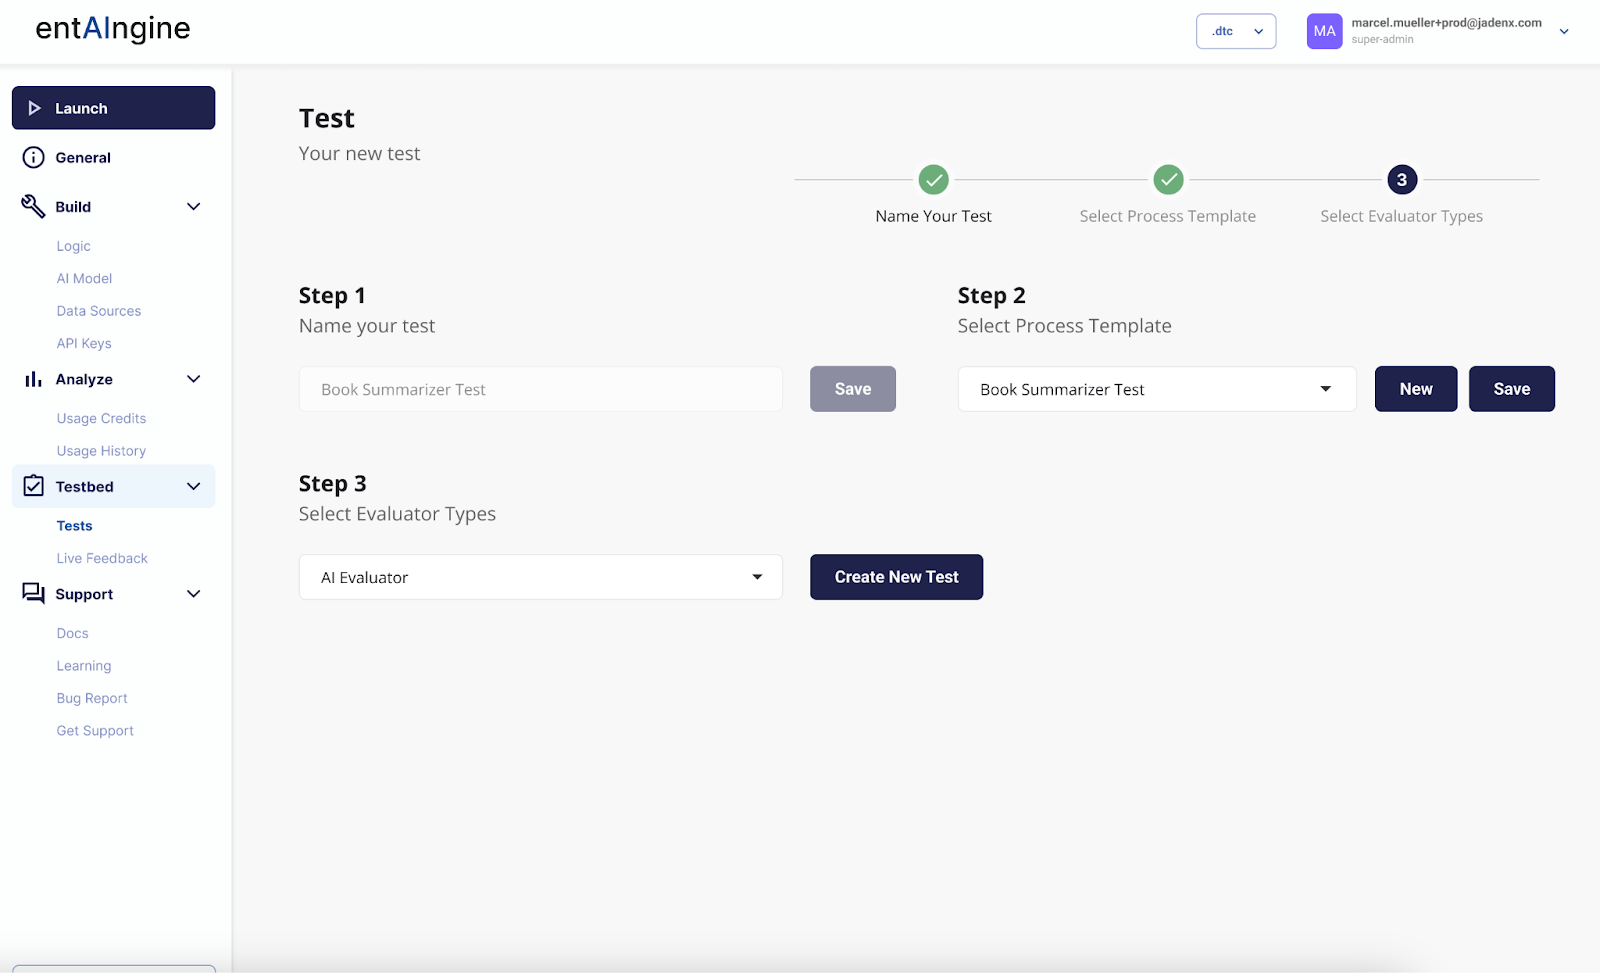
Testdefinition © Marcel Müller, 2025
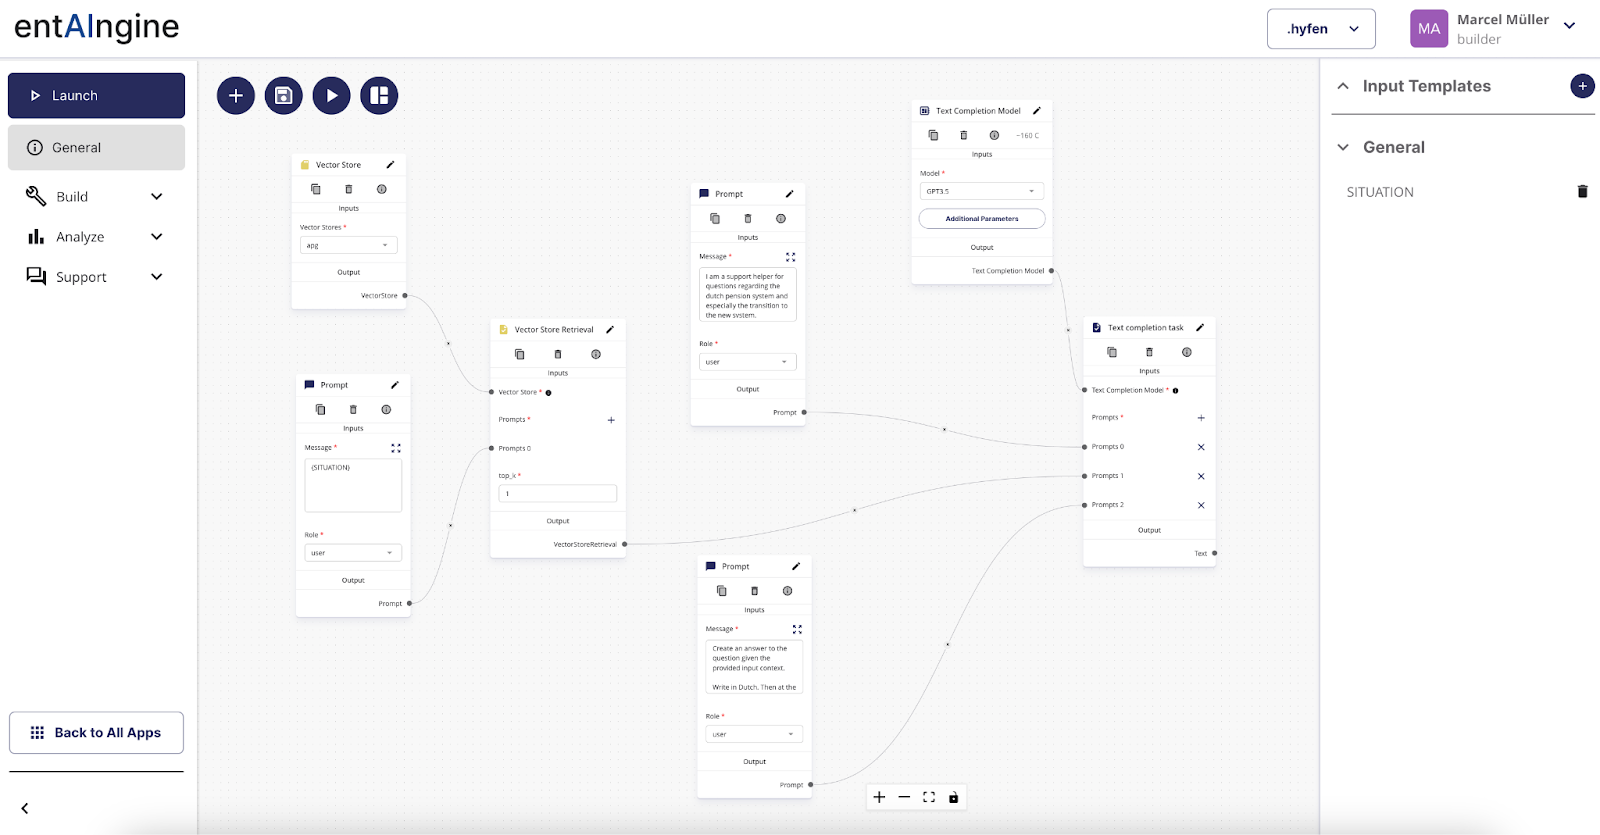
Definition eines Testfalls (Prozessvorlage) © Marcel Müller, 2025
Die Metriken sind wie oben definiert: Regex-Match, semantische Übereinstimmung und manuelle Bewertung. Die Ansicht mit der Prozessdefinition existiert bereits und ist zusammen mit der Orchestrierung funktionsfähig. Neu ist die unten gezeigte Funktion, Tests gesammelt zu definieren.
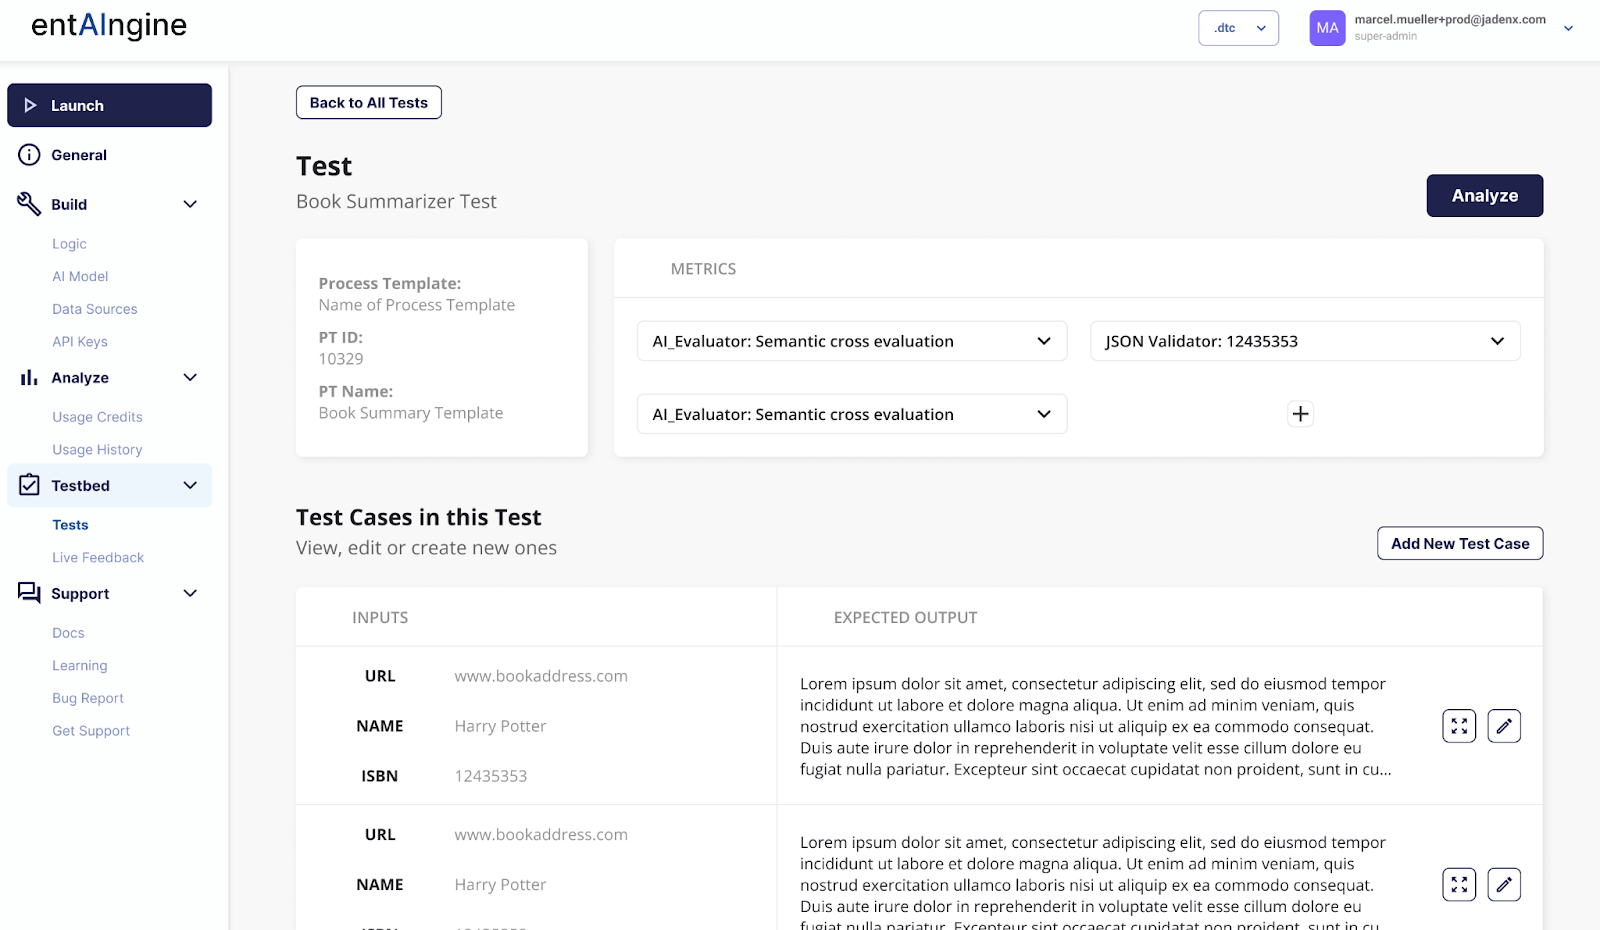
Tests und Testfälle © Marcel Müller, 2025
Im Test-Editor arbeiten wir an einer Evaluationsszenario-Definition ("bewerte, wie gut unser RAG für Kundensupport-Antworten ist") und legen in diesem Szenario verschiedene Testfälle an. Ein Testfall weist den Variablen des Tests Datenwerte zu. Wir können 50 oder 100 verschiedene Testfälle durchspielen, bewerten und aggregieren. Wenn wir zum Beispiel unsere Kundensupport-Antworten bewerten, definieren wir 100 verschiedene Supportanfragen samt erwartetem Ergebnis, führen sie aus und analysieren, wie gut die Antworten waren. Sobald ein Satz Testfälle steht, führen wir die Szenarien mit den passenden Variablen über die bestehende Orchestrierungs-Engine aus und bewerten sie.
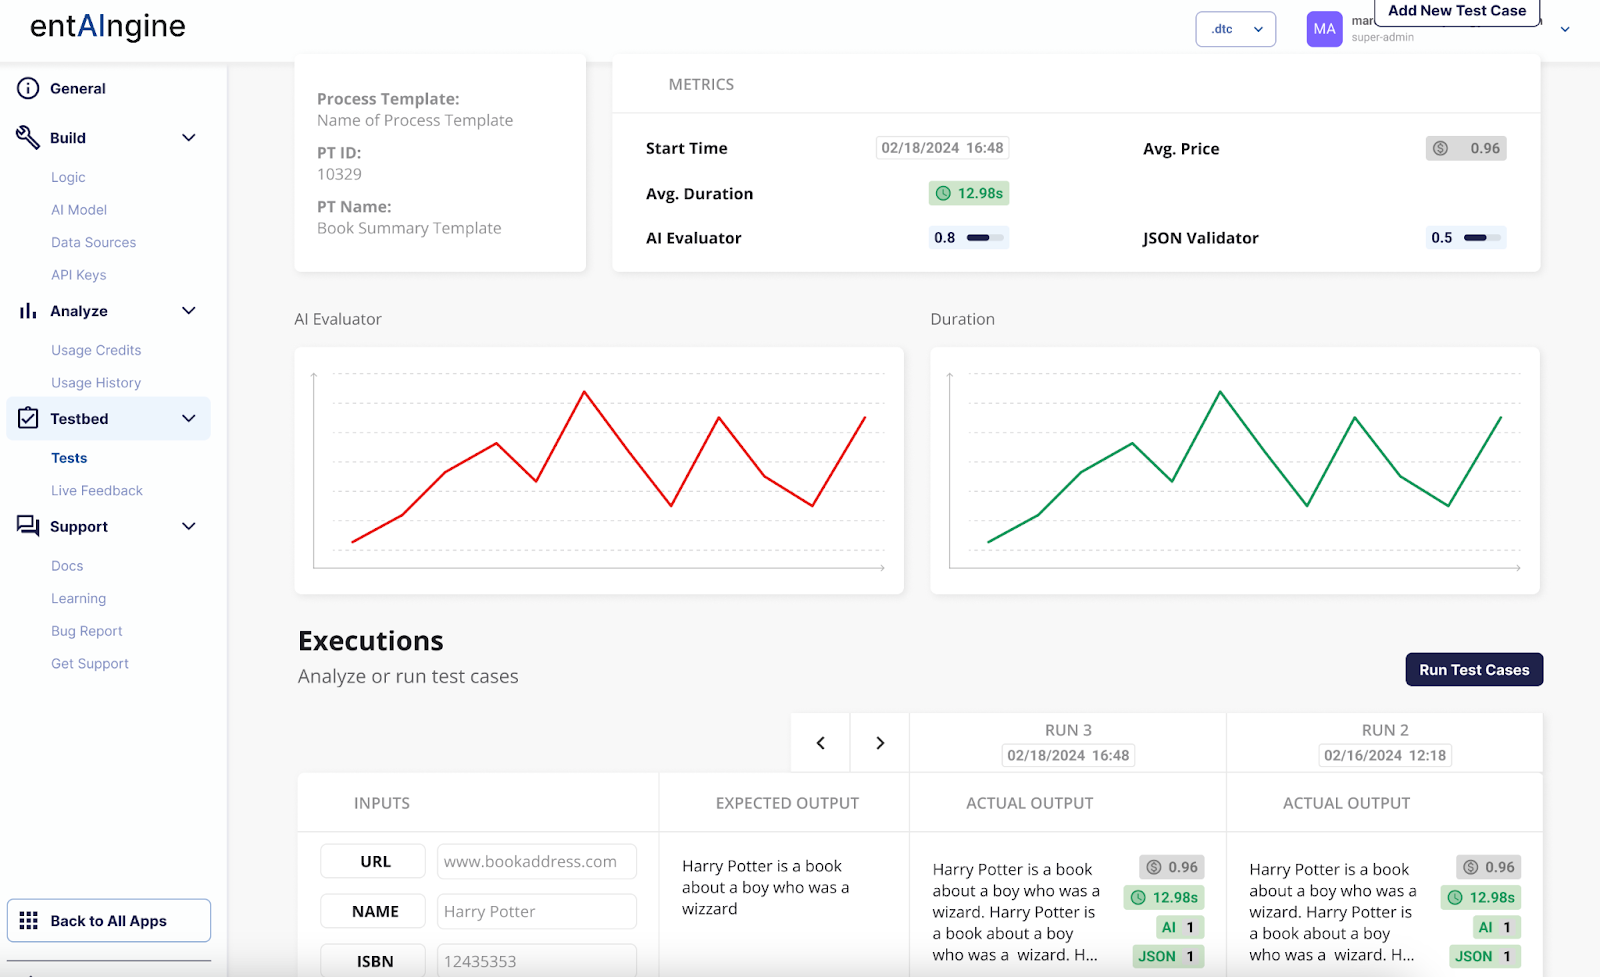
Metriken und Evaluation © Marcel Müller, 2025
Dieses Testen findet in der Aufbauphase statt. Für die Produktivphase gibt es eine zusätzliche Ansicht, mit der wir echtes Nutzerfeedback auswerten. Die Inhalte stammen aus echtem Nutzerfeedback (über unsere Engine und API).
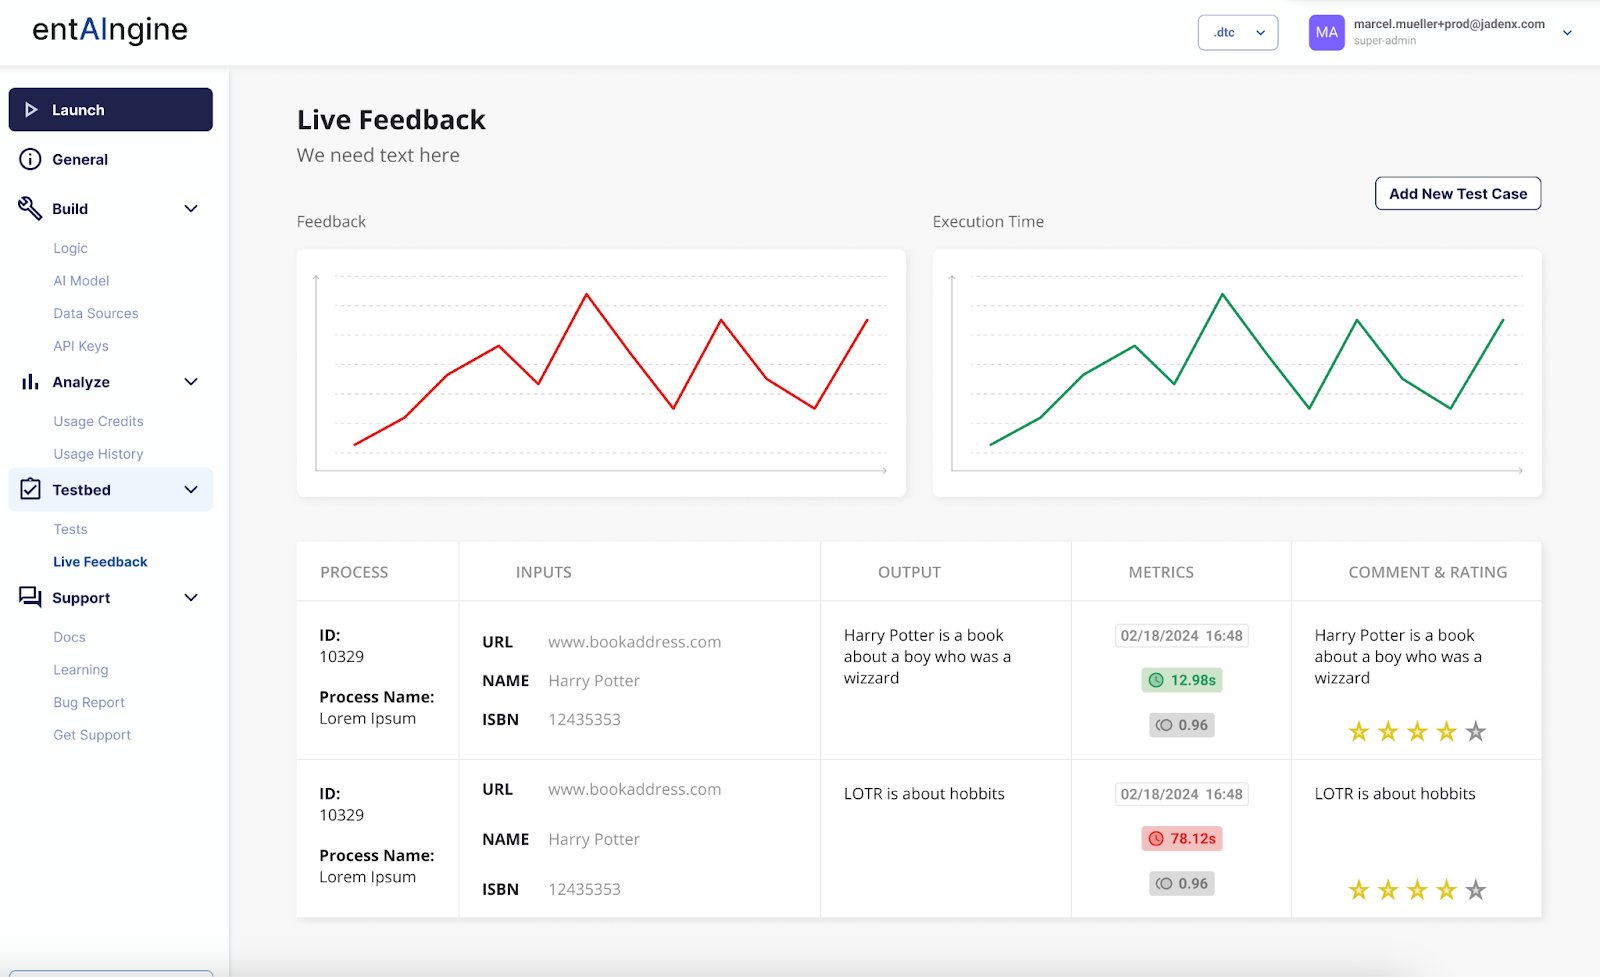
Die Metriken im Live-Feedback-Bereich werden über eine Sternebewertung der Nutzer erhoben.
In diesem Artikel haben wir fortgeschrittene Test- und Qualitätskonzepte für Anwendungen mit generativer KI betrachtet, insbesondere für solche, die komplexer sind als einfache Chatbots. Das vorgestellte PEEL-Framework ist ein neuer Ansatz für szenariobasiertes Testen, der näher an der Implementierung liegt als die generischen Benchmarks, mit denen wir Modelle testen. Für gute Anwendungen ist es wichtig, das Modell nicht nur isoliert, sondern in der Orchestrierung zu testen.
Ich arbeite im Alltag an realen Anwendungen mit generativer KI, vor allem im Unternehmensumfeld. Wenn Sie sich vernetzen möchten, fügen Sie mich gerne hinzu oder schreiben Sie mir auf LinkedIn.