No-Code Generative AI: Wie Unternehmen ohne Data Scientists bauen können
20. Januar 2026
In letzter Zeit sehe ich viele Unternehmen, die unbedingt „etwas mit Generative AI machen“ wollen und Hilfe suchen. Wird der Bedarf konkret, suchen sie oft interne Experten oder Freelancer. Zu meiner Überraschung suchen viele dieser Unternehmen Data Scientists und ML Engineers, weil sie annehmen, das sei der Schlüssel, um Generative AI wirksam zu nutzen.
Aus meiner Erfahrung mit über einem Dutzend Generative-AI-Projekten für Mittelständler und Konzerne ist klar geworden: Vielen Unternehmen fehlt ein umfassendes Verständnis davon, was und wer für eine erfolgreiche KI-Einführung nötig ist. Sie missverstehen oft die benötigten Rollen und stellen Spezialisten ein, ohne zu prüfen, ob diese Rollen zu ihren Zielen passen. Das führt zu Ineffizienz und unnötiger Komplexität und bremst am Ende den Fortschritt.
In diesem Artikel gehe ich auf diese Herausforderungen ein und zeige einen anderen Ansatz. Statt stark auf Data Scientists zu setzen, untersuche ich, wie No-Code-KI-Lösungen Unternehmen helfen, schneller und effizienter zu innovieren. Mit No-Code-Plattformen umgehen Unternehmen viele klassische Engpässe und kommen auf direkterem Weg zum Erfolg mit Generative AI.
Bevor wir tief in Generative AI einsteigen, betrachten wir klassische KI-Projekte und die Beteiligten. Mit klassischen KI-Projekten meine ich Projekte, in denen wir die gesamte Pipeline eines Anwendungsfalls von Grund auf entwickeln müssen, inklusive Modellbau, Datenaufbereitung und Anwendungsentwicklung.
Üblicherweise sehen diese Projekte etwa so aus:
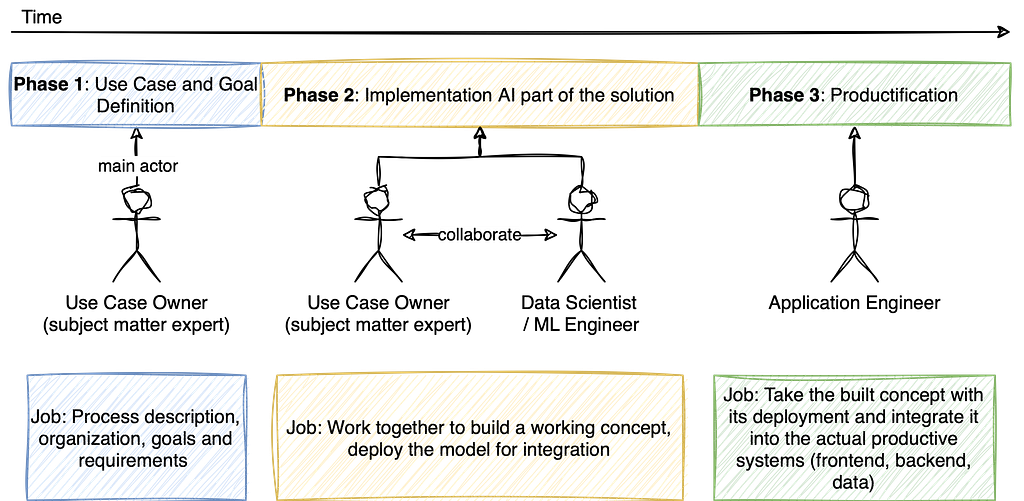
Abbildung: Klassische KI-Projekte
Klassische KI-Projekte brauchen mehrere Rollen, um eine Idee vom Konzept in die Produktion zu bringen. Die Rollen, die ich verwende, heißen vielleicht anders. Meine Rollenbeschreibungen orientieren sich am Zweck, auch wenn die Titel je nach Organisation abweichen.
Die erste Phase ist die Definition von Problem und Ziel. Fachexperten (Subject Matter Experts, SMEs) sind hier entscheidend. Von ihnen stammt die Problemdefinition, sie haben das Fachwissen und sind die Quelle der Geschäftsanforderungen, aus denen technische Anforderungen werden. Als Verantwortliche eines Anwendungsfalls können Fachexperten die Ergebnisse umgesetzter Lösungen sehr gut validieren. Meist sind sie aber keine KI-Experten, und ihnen fehlen die prozessgetriebenen Denkmuster, die für durchgängige Lösungsentwürfe nötig sind.
Deshalb arbeiten Fachexperten eng mit Data Scientists zusammen, um festzulegen, welche Daten nötig sind und welche Ergebnisse das Projekt liefern soll. Data Scientists übersetzen die Geschäftsanforderungen der Fachexperten in umsetzbare technische Anforderungen. Ihre Arbeit geht über den Modellbau hinaus: Sie müssen die Problemdomäne vollständig verstehen, relevante Erkenntnisse gewinnen und den richtigen Input von den Fachexperten bekommen.
Sie leiten die nächste Phase, die Entwicklung der Lösung. Data Scientists bauen und validieren Machine-Learning-Modelle, mit Schwerpunkt auf Feature Engineering und Algorithmenauswahl. Ihre Hauptaufgabe ist zu experimentieren und sicherzustellen, dass das Modell das erkannte Problem wirksam löst. Dabei arbeiten sie mit Data Engineers und ML Engineers zusammen, damit die Lösung machbar und skalierbar ist.
Es folgt die Produktisierung, in der Application Engineers eine Schlüsselrolle spielen. Als Application Engineers bezeichne ich „klassische“ Entwickler ohne besondere KI-Kenntnisse, die Frontends, Backends und die gesamte Orchestrierung dazwischen (Datenzugriff, DevOps usw.) umsetzen können.
Sie übernehmen die fertigen Modelle vom Data Scientist und integrieren sie in eine produktive Gesamtanwendung. Sie bauen Benutzeroberflächen und machen aus dem KI-Modell eine funktionierende Lösung, mit der Endnutzer arbeiten können. Jede Rolle ist für den Projekterfolg wichtig, aber die Komplexität und die Abhängigkeit von Spezialisten treiben Kosten und Laufzeiten. Genau hier bietet No-Code-KI eine effiziente Alternative.
Das Data-Scientist-Missverständnis
Wenn mir Leute sagen, sie bräuchten Data Scientists, weil sie mit GenAI anfangen wollen, sehe ich zwei verbreitete Missverständnisse: 1) was ihrer Meinung nach ein Data Scientist tut vs. was er tatsächlich tut, und 2) was ihrer Meinung nach in einem Generative-AI-Projekt gebraucht wird vs. was tatsächlich gebraucht wird.
Schauen wir uns 1) an. Die folgenden zwei Tortendiagramme zeigen das Problem ziemlich genau.
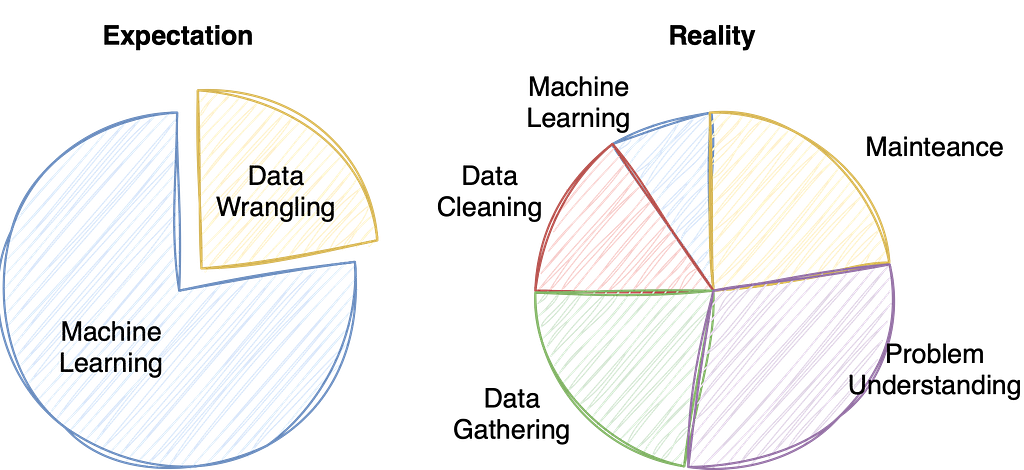
Aufgaben von Data Scientists: Erwartung vs. Realität
Das erste Diagramm zeigt, was Data Scientists in Generative-AI-Projekten angeblich tun. Viele nehmen an, sie verbrächten die meiste Zeit mit Modellen: KI-Modelle entwerfen, umsetzen und testen, dazu etwas Datentransformation. In Wirklichkeit besteht ein großer Teil ihrer Arbeit aus Datenaufbereitung und dem Verstehen der Geschäftsanforderungen, was viel Abstimmung mit Fachexperten und anderen Stakeholdern erfordert.
Das zweite Diagramm zeigt, was ein Data Scientist tatsächlich tut. Weniger als 25 % der Zeit entfallen auf Modellbau und Validierung. Über 30 % gehen in Problemverständnis und Abstimmung mit Stakeholdern, ein Aspekt, der auch in den Beschreibungen anderer Rollen steht. Den größten Teil der Zeit nehmen Datenbeschaffung und Modellpflege ein.
Behalten Sie diese Erkenntnis darüber, womit ein Data Scientist seine Zeit tatsächlich verbringt, im Kopf, wenn wir uns 2) ansehen: was in Generative-AI-Projekten wirklich gebraucht wird.
Der LLM-Paradigmenwechsel: Vortrainierte Modelle
Large Language Models (LLMs) werden auf riesigen Datensätzen trainiert, die aus dem Internet gesammelt wurden. Meist sind diese Daten für alle frei verfügbar.
Wenn Unternehmen von Generative AI sprechen, trainieren sie in 95 % der Fälle keine eigenen Modelle. Sie nutzen vortrainierte Modelle anderer Organisationen mit Zugang zu enormer Rechenleistung. Vortrainierte Modelle wie GPT-4 von OpenAI sind darauf ausgelegt, menschenähnliche Antworten zu verstehen und zu erzeugen, und lassen sich ohne aufwendiges Zusatztraining in größere Anwendungen orchestrieren. Sie sind als Basis für eigene Anwendungen gedacht, die sie über eine API nutzen.
Vortrainierte Modelle senken die Einstiegshürde in Generative AI erheblich. Unternehmen müssen keine eigenen Modelle von Grund auf bauen, was oft ein spezialisiertes Data-Science-Team, riesige Datenmengen und viel Rechenleistung erfordert. Stattdessen greifen sie auf einsatzbereite Modelle zurück. So können sie sich darauf konzentrieren, mit KI Geschäftsprobleme zu lösen, statt Modelle zu entwickeln. Vor allem aber ist ein eigenes Modell sehr teuer.
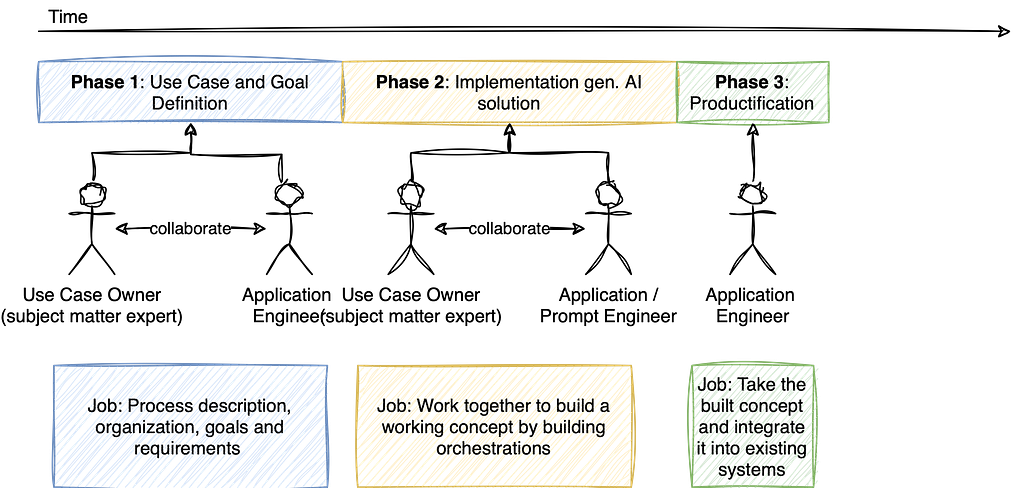
Abbildung: Umsetzung von Generative-AI-Projekten
Vortrainierte Modelle bieten entscheidende Vorteile, darunter kürzere Time-to-Market und geringere Kosten. Unternehmen können sie schnell integrieren und sparen sich langwierige Datenerhebung und Trainingsprozesse. Außerdem profitieren sie von den laufenden Verbesserungen durch Organisationen wie OpenAI und Google. Mit vortrainierten Modellen können Unternehmen diese KI-Fähigkeiten in ihre bestehenden Abläufe orchestrieren und Wert schaffen, ohne stark in Data-Science-Expertise zu investieren.
Vor diesem Hintergrund schauen wir uns an, welche Aufgaben in einem GenAI-Projekt tatsächlich anfallen.
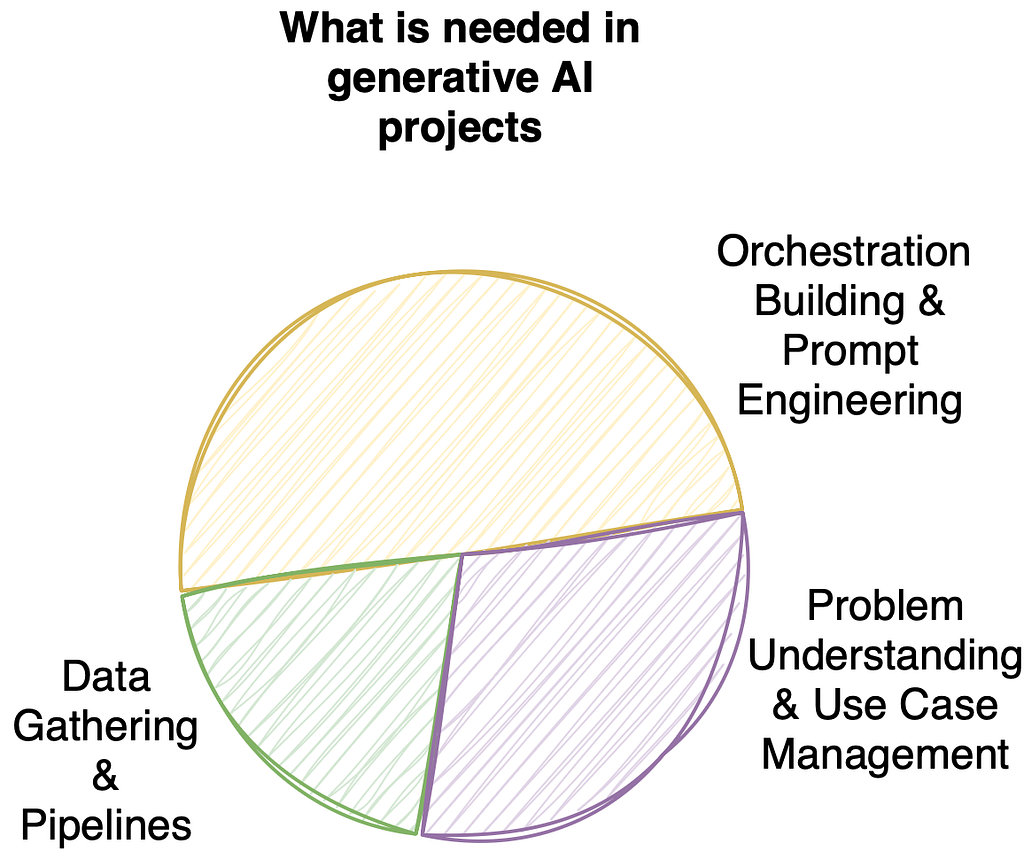
Was es für ein Generative-AI-Projekt braucht
Der Großteil der Zeit in einem Generative-AI-Projekt fließt in die Orchestrierung von Modellen und in Prompt Engineering, gefolgt von Problemverständnis, Anforderungsanalyse und dem Bau von Datenpipelines. Ein GenAI-Modell zu orchestrieren erfordert andere Fähigkeiten, als ein Modell von Grund auf zu bauen. Die meisten heute verbreiteten Modelle sind über eine API verfügbar, eine Schnittstelle, mit der grundsätzlich jeder Anwendungsentwickler umgehen kann.
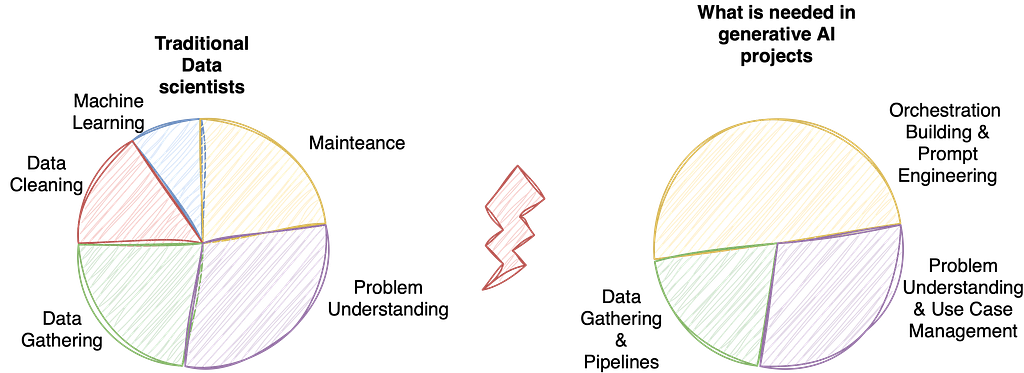
Die Diskrepanz: Generative-AI-Projekte mit Data Scientists
Setzen wir also einen Data Scientist auf ein Generative-AI-Projekt, wird nur ein kleiner Teil seiner Fähigkeiten genutzt. Gleichzeitig werden andere Fähigkeiten gebraucht, die nicht zur klassischen Data-Science-Rolle gehören, etwa Prompt Engineering und iterative Entwicklung. Ich plädiere aber auch nicht dafür, Data Scientists durch Prompt Engineers zu ersetzen, ein Begriff, der noch beliebiger verwendet wird als „Data Scientist“.
Wer Generative-AI-Anwendungen von Anfang bis Ende umsetzen soll, muss tatsächlich Folgendes können:
Diese Beschreibung passt viel eher zu einem klassischen Softwareentwickler als zu einem Data Scientist. Bemerkenswert ist auch: Für die meisten Aufgaben bei der Umsetzung einer Generative-AI-Anwendung wird das tiefe Grundlagenwissen von Data Scientists nicht gebraucht.
Beim Bau von Generative-AI-Anwendungen geht es viel mehr darum, vorhandene Modelle möglichst wirksam zu integrieren und zu orchestrieren, als die Details hinter den Kulissen zu bauen (oder auch nur zu verstehen).
Ich setze deshalb lieber einen Application Engineer mit etwas Zusatzschulung in Generative AI auf ein Generative-AI-Projekt als einen Data Scientist. Das ist besser für Kosten, Effizienz und Tempo.
Orchestrierung ist der Schlüssel: KI für Ihr Geschäft nutzbar machen
Orchestrierung bedeutet in der KI, mehrstufige Chain-of-Thought-Prompts zu erstellen, die Daten, Modelle und Logik in überschaubaren Schritten zusammenführen. Dabei werden Workflows strukturiert, in denen verschiedene Komponenten wie Datenquellen, KI-Modelle und Anwendungslogik zusammenwirken, um ein gewünschtes Ergebnis zu erreichen. Indem sie komplexe Aufgaben in kleinere, handhabbare Einheiten zerlegen, machen Orchestrierungswerkzeuge KI-Systeme effizienter und wirksamer.
Man kann sich Orchestrierung eher als „Zusammennähen verschiedener Stoffstücke“ vorstellen, im Gegensatz zu „alle Stoffe weben, zuschneiden und nähen“, der Metapher für den Bau eines Modells von Grund auf.
Der Vorteil der Orchestrierung ist, dass sie die Komplexität der Verwaltung verschiedener KI-Komponenten abstrahiert. Sie integriert vortrainierte Modelle und Datendienste auf schlanke Weise, sodass Teams sich auf den Nutzen konzentrieren können statt auf die technischen Details jedes Modells. Das ist in Generative-AI-Projekten besonders wichtig, weil dort Modelle verbinden, Logik anwenden und Workflows schnell iterieren über den Erfolg entscheiden.
Zur Orchestrierung gehören diese Themen:
Eine Generative-AI-Orchestrierung wird in bestehende Systeme integriert, um durchgängig geschäftliche Wirkung zu erzielen. Mit etwas Weiterbildung können Application Engineers all diese Aufgaben übernehmen.
No-Code-KI: Teams stärken, nicht nur Data Scientists
Indem Application Engineers statt Data Scientists programmieren, haben wir Kosten gespart, Reibung im Entwicklungsprozess verringert und Tempo gewonnen. Aber es geht noch schneller.
Erinnern Sie sich, dass Orchestrierung immer aus denselben Komponenten besteht, die man nur „zusammennäht“? Genau solche Situationen sind ideale Anwendungsfälle für No-Code- oder Low-Code-Plattformen.
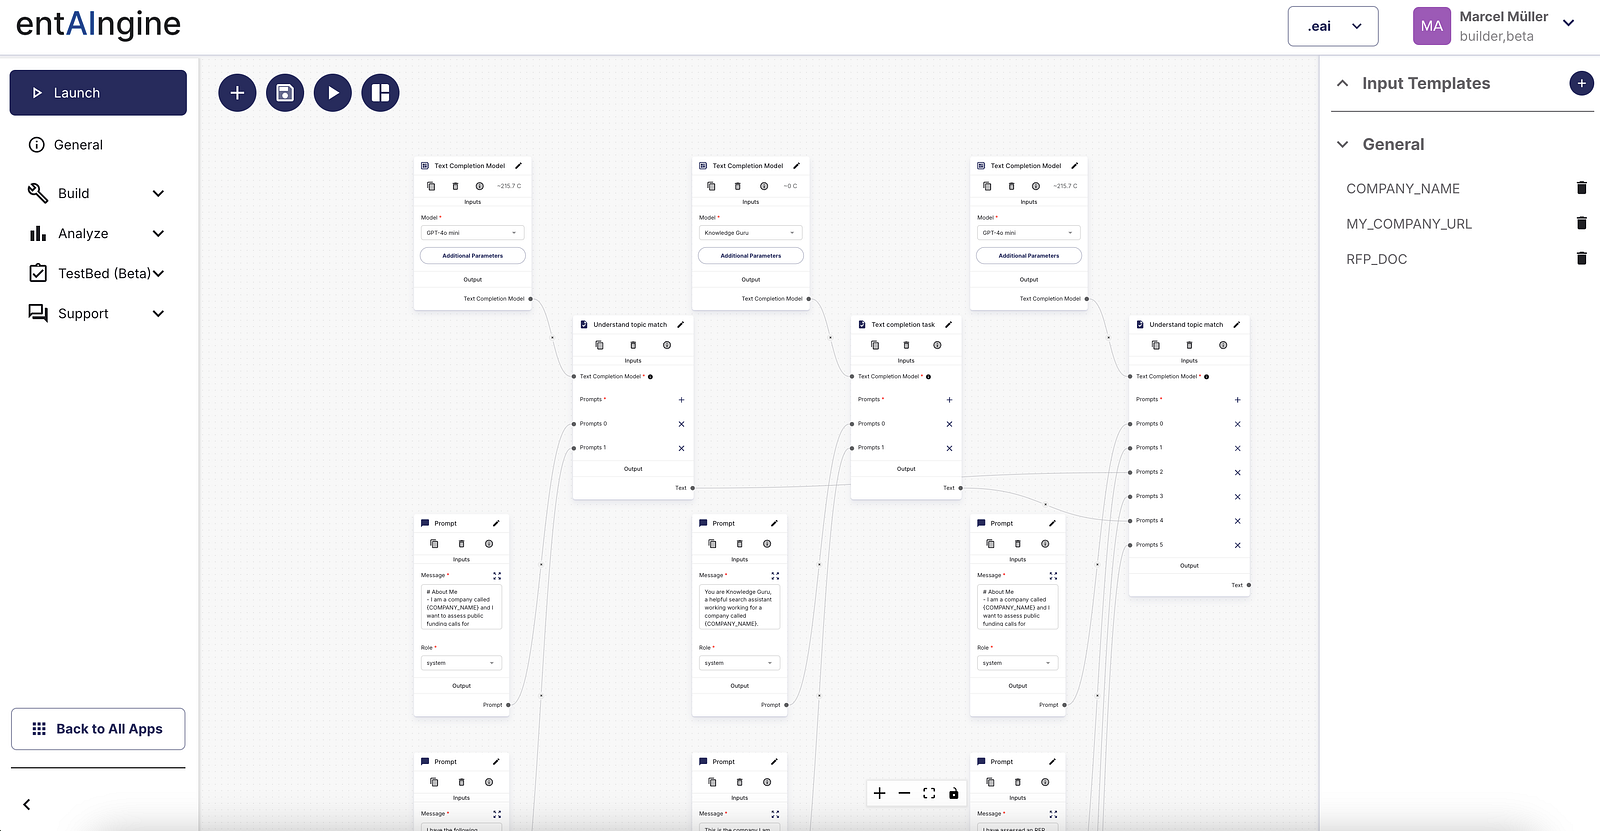
No-Code-Prozessaufbau mit Generative AI
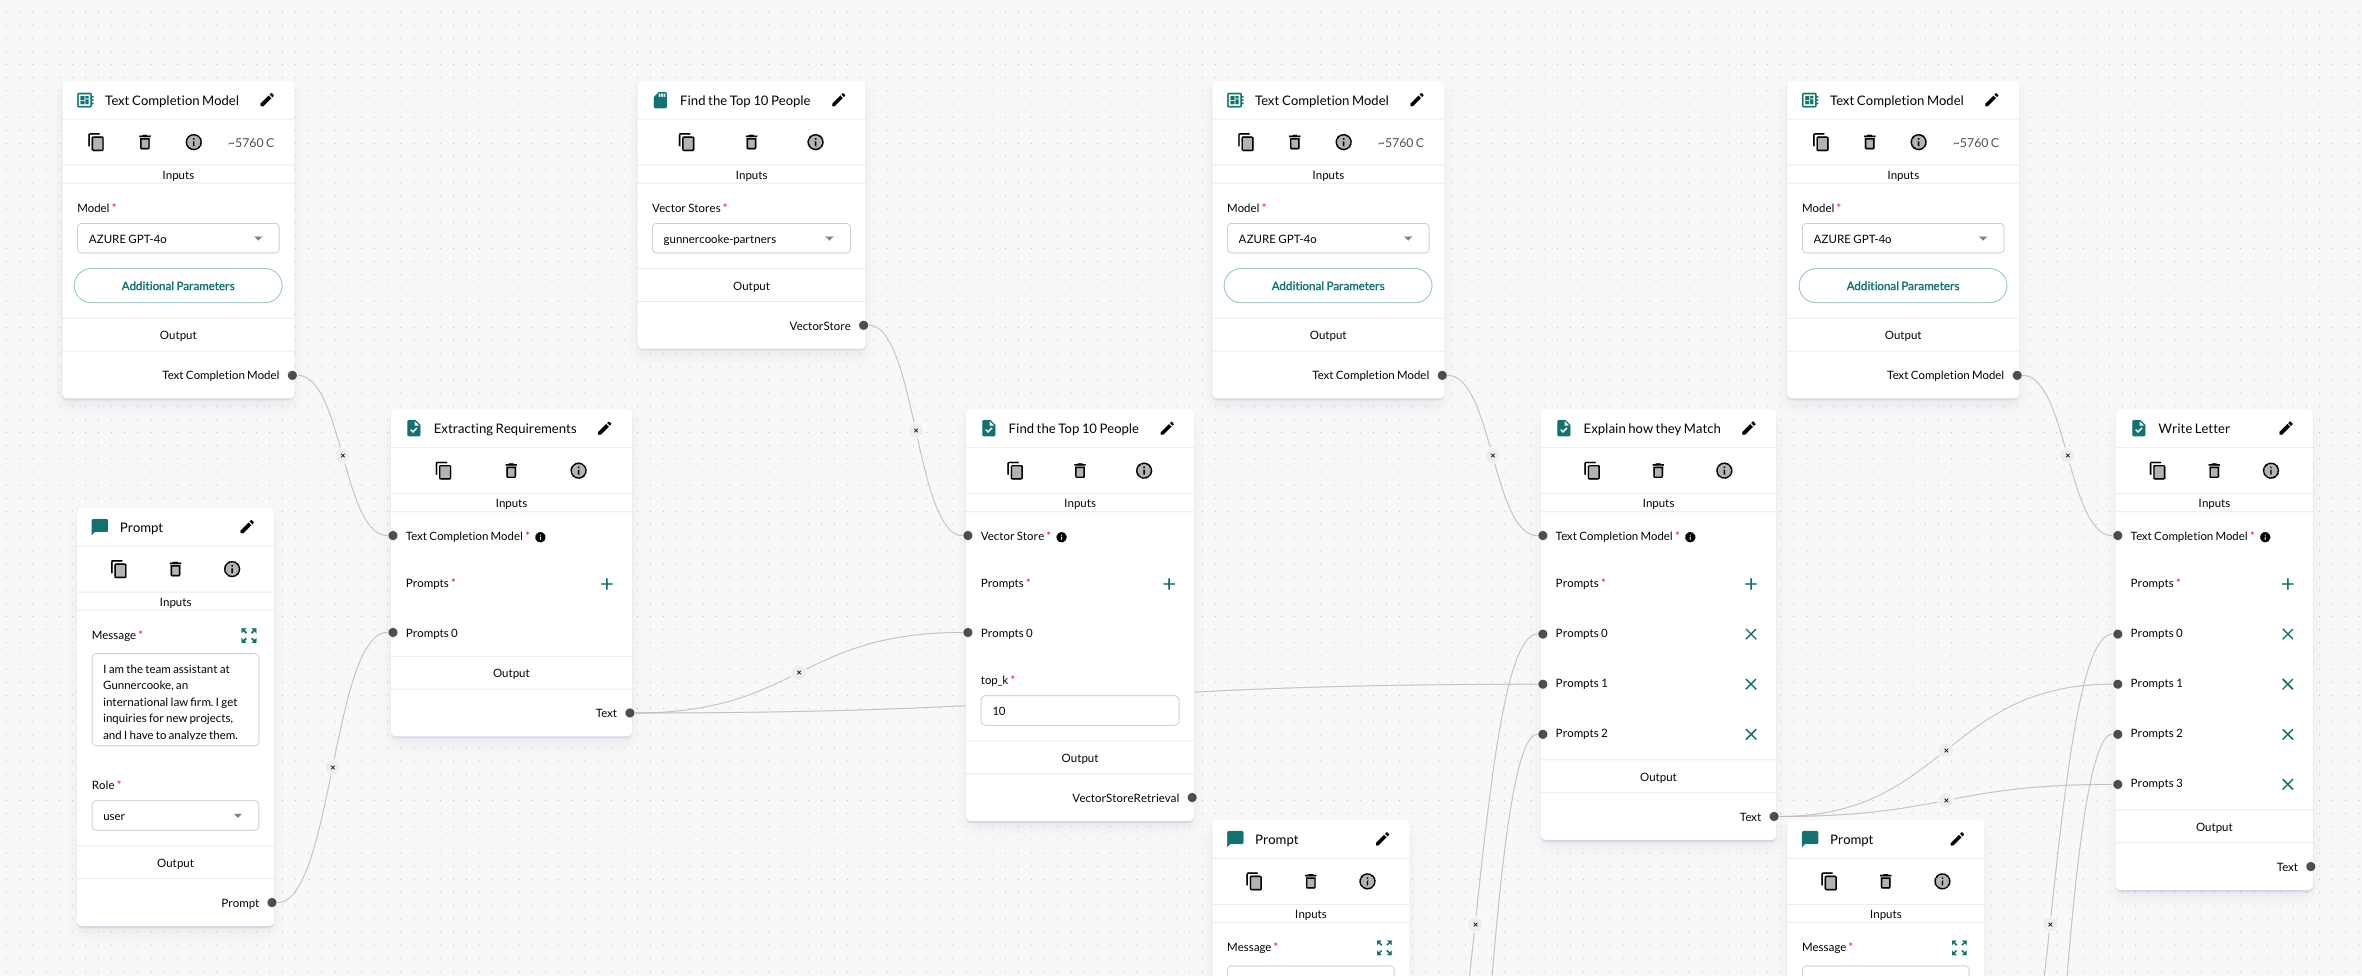
Mit entAIngine bauen wir eine Standardplattform, auf der Sie Ihre Daten und bestehenden Governance-Strukturen anbinden und Orchestrierungen definieren. Wir verstehen diese Orchestrierungen als Prozessvorlagen, weil sie eine Folge von Schritten mit unterschiedlichen Eingaben sind. Ein Beispiel: Wir wollen eine Orchestrierung bauen, die eine Projektanfrage per E-Mail aufnimmt, die richtigen Personen für das Projekt findet und eine Antwort erstellt. Im ersten Schritt extrahieren wir mit einem LLM die Anforderungen aus der E-Mail. Dann nutzen wir Retrieval-Augmented Generation (RAG), um im Unternehmen die Personen zu finden, die zu den Anforderungen passen, per semantischer Suche in einer Vektordatenbank. In den letzten Schritten erstellen wir mit den gefundenen Informationen und einem LLM eine Antwort-E-Mail.
Ich bin ein großer Fan davon, jede KI-Anwendung als Folge KI-gestützter Geschäftsprozesse zu behandeln. Wir bauen „Blaupausen“ (Prozessvorlagen) mit Variablen, die sich von Fall zu Fall ändern (im E-Mail-Beispiel wäre das der E-Mail-Text). Bei jedem neuen Fall (also jeder neuen E-Mail) füllen wir die Variablen mit den fallspezifischen Daten und führen die Prozessvorlage aus.
Dieses Prinzip kann jeder anwenden, der in Prozessen denken kann. Zu verstehen, wie man Wissensbasen mit RAG nutzt, hochwertige und reproduzierbare Ergebnisse erzielt und Modellkosten optimiert, ist eine Lernkurve, aber meiner Meinung nach braucht es dafür nicht die Fähigkeiten eines Data Scientists.
Mit einem No-Code-Ansatz lassen sich viele, aber nicht alle Aufgaben beim Bau von Generative-AI-Apps erledigen. Spezielle Aufgaben wie die Integration bestehender Systeme oder Anpassungen brauchen weiterhin einen Application Engineer. In den meisten Fällen aber kann der entscheidende Teil einer Generative-AI-Anwendung mit No-Code-Plattformen wie entAIngine von technikaffinen, prozessorientierten Menschen gebaut werden, egal welchen Titel oder Hintergrund sie haben.
Eine Zukunft, in der KI allen gehört
Generative AI bietet enormes Potenzial, aber der Umsetzungsansatz macht den Unterschied. Wer weniger auf Data Scientists setzt und No-Code-Plattformen nutzt, erschließt die Kraft der KI kostengünstig und effizient. Klassische KI-Projekte erfordern oft spezialisierte Rollen, was Entwicklungszeiten verlängert und Kosten erhöht. Mit No-Code-Lösungen und Fokus auf Orchestrierung lässt sich Generative AI dagegen vereinfachen und demokratisieren.
Der Schlüssel liegt darin, vortrainierte Modelle zu nutzen, schlanke Orchestrierungen zu bauen und sich auf geschäftliche Ergebnisse zu konzentrieren. Indem Unternehmen bestehende Teammitglieder weiterbilden und Werkzeuge wie entAIngine einsetzen, erreichen sie ihre KI-Ziele ohne die steile Lernkurve und die hohen Kosten eines eigenen Modelltrainings. No-Code-KI verändert die Spielregeln: Sie macht fortgeschrittene KI für mehr Innovatoren zugänglich und befähigt Teams, schnell und wirksam zu handeln.
In der Zukunft der KI kann jeder mitmachen und profitieren, unabhängig vom technischen Hintergrund. Mit No-Code-KI-Lösungen senken Unternehmen nicht nur Hürden, sondern sorgen auch dafür, dass Innovation von jedem und überall in der Organisation kommen kann. Dieser Wandel demokratisiert KI und ebnet den Weg für eine breitere, inklusivere Nutzung in allen Branchen.