IA générative no-code : comment les entreprises peuvent construire sans data scientists
20 janvier 2026
Ces derniers temps, je vois beaucoup d'entreprises pressées de « faire quelque chose avec l'IA générative » chercher de l'aide. Quand le besoin se précise, elles recherchent souvent des experts internes ou des freelances. À ma grande surprise, beaucoup cherchent des data scientists et des ML engineers, persuadées que c'est la clé pour tirer parti de l'IA générative.
Après plus d'une douzaine de projets d'IA générative livrés pour des ETI et des grands groupes, une chose est claire : beaucoup d'entreprises ne comprennent pas vraiment ce qui et qui est nécessaire pour réussir l'adoption de l'IA. Elles se trompent souvent sur les rôles requis et recrutent des spécialistes sans vérifier si ces rôles correspondent à leurs objectifs. Cette approche crée inefficacité et complexité inutile, et finit par freiner les progrès.
Dans cet article, j'examine ces difficultés et propose une autre approche. Plutôt que de miser lourdement sur les data scientists, je montre comment les solutions d'IA no-code permettent aux entreprises d'innover plus vite et plus efficacement. Grâce aux plateformes no-code, elles contournent de nombreux goulots d'étranglement classiques et réussissent plus directement avec l'IA générative.
Avant d'entrer dans l'IA générative, parlons des projets d'IA traditionnels et de leurs acteurs. Par projets traditionnels, j'entends ceux où l'on développe de zéro tout le pipeline d'un cas d'usage, y compris la construction du modèle, la préparation des données et le développement de l'application.
En général, ces projets ressemblent à ceci :
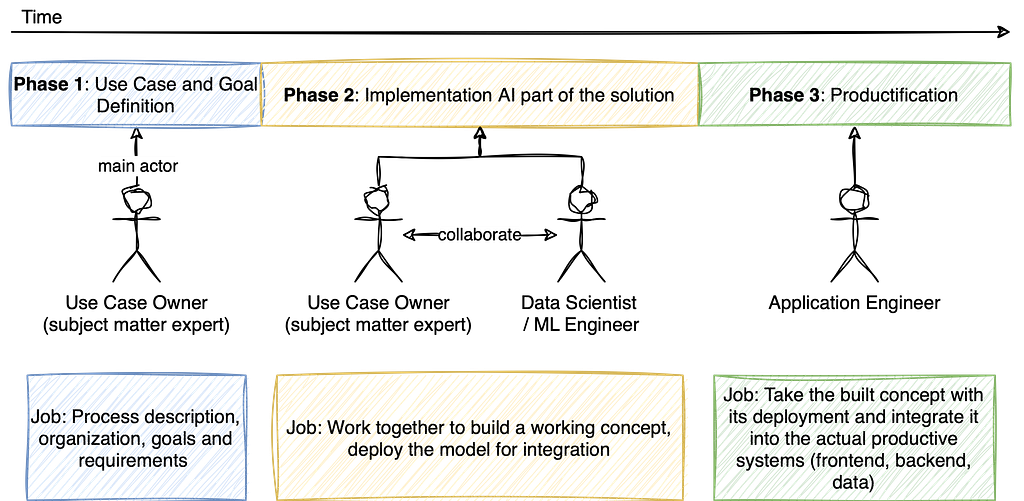
Illustration : projets d'IA classiques
Les projets d'IA traditionnels mobilisent plusieurs rôles pour mener une idée de la conception à la production. Les intitulés peuvent varier. Les descriptions que j'utilise ici se concentrent sur la fonction, quel que soit le titre selon l'organisation.
La première phase consiste à définir le problème et l'objectif. Les experts métier (SME) sont ici essentiels. Ils sont à l'origine de la définition du problème, détiennent la connaissance du domaine et expriment les besoins métier qui deviendront des exigences techniques. En tant que responsables du cas d'usage, ils savent très bien valider les résultats des solutions mises en place. Mais la plupart du temps, ils ne sont pas experts en IA et n'ont pas les réflexes de pensée par processus nécessaires pour concevoir une solution de bout en bout.
Les experts métier travaillent donc étroitement avec les data scientists pour déterminer les données nécessaires et les résultats attendus. Les data scientists traduisent les besoins métier recueillis auprès des experts en exigences techniques exploitables. Leur travail dépasse la construction de modèles : ils doivent comprendre pleinement le domaine, en tirer les enseignements utiles et obtenir les bonnes informations des experts.
Ils pilotent la phase suivante, la création de la solution. Les data scientists construisent et valident des modèles de machine learning, en se concentrant sur le feature engineering et le choix des algorithmes. Leur tâche principale est d'expérimenter et de s'assurer que le modèle résout efficacement le problème identifié. Ils travaillent aussi avec les data engineers et les ML engineers pour garantir que la solution est réalisable et évolutive.
Vient ensuite l'industrialisation, où les application engineers jouent un rôle clé. J'appelle application engineers les ingénieurs « classiques », sans compétence IA particulière, capables de réaliser frontends, backends et toute l'orchestration entre les deux (accès aux données, DevOps, etc.).
Ils récupèrent les modèles construits par le data scientist et les intègrent dans une application complète en production. Ils créent les interfaces et font du modèle d'IA une solution opérationnelle utilisable par les utilisateurs finaux. Chaque rôle compte pour la réussite du projet, mais la complexité et la dépendance aux spécialistes alourdissent les coûts et les délais. C'est là que l'IA no-code offre une alternative efficace.
Le malentendu du data scientist
Quand on me dit avoir besoin de data scientists pour se lancer dans la GenAI, je constate deux malentendus courants : 1) ce que l'on croit que fait un data scientist vs. ce qu'il fait réellement, et 2) ce que l'on croit nécessaire dans un projet d'IA générative vs. ce qui l'est réellement.
Commençons par 1). Les deux camemberts suivants illustrent très bien le problème.
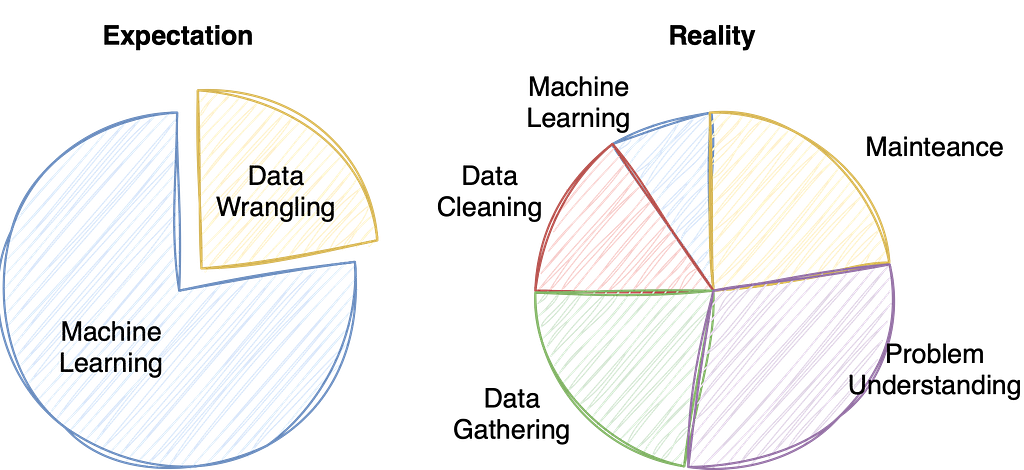
Tâches du data scientist : attentes vs. réalité
Le premier graphique montre ce que l'on imagine du travail d'un data scientist dans un projet d'IA générative. Beaucoup pensent qu'il passe l'essentiel de son temps sur les modèles : les concevoir, les implémenter et les tester, avec un peu de transformation de données. En réalité, une grande partie de son travail consiste à préparer les données et à comprendre les besoins métier, ce qui exige une collaboration intense avec les experts métier et les autres parties prenantes.
Le second graphique montre ce que fait réellement un data scientist. Moins de 25 % du temps va à la construction et à la validation des modèles. Plus de 30 % va à la compréhension du problème et à la coordination des parties prenantes, une dimension qui figure aussi dans la description d'autres métiers. L'essentiel du temps est consacré à la collecte des données et à la maintenance des modèles.
Gardez en tête ce constat sur l'emploi du temps réel d'un data scientist en abordant le point 2) : ce dont un projet d'IA générative a réellement besoin.
Le changement de paradigme des LLM : les modèles pré-entraînés
Les grands modèles de langage (LLM) sont entraînés sur d'immenses jeux de données collectés sur Internet. La plupart du temps, ces données sont librement accessibles à tous.
Quand les entreprises parlent d'utiliser l'IA générative, dans 95 % des cas elles n'entraîneront pas leurs propres modèles. Elles s'appuient sur des modèles pré-entraînés construits par d'autres organisations disposant d'énormes ressources de calcul. Les modèles pré-entraînés, comme GPT-4 d'OpenAI, sont conçus pour comprendre et générer des réponses proches de celles d'un humain, et peuvent être orchestrés dans des applications plus larges sans entraînement supplémentaire lourd. Ils servent de base au développement d'applications qui les utilisent via une API.
Les modèles pré-entraînés abaissent fortement la barrière d'entrée de l'IA générative. Les entreprises n'ont pas besoin de construire leurs propres modèles, ce qui exige souvent une équipe spécialisée, d'énormes volumes de données et beaucoup de puissance de calcul. Elles s'appuient sur des modèles prêts à l'emploi et peuvent se concentrer sur l'usage de l'IA pour résoudre des problèmes métier plutôt que sur la création de modèles. Surtout, construire son propre modèle coûte très cher.
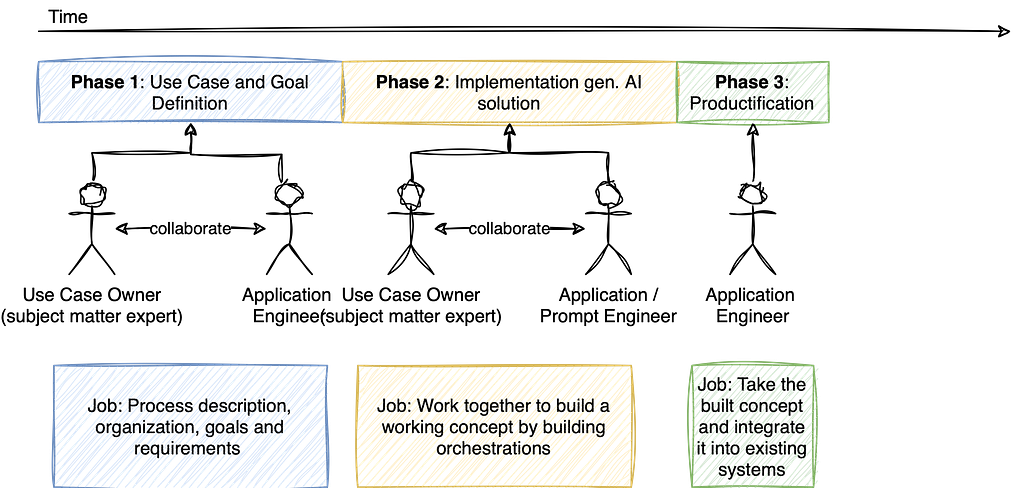
Illustration : mise en œuvre de projets d'IA générative
Les modèles pré-entraînés offrent des avantages décisifs, dont un délai de mise sur le marché réduit et des économies. Les entreprises les intègrent rapidement, sans longue phase de collecte de données et d'entraînement. Elles profitent aussi des progrès continus d'organisations comme OpenAI et Google. Elles peuvent ainsi se concentrer sur l'orchestration de ces capacités dans leurs processus existants et créer de la valeur sans investir massivement dans la data science.
Dans cette optique, voyons quelles tâches un projet GenAI exige réellement.
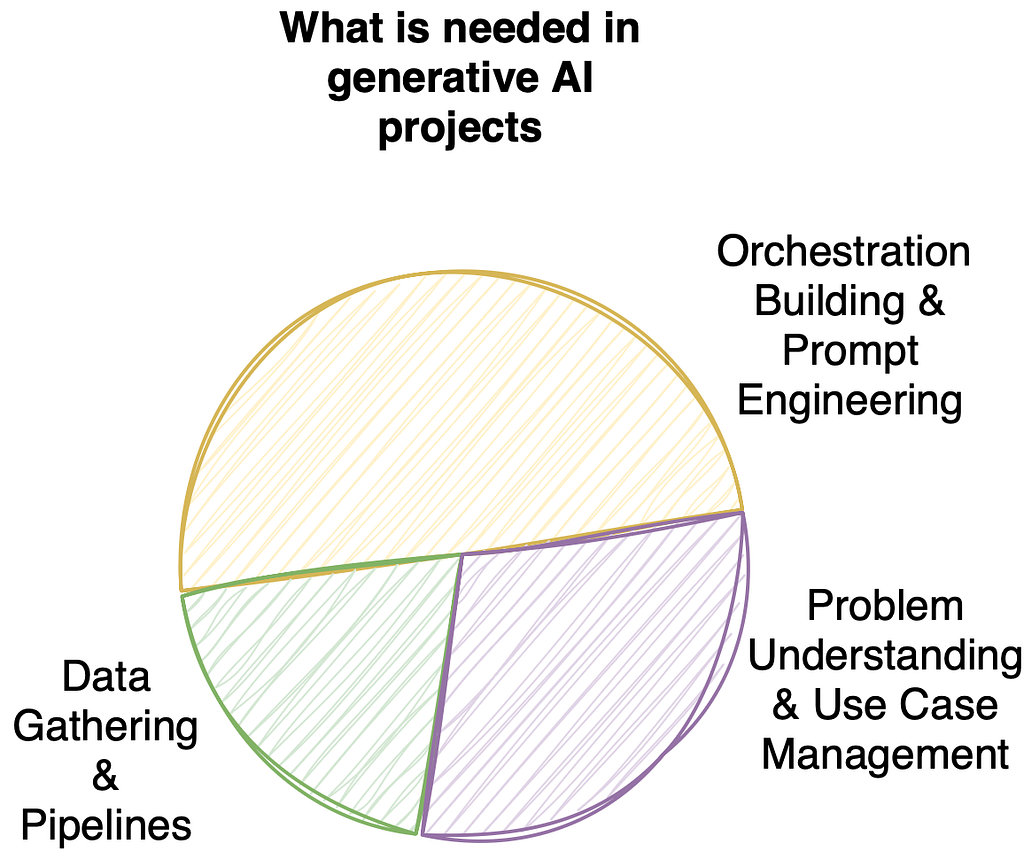
Ce dont un projet d'IA générative a besoin
L'essentiel du temps d'un projet d'IA générative est consacré à l'orchestration des modèles et au prompt engineering, puis à la compréhension du problème, à l'analyse des exigences et à la construction des pipelines de données. Orchestrer un modèle GenAI ne demande pas les mêmes compétences que construire un modèle de zéro. La plupart des modèles utilisés aujourd'hui sont accessibles via une API, une interface que n'importe quel développeur d'applications sait utiliser.
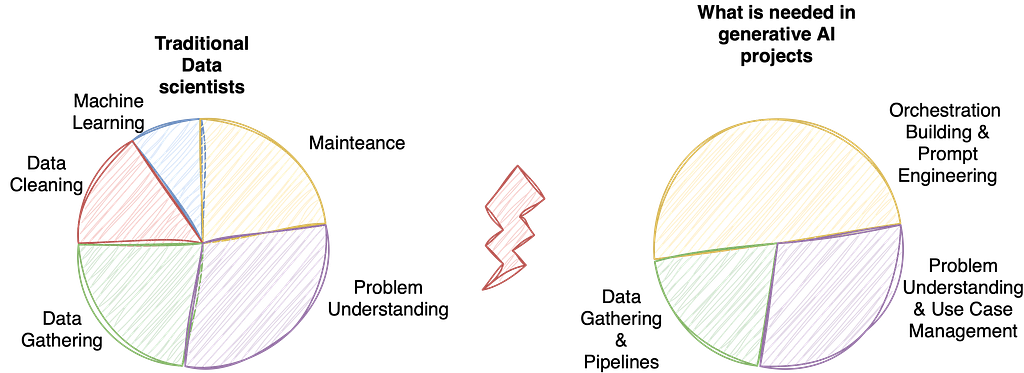
Le décalage : des projets d'IA générative avec des data scientists
Quand on affecte un data scientist à un projet d'IA générative, seule une petite partie de ses compétences est utilisée. Et d'autres compétences, absentes du rôle classique de data scientist, sont nécessaires, comme le prompt engineering et le développement itératif. Je ne plaide pas pour autant pour remplacer les data scientists par des prompt engineers, un terme utilisé de façon encore plus floue que celui de data scientist.
Une personne chargée de réaliser des applications d'IA générative de bout en bout doit en réalité savoir :
Ce profil ressemble bien plus à un développeur logiciel classique qu'à un data scientist. Notons aussi que pour la plupart des tâches liées à une application d'IA générative, les connaissances fondamentales approfondies des data scientists ne sont pas nécessaires.
Construire des applications d'IA générative consiste bien plus à intégrer et orchestrer au mieux des modèles existants qu'à construire (ou même comprendre) les détails en coulisses.
Je préfère donc confier un projet d'IA générative à un application engineer un peu formé à l'IA générative plutôt qu'à un data scientist. C'est mieux pour les coûts, l'efficacité et la vitesse.
L'orchestration est la clé : mettre l'IA au service de votre activité
En IA, l'orchestration consiste à créer des prompts en plusieurs étapes (chain-of-thought) qui réunissent données, modèles et logique en étapes maîtrisables. Il s'agit de structurer des workflows où différents composants, comme les sources de données, les modèles d'IA et la logique applicative, sont intégrés pour atteindre un résultat donné. En découpant les tâches complexes en unités plus petites, les outils d'orchestration rendent les systèmes d'IA plus efficaces.
On peut voir l'orchestration comme « assembler différents morceaux de tissu », par opposition à « tisser tous les tissus, les couper et les coudre », la métaphore de la construction d'un modèle de zéro.
L'avantage de l'orchestration est de masquer la complexité de la gestion des différents composants d'IA. Elle intègre simplement modèles pré-entraînés et services de données, ce qui permet aux équipes de se concentrer sur la valeur plutôt que sur les détails techniques de chaque modèle. C'est essentiel dans les projets d'IA générative, où connecter des modèles, appliquer de la logique et itérer rapidement sur les workflows conditionnent la réussite.
L'orchestration couvre les sujets suivants :
Une orchestration d'IA générative s'intègre aux systèmes existants pour produire un impact métier de bout en bout. Avec un peu de formation, les application engineers peuvent assurer toutes ces tâches.
IA no-code : donner les moyens aux équipes, au-delà des data scientists
En faisant coder des application engineers plutôt que des data scientists, nous avons réduit les coûts et les frictions de notre développement, et gagné en vitesse. Mais on peut aller plus vite encore.
Vous vous souvenez que l'orchestration repose toujours sur les mêmes composants que l'on « assemble » ? Ce sont des cas d'usage parfaits pour les plateformes no-code ou low-code.
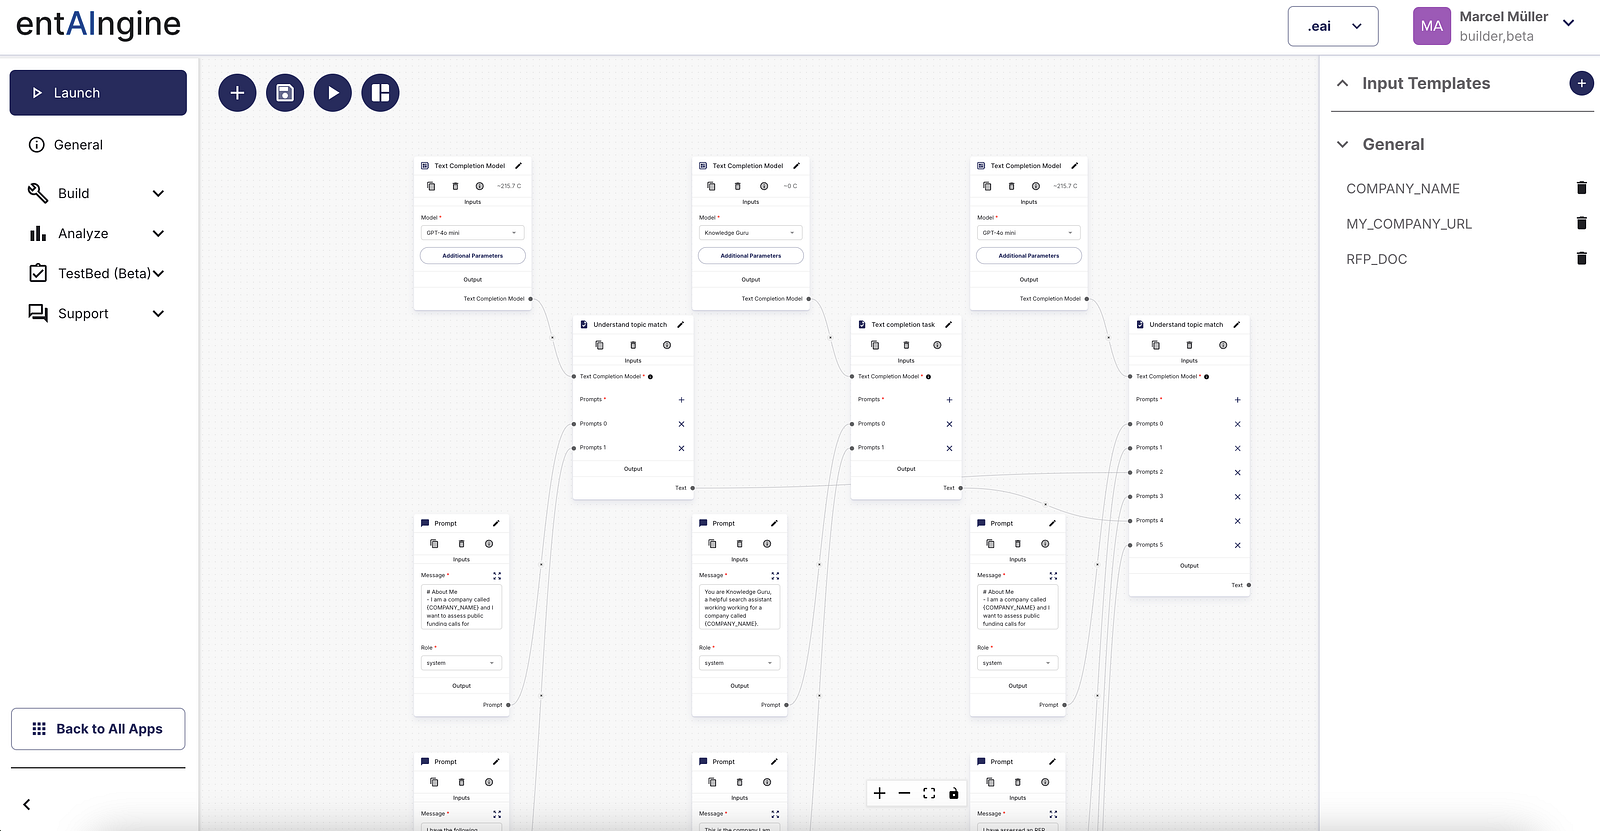
Construire des processus en no-code avec l'IA générative
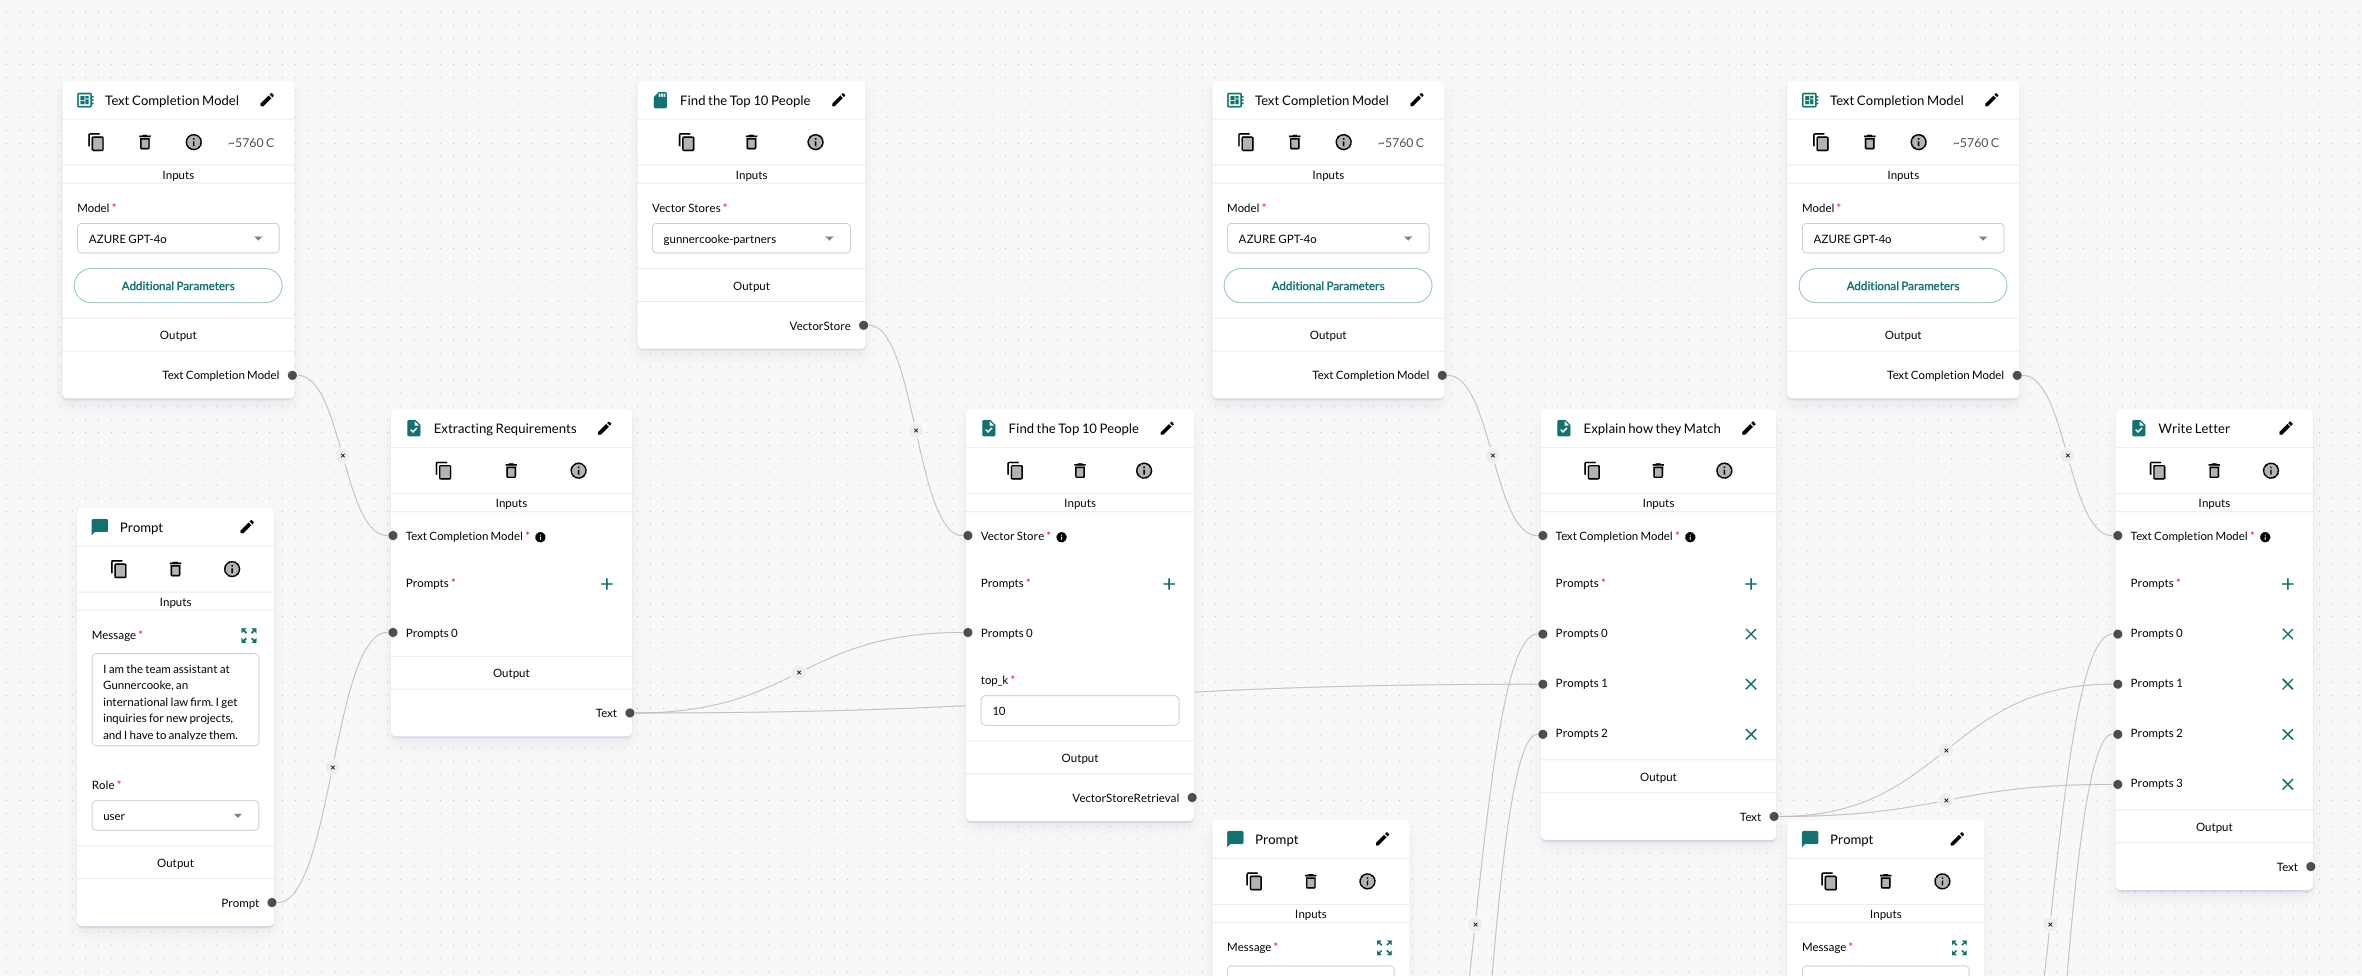
Avec entAIngine, nous construisons une plateforme standard où vous connectez vos données et vos structures de gouvernance existantes et définissez des orchestrations. Nous voyons ces orchestrations comme des modèles de processus : une suite d'étapes qui reçoivent différentes entrées. Exemple : nous voulons une orchestration qui reçoit une demande de projet par e-mail, trouve les bonnes personnes pour ce projet et rédige une réponse. D'abord, un LLM extrait les exigences de l'e-mail. Ensuite, nous faisons du Retrieval-Augmented Generation (RAG) pour trouver dans l'entreprise les personnes qui correspondent, par recherche sémantique dans une base vectorielle. Enfin, un LLM rédige un e-mail de réponse à partir des informations récupérées.
Je suis un fervent partisan de traiter toute application d'IA comme une suite de processus métier assistés par l'IA. Nous construisons des « plans » (modèles de processus) avec des variables qui changent d'un cas à l'autre (dans l'exemple, le texte de l'e-mail). À chaque nouveau cas (un nouvel e-mail entrant), nous renseignons les variables avec les données du cas et exécutons le modèle de processus.
Toute personne capable de penser en processus peut appliquer ce principe. Apprendre à utiliser des bases de connaissances avec le RAG, à obtenir des résultats fiables et reproductibles et à optimiser les coûts des modèles demande un apprentissage, mais selon moi, cela n'exige pas les compétences d'un data scientist.
Une approche no-code couvre beaucoup des tâches nécessaires pour construire des applications d'IA générative, mais pas toutes. Les tâches spécifiques comme l'intégration de systèmes existants ou les personnalisations nécessitent toujours un application engineer. Mais dans la plupart des cas, la partie essentielle peut être réalisée avec des plateformes no-code comme entAIngine par des personnes à l'aise avec la technique et habituées à penser en processus, quels que soient leur titre ou leur parcours.
Un avenir où l'IA appartient à tous
L'IA générative offre un potentiel immense, mais la manière de la mettre en œuvre fait toute la différence. En s'appuyant moins sur les data scientists et davantage sur les plateformes no-code, les entreprises libèrent la puissance de l'IA de façon économique et efficace. Les projets d'IA traditionnels exigent souvent des rôles spécialisés, ce qui allonge les délais et augmente les coûts. Avec des solutions no-code et un accent sur l'orchestration, l'IA générative peut au contraire être simplifiée et démocratisée.
La clé : s'appuyer sur des modèles pré-entraînés, construire des orchestrations simples et viser des résultats métier. En formant les équipes existantes et en utilisant des outils comme entAIngine, les entreprises atteignent leurs objectifs d'IA sans la courbe d'apprentissage abrupte ni les coûts élevés d'un entraînement de modèle en interne. L'IA no-code change la donne : elle rend l'IA avancée accessible à davantage d'innovateurs et permet aux équipes d'agir vite et bien.
L'avenir de l'IA est un avenir où chacun, quel que soit son profil technique, peut participer et en bénéficier. En adoptant l'IA no-code, les entreprises abaissent les barrières et permettent à l'innovation de venir de n'importe qui, n'importe où dans l'organisation. Ce changement démocratise l'IA et ouvre la voie à une adoption plus large et plus inclusive dans tous les secteurs.