Die KI-Pyramide: Wie weit öffentliche Modelle tragen und warum Unternehmen hinterherhinken
14. Oktober 2026
Unternehmen liegen ein bis anderthalb Jahre hinter Freelancern, und wie die öffentlichen Frontier-Modelle genutzt werden, zählt mehr als der Zugang zu bestimmten Modellen
Bild vom Autor.
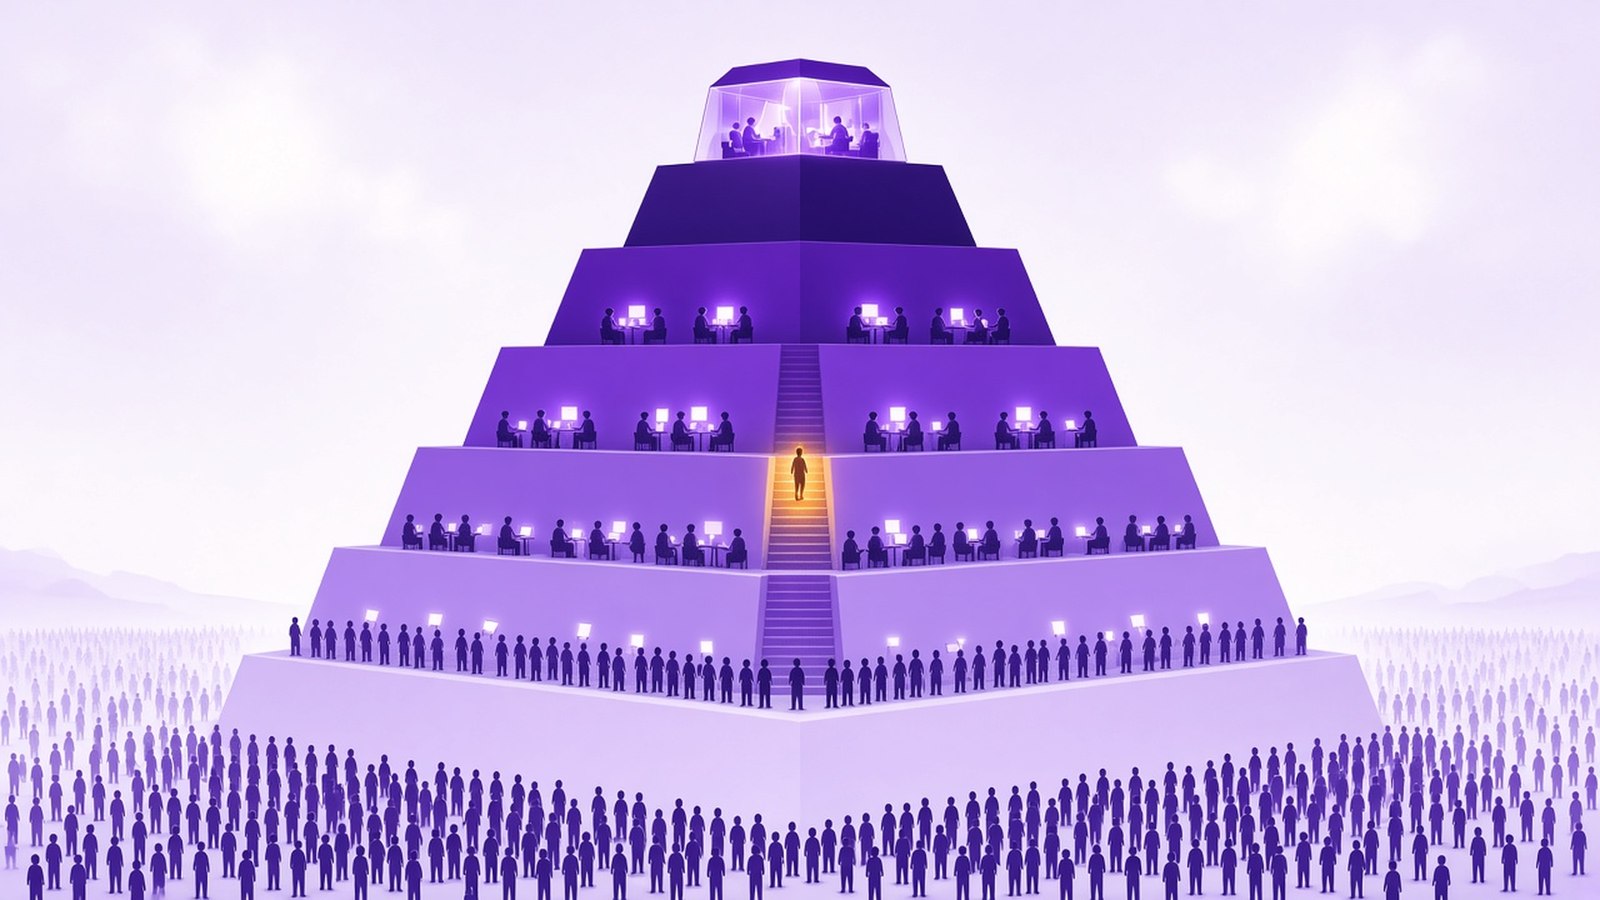
Menschen nutzen KI auf sehr unterschiedlichen Ebenen, und von unten nach oben betrachtet sieht das ziemlich genau wie eine Pyramide aus: unten sehr viele Menschen, die KI noch nie wirklich genutzt haben, und oben eine winzige Gruppe, die mit Modellen arbeitet, an die sonst niemand herankommt. In meiner Arbeit sehe ich, dass die öffentlichen Frontier-Modelle, die heute verfügbar sind, schon sehr weit tragen, eigentlich bis kurz unter die Spitze, und wo jemand auf dieser Pyramide landet, hängt viel stärker davon ab, wie diese Modelle genutzt werden, als davon, welchen Zugang es gibt. Darum ging es auch in einer Diskussion, die Andrej Karpathy diese Woche in den sozialen Medien angestoßen hat [1], und sie hat in wenigen Tagen Millionen Aufrufe bekommen. Ich finde, in den meisten Punkten hat er recht. Deshalb gehe ich seinen Beitrag hier Ebene für Ebene durch und ergänze meine Sicht, denn ich sehe die Form etwas anders als er, mit einer Spitze, die sich in zwei Teile aufteilt.
Karpathy schreibt, die Kluft sei inzwischen „less 'two groups of people speaking past each other' and more a sharp funnel“, also weniger zwei Gruppen, die aneinander vorbeireden, als ein scharfer Trichter. Seine einfache Rechnung sieht so aus. Rund 6 Milliarden Menschen „have barely come in contact with LLMs at all“, sind also kaum mit LLMs in Berührung gekommen. Rund 1 bis 2 Milliarden sind „casual and infrequent users of free-tier ChatGPT-like products“, gelegentliche Nutzer kostenloser ChatGPT-ähnlicher Produkte. Diese Gruppe „sees derpy chatbots and treats them a bit like a better Google search“, sieht also etwas tollpatschige Chatbots und behandelt sie wie eine bessere Google-Suche. Dazu zählt er auch „even many professionals outside of math&code“, viele Fachleute außerhalb von Mathematik und Programmierung, Führungskräfte eingeschlossen, die das Thema intellektuell verstehen, aber nur aus zweiter Hand. Dann kommen rund 20 Millionen Menschen, die Frontier-LLMs beruflich in Mathematik und Programmierung nutzen und „see first-hand that large, complex projects that used to take them weeks/months can now be completed by agents with a prompt“, also selbst erleben, wie Agenten große Projekte, die früher Wochen oder Monate dauerten, mit einem Prompt erledigen. Ganz oben stehen bei ihm die rund 5.000 Menschen „with access to frontier-grade systems internally“, mit internem Zugang zu Spitzensystemen, wo es nach „swarms of thousands of agents collaborating over weeks on software mega projects“ aussieht, nach Schwärmen von Tausenden Agenten, die wochenlang an riesigen Softwareprojekten zusammenarbeiten [1].
Er erklärt auch, warum der Trichter diese Form hat. Am nützlichsten finde ich dabei, dass die Fähigkeiten dort ihren Höhepunkt erreichen („peaks“), wo die Arbeit digital ist, automatisch überprüft werden kann und den Labs zusätzlich Geld bringt, und zwar über die bloße Frage hinaus, auf welcher Zugangsstufe jemand steht.
Dem meisten, was Karpathy sagt, stimme ich zu. Ich würde es nur eine Pyramide unterschiedlicher Nutzer nennen, weil jede Ebene eine kleinere Gruppe ist, die auf der darunter steht, und den letzten Teil seines Trichters würde ich zweiteilen. Für mich gibt es einen echten Unterschied zwischen den Menschen, die die aktuellen öffentlichen Frontier-Modelle nutzen, und den Menschen in den Labs, die interne Mega-Modelle in Richtung AGI nutzen. AGI heißt hier einfach: Modelle, die deutlich stärker sind als alles, worauf die Öffentlichkeit Zugriff hat, wie auch immer man das nennen will. So entstehen fünf Ebenen, die ich im Folgenden von unten nach oben durchgehe.
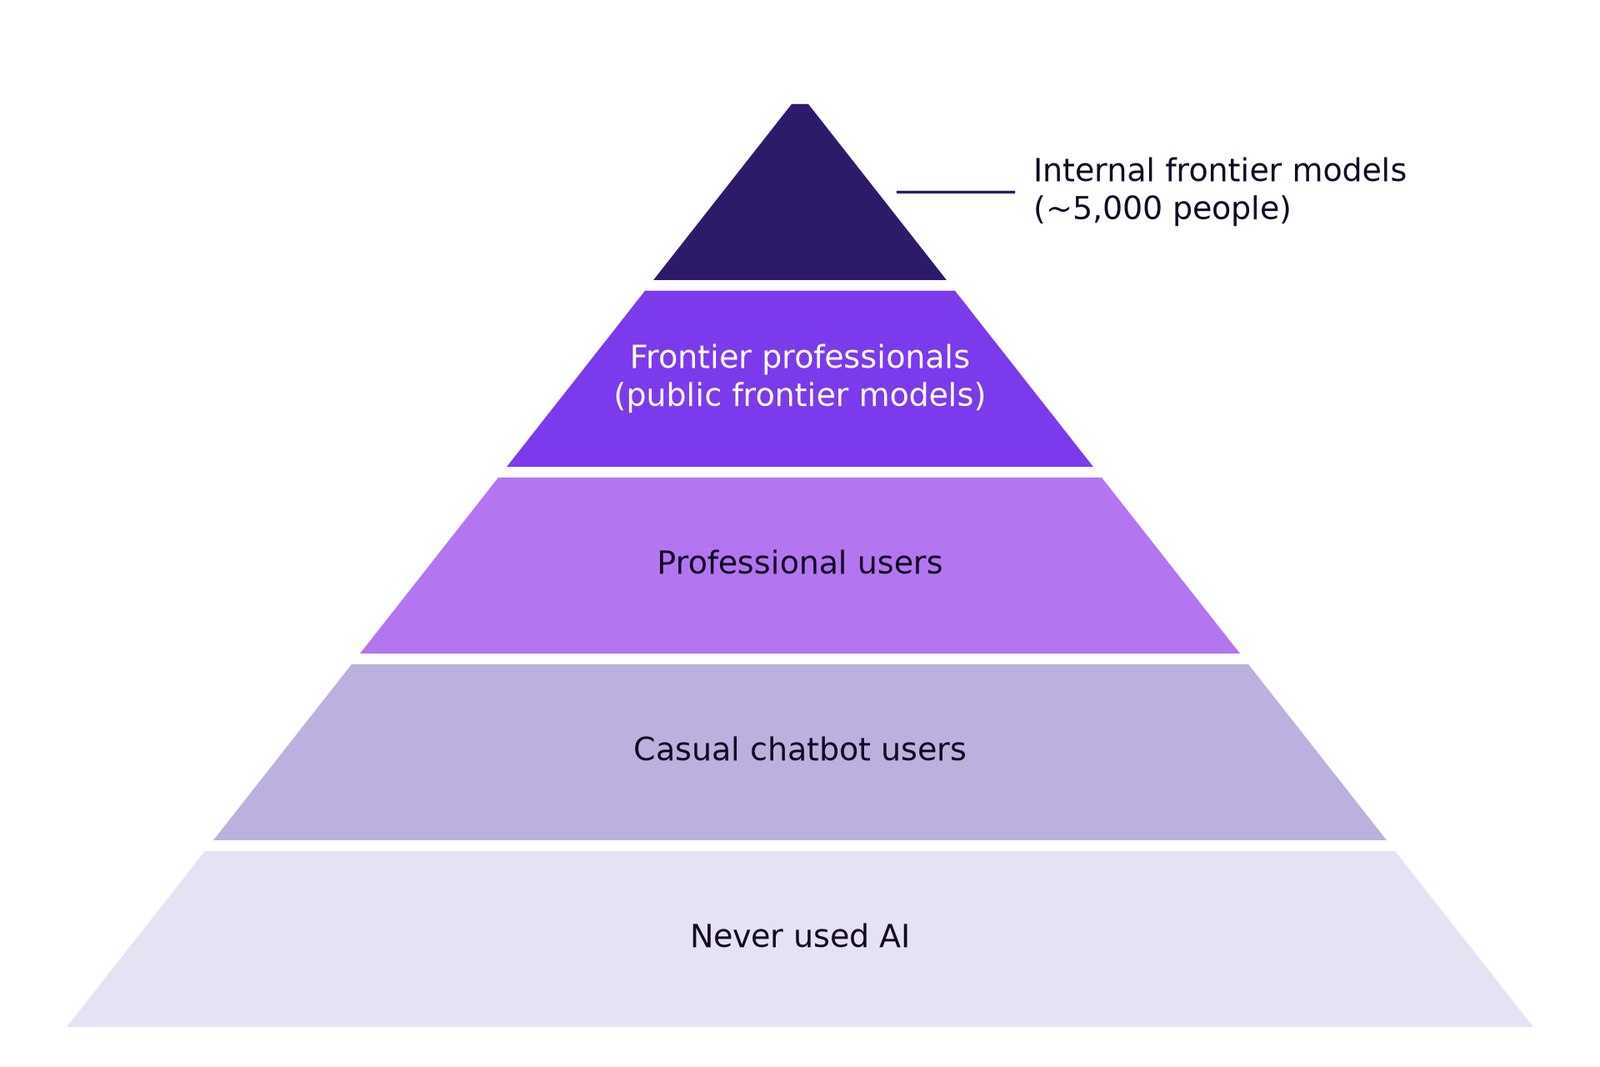
Bild vom Autor.
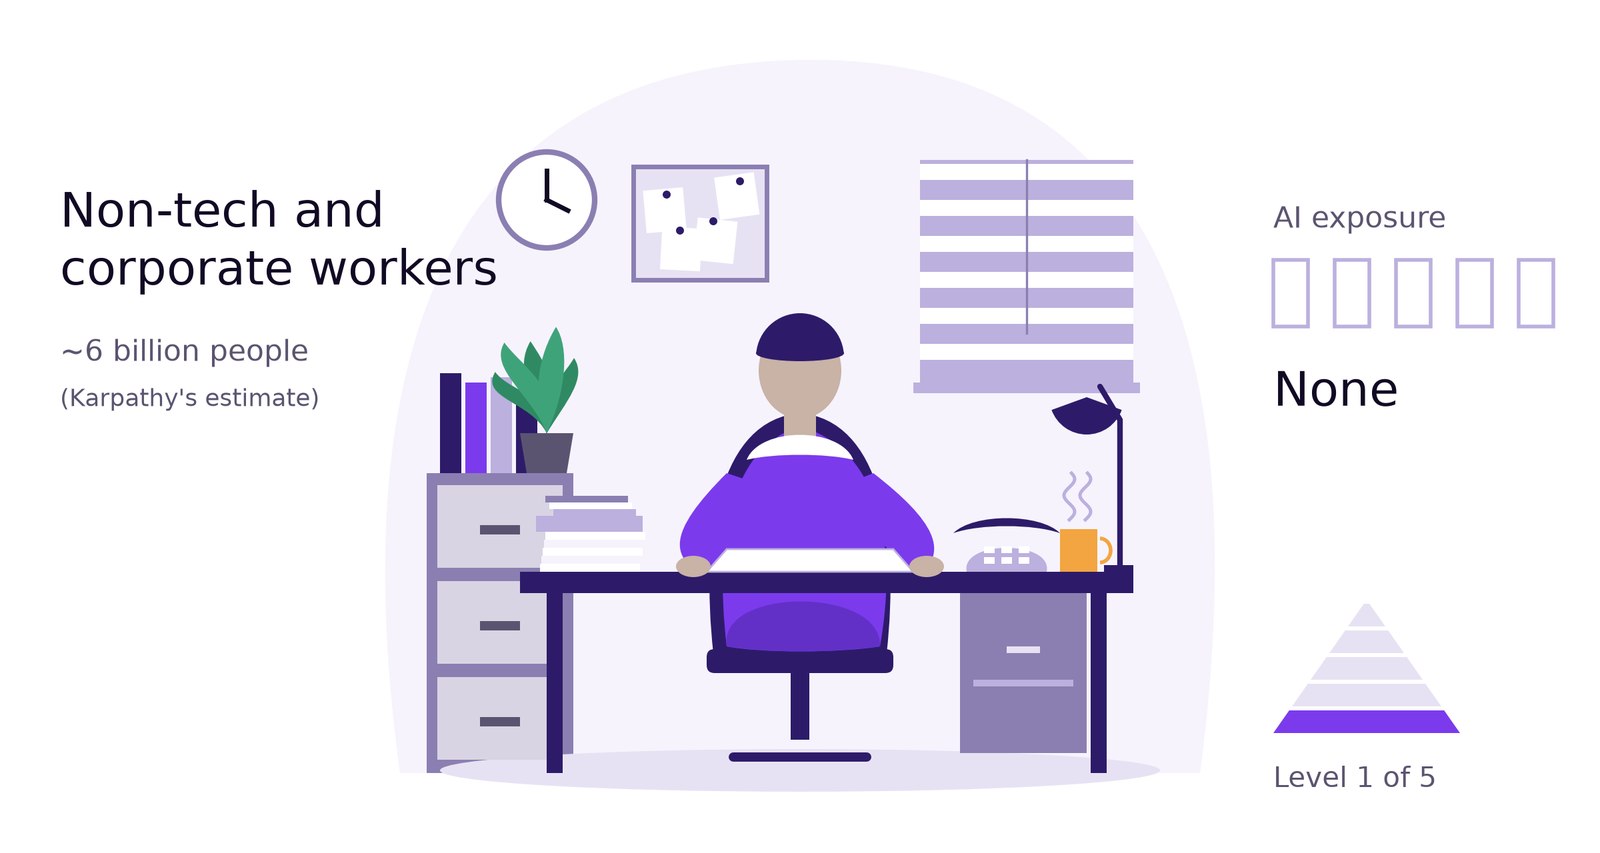
Bild vom Autor.
Ich komme ursprünglich nicht aus der Tech-Welt. Ich bin in einer Bäckerei in einer sehr ländlichen Gegend Deutschlands aufgewachsen, und diese sehr kleine Bevölkerung nehme ich hier als Beispiel. Gerade bei den normalen Jobs dort, nicht bei den besser bezahlten, sind die Menschen meist noch überhaupt nicht damit in Berührung gekommen. Ich rede nicht von Jobs, mit denen man hunderttausend Euro verdient, und zur Einordnung: Hunderttausend Euro sind im ländlichen Deutschland sehr viel Geld. Im Silicon Valley vielleicht nicht, aber da, wo ich herkomme, schon. Was die Menschen dort über KI wissen, stammt meist aus der Boulevardpresse, aus der Bild-Zeitung, mit all dem KI-Wahnsinn und den KI-Drohnen, und deshalb sind sie davon ein bisschen eingeschüchtert, was ich ehrlich gesagt verstehe.
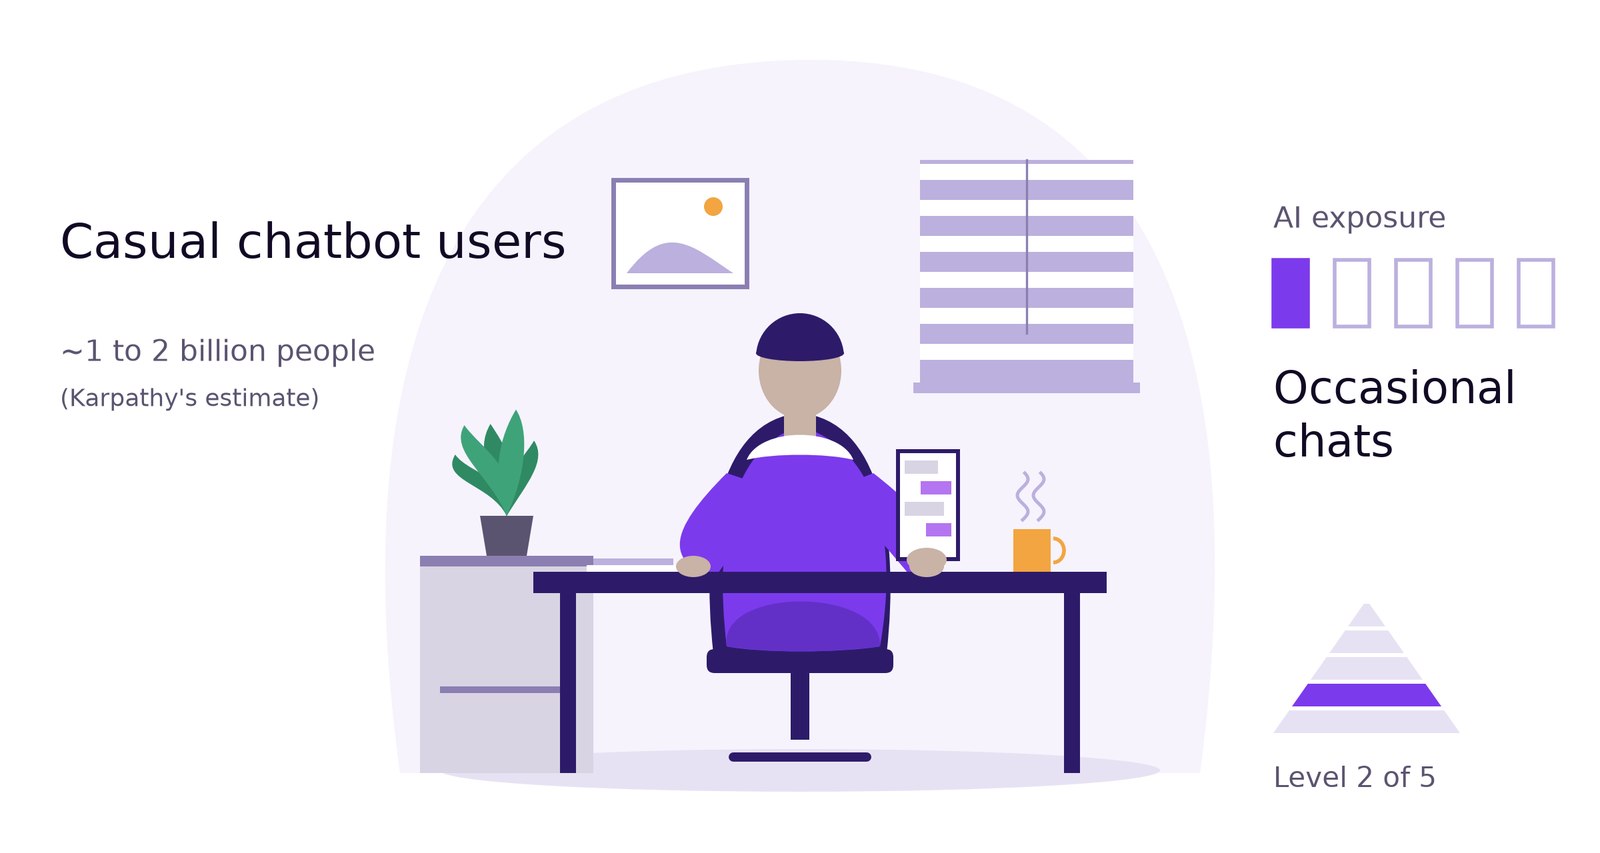
Bild vom Autor.
Dann gibt es eine ganze Reihe Menschen, meist in ihren Dreißigern oder Vierzigern, die irgendwann einmal ChatGPT genutzt haben. Wenn es nur um ChatGPT geht, würde ich auch sagen, dass etwa 20 % der Menschen in meiner Heimatregion das schon gemacht haben, was nah an Karpathys Zahl liegt. Das ist natürlich meine eigene anekdotische Stichprobe, und in meinem normalen sozialen Umfeld sind viele Menschen aus dem Hightech-Bereich, also ist das weit weg von der Weltbevölkerung. Aus meiner Herkunft heraus wirkt es aber einigermaßen plausibel. Für die meisten von ihnen ist KI der tollpatschige Chatbot, den Karpathy beschreibt, etwas, dem sie einmal ein paar Fragen gestellt haben.
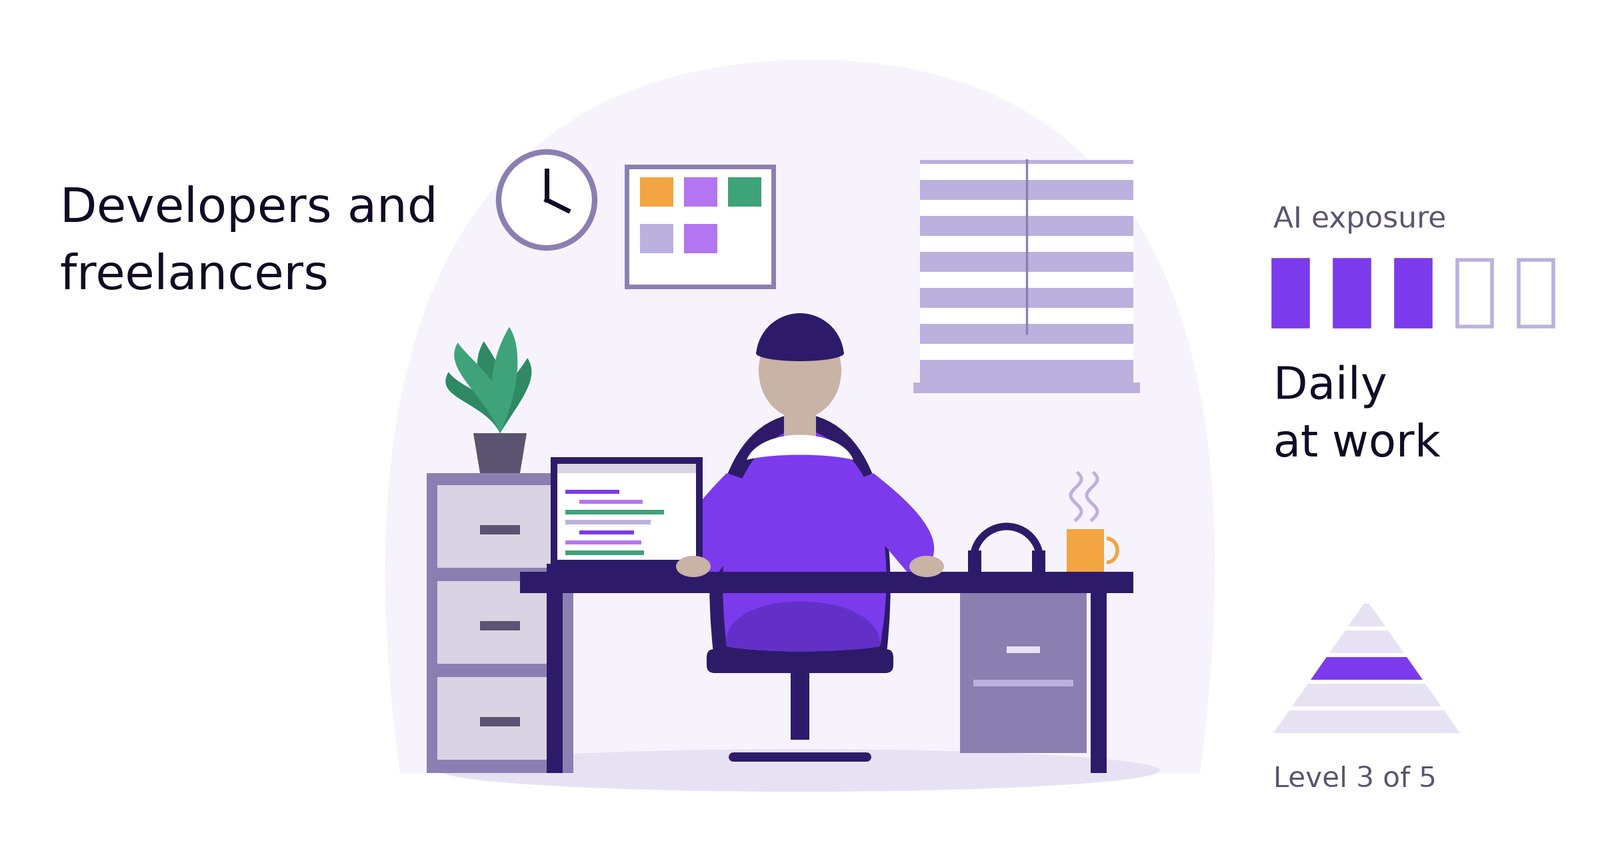
Bild vom Autor.
Die dritte Ebene sind professionelle Nutzer. Ich habe täglich mit vielen Entwicklern und Programmierern zu tun, und die guten haben in der Regel alle schon LLMs genutzt und werden Schritt für Schritt richtig gut darin, zumindest beim Programmieren. Ich verbringe auch viel Zeit mit Freelancern, und wenn sie keine Einschränkungen haben, legen sie einfach los, nutzen es und finden gute Einsatzgebiete dafür. Sie müssen nicht erst fünfzehn verschiedene Kurse und irgendein Weiterbildungsprogramm durchlaufen, sondern lesen Artikel und probieren Dinge aus, bis sie dort sind, wo sie Nutzen daraus ziehen. Für mich ist das einer der Kernpunkte in diesem ganzen Thema, der große Unterschied zwischen Unternehmen auf der einen Seite und Startups und Selbstständigen auf der anderen.
Ich mache viele Beratungsprojekte mit JadenX, auch für größere Unternehmen, und dabei habe ich gesehen, dass die Menschen in Unternehmen und regulierten Unternehmen meist ein bis anderthalb Jahre zurückliegen, sowohl bei den Tools als auch darin, wie gut sie sie beherrschen, verglichen mit den absoluten Cracks in meinem Alltag, meinen Leuten auf X und meinen Freunden. Und dabei vergleiche ich sie noch nicht einmal mit den 5.000 ganz oben, sondern mit guten Leuten, die diese Modelle in ordentlichem Umfang nutzen und einen Mehrwert daraus ziehen.
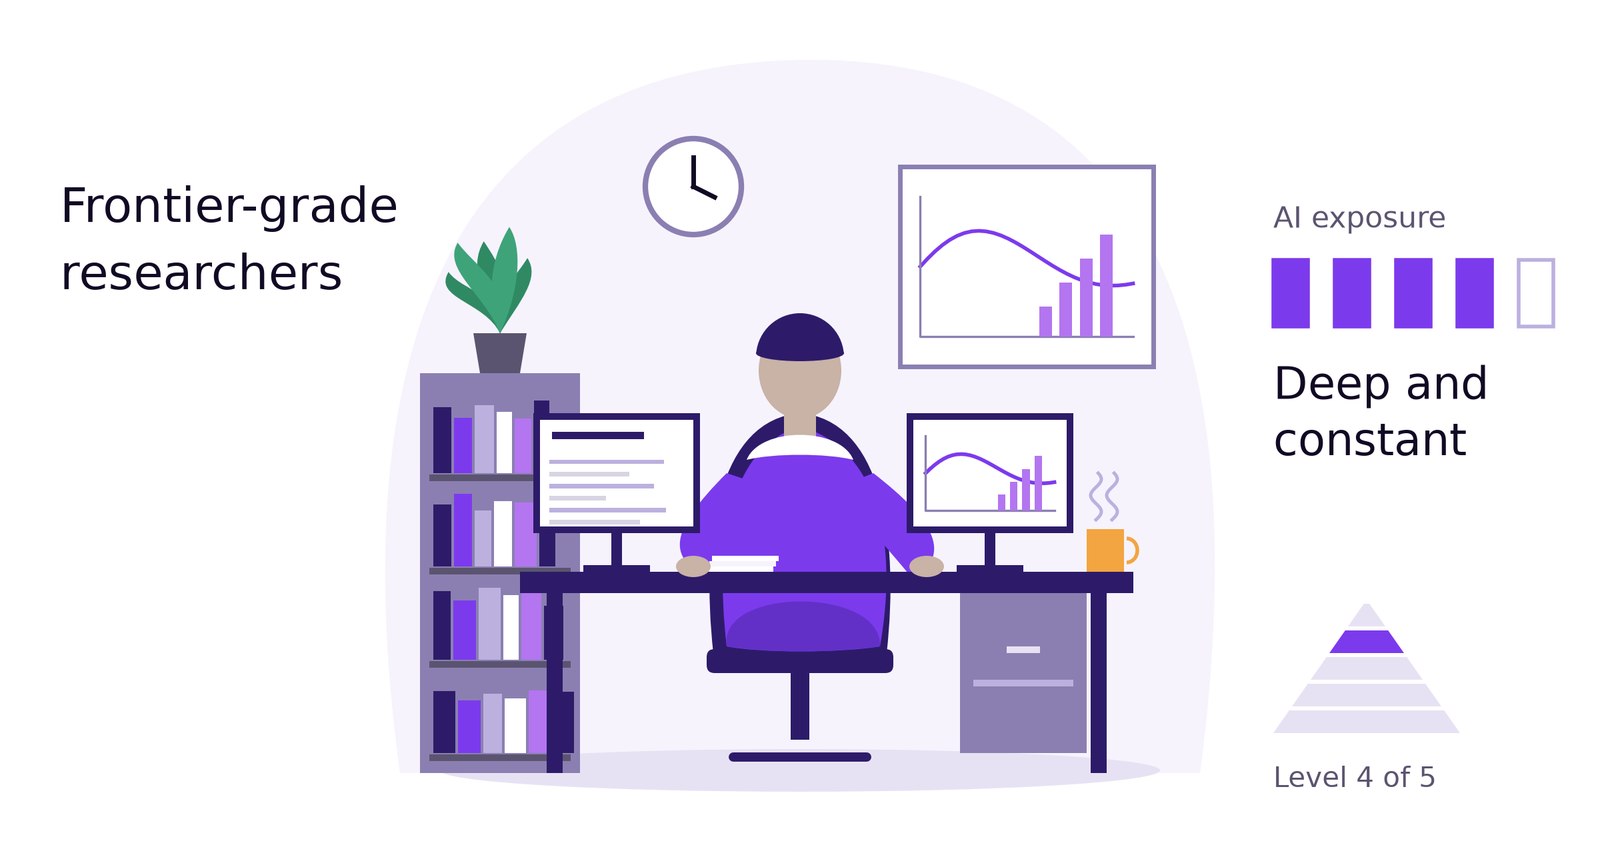
Bild vom Autor.
Karpathys oberste Ebene ist dort, wo die riesigen Softwareprojekte entstehen, die Zero Days (Sicherheitslücken, die noch niemand gefunden und geschlossen hat), Cyberangriffe und Abwehr in Maschinengeschwindigkeit und neue Wissenschaft. Es gibt aber auch Menschen, die mit LLMs echte Spitzenforschung betreiben, ohne in einer dieser großen Organisationen zu sein, und das ist die Ebene, die ich ergänzen würde. Ich habe einen akademischen Hintergrund, und in meinem Netzwerk gibt es einige Menschen, die andere in der Wissenschaft bei Qualität und Tempo komplett abhängen, weil sie LLMs schnell in ihre wissenschaftlichen Arbeitsabläufe einbauen können. Ich rede nicht von Slop-Papers, also minderwertigen Texten, die ein Modell ausgespuckt hat, in ChatGPT zusammengebaut und dann ohne Sinn bei Fachzeitschriften eingereicht. Ich meine Menschen, die diese Modelle in ihrer Forschung richtig einsetzen, und das ziemlich erfolgreich, während die anderen 80 % in diesen Bereichen meist sagen: Oh nein, das kann ich nicht.
Meiner Meinung nach ist das bei den Sozialwissenschaften oder sogar bei der Informatik auf Anwendungsebene meist kein KI-Problem, denn die öffentlich verfügbaren Modelle reichen dort für Spitzenforschung aus. In vielen Bereichen der heutigen Wissenschaft, in denen statistisch gearbeitet wird, gibt es gerade einen großen Nutzen, wenn die Modelle richtig eingesetzt werden. Ich schreibe selbst kaum noch Papers, aber ich stehe mit vielen Menschen in Kontakt, die das tun und etwas davon haben.
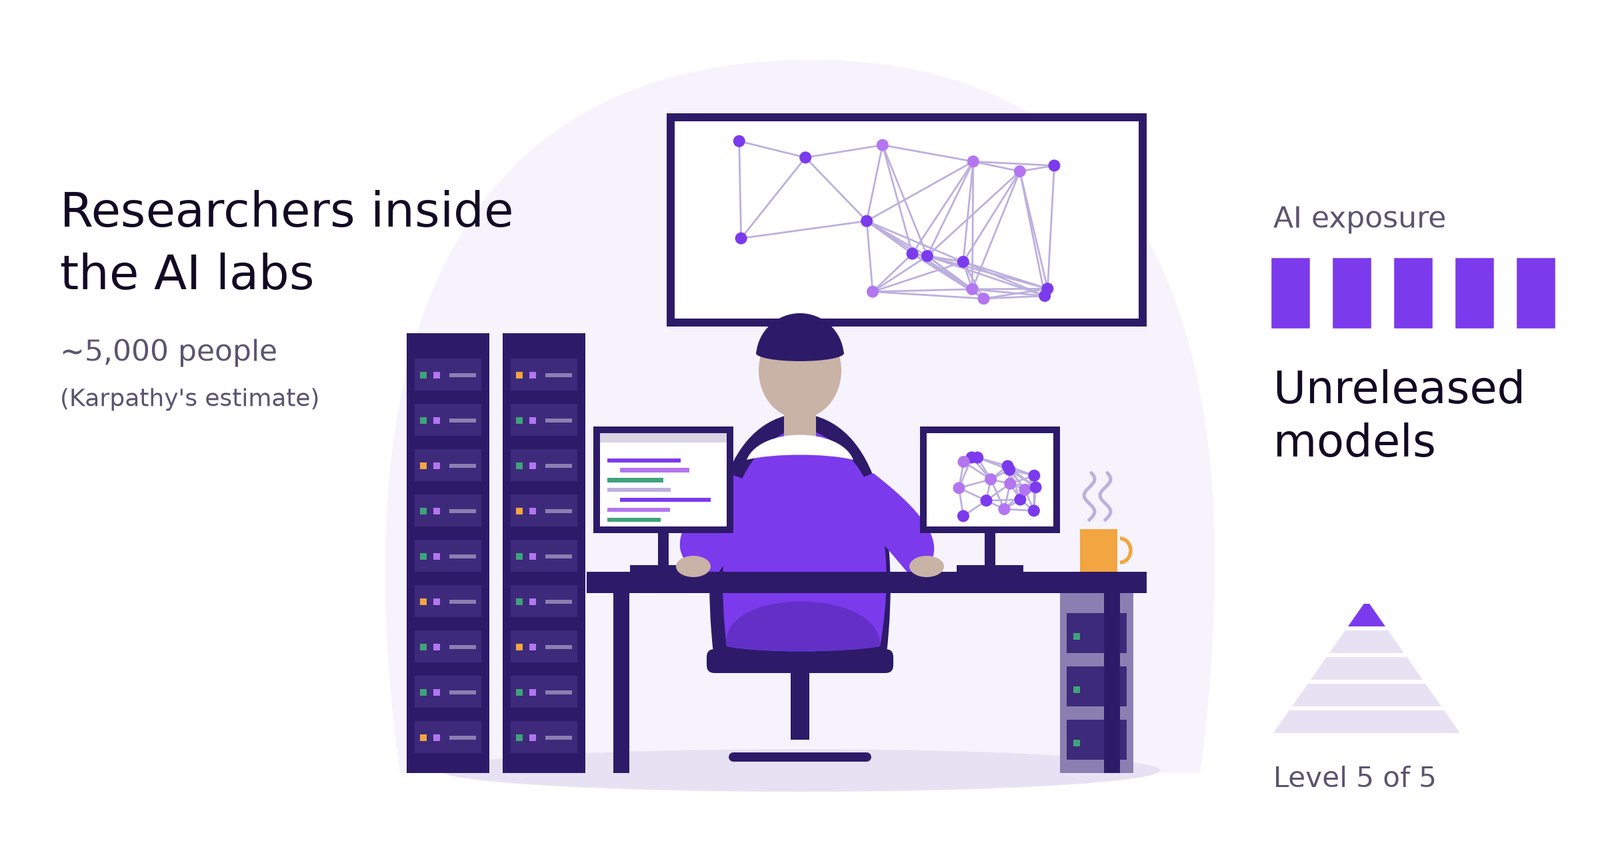
Bild vom Autor.
Dann gibt es die absolute Spitze, die rund 5.000 Menschen, von denen Karpathy spricht und die die besten Modelle der Welt haben, interne Mega-Modelle in Richtung AGI. Wer P vs NP lösen will, eines der großen offenen Probleme der Informatik, oder Zero Days in großem Maßstab finden will, braucht natürlich stärkere Modelle als die öffentlichen. Dieser Teil ist real, und ich sage nicht, dass Karpathy damit falsch liegt. Ich glaube nur, dass der größte Teil der Arbeit, die im Alltag wirklich zählt, eine Ebene darunter stattfindet.
Was ich wirklich allen empfehlen möchte, ist, auf die vorletzte Ebene hinzuarbeiten. Auf den Zugang zu bestimmten Modellen hat man keinen Einfluss, der liegt leider in den Händen sehr weniger zentraler Akteure, und auch Regierungen und Politik spielen da hinein. Aber es gibt sehr, sehr leistungsfähige Modelle, die sich heute in Arbeitsabläufen und in der Wissenschaft einsetzen lassen, um die Welt ein Stück besser zu machen, so seltsam das klingt. Also sollte man sie nutzen und dort hinkommen, nichts spricht dagegen. Ja, die größten Sicherheitslücken der Welt wird man damit wahrscheinlich nicht vor allen anderen finden, aber wissenschaftliche Wirkung auf sehr gutem Niveau ist möglich, und dasselbe gilt für die tägliche Arbeit.
Wer darüber sprechen möchte, wo man selbst oder das eigene Unternehmen auf dieser Pyramide steht, meldet sich einfach bei mir über JadenX.
[1] Andrej Karpathy, Beitrag auf X über die wachsende Kluft im gemeinsamen Verständnis der Fähigkeiten von LLMs, 11. Okt. 2026. https://x.com/karpathy/status/2109361546505966046. Am 14. Okt. 2026 hatte er rund 6,35 Millionen Aufrufe und 42.800 Likes, und die Hacker-News-Diskussion [2] hatte 716 Punkte. Karpathys eigene Anteile an der Weltbevölkerung, die er als Überschlagsrechnung bezeichnet: rund 75 % für die 6 Milliarden, rund 20 % für die 1 bis 2 Milliarden, 0,2 % für die 20 Millionen und rund 0,00006 % für die 5.000.
[2] Hacker-News-Diskussion zum Beitrag, abgerufen am 14. Okt. 2026. https://news.ycombinator.com/item?id=50047422
Über diesen Artikel: Ich habe meine Sicht auf Karpathys Beitrag diktiert, und ein KI-Agent hat das Diktat in diesen Entwurf verwandelt, den ich anschließend überarbeitet habe. KI-Agenten haben auch bei der Recherche geholfen und den Beitrag, die Hacker-News-Diskussion und die Engagement-Zahlen zusammengetragen. Die Meinungen sind meine eigenen. Dieser Text wurde aus dem englischen Original übersetzt.
Dieser Artikel erschien zuerst auf Medium.
Wer herausfinden möchte, wo das eigene Team auf dieser Pyramide steht, oder mit öffentlichen Frontier-Modellen einen echten Unterschied in den eigenen Prozessen erreichen will, erreicht mich über JadenX.