La pyramide de l’IA : jusqu’où mènent les modèles publics et pourquoi les entreprises sont à la traîne
14 octobre 2026
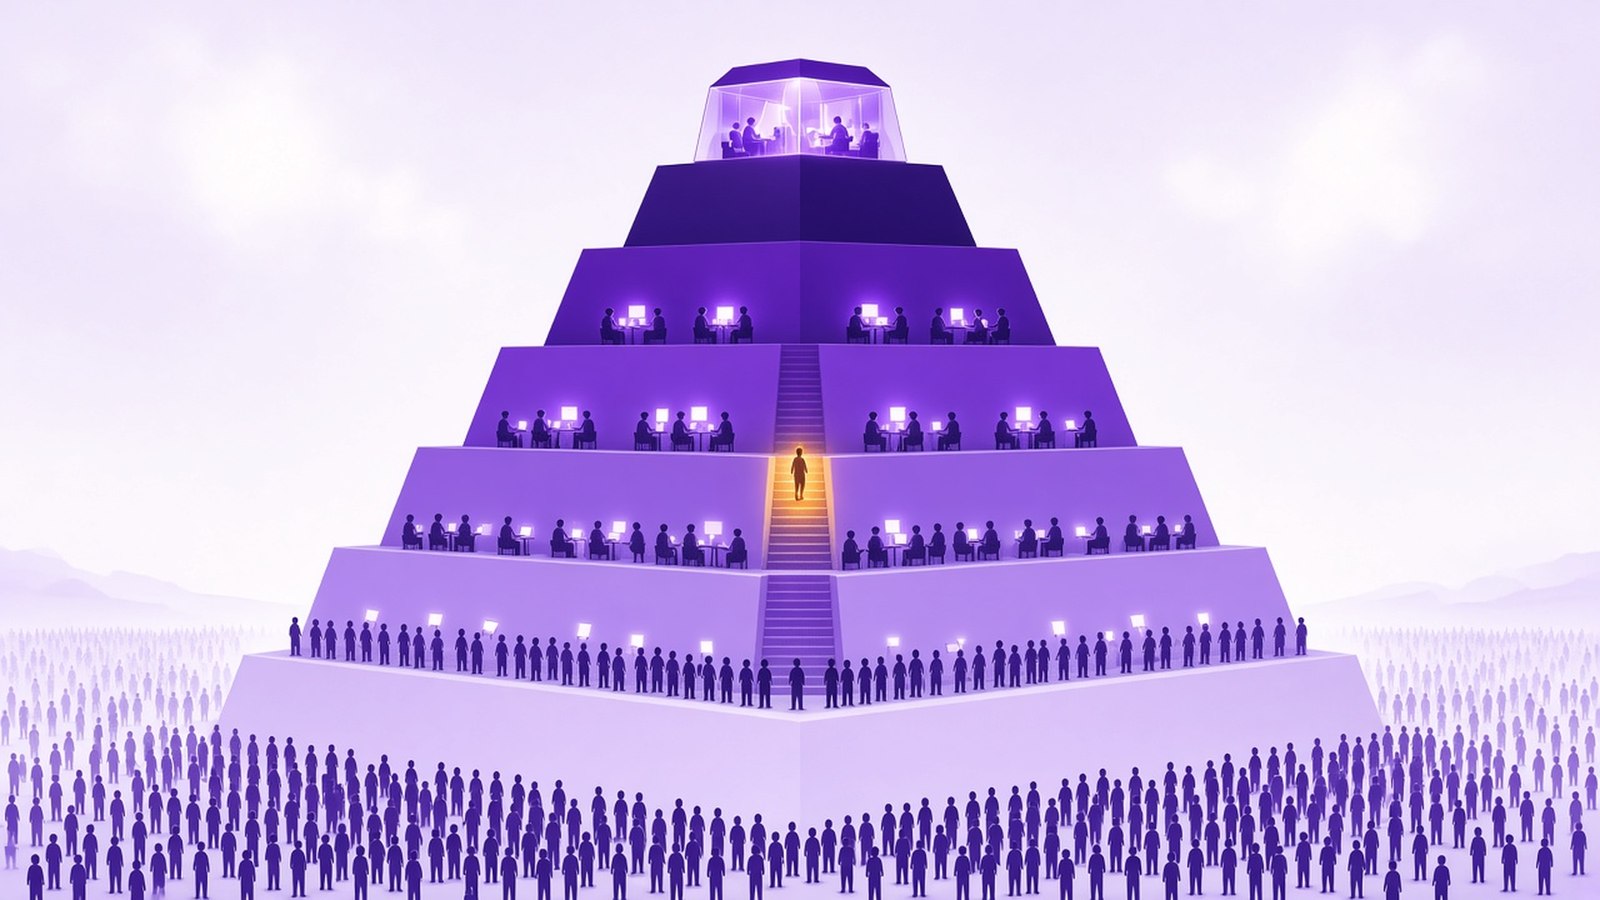
Les entreprises ont un an à un an et demi de retard sur les freelances, et la façon dont vous utilisez les modèles frontière publics compte plus que les modèles auxquels vous avez accès
Image de l’auteur.
Les gens utilisent l’IA à des niveaux très différents, et vu du bas vers le haut, cela ressemble beaucoup à une pyramide, avec en bas une foule de personnes qui ne l’ont jamais vraiment utilisée et tout en haut un tout petit groupe qui travaille avec des modèles auxquels personne d’autre n’a accès. Ce que je constate dans mon travail, c’est que les modèles frontière publics que vous pouvez utiliser aujourd’hui vous mènent déjà très loin, presque au sommet en fait, et votre place sur cette pyramide dépend bien plus de la façon dont vous utilisez ces modèles que de l’accès dont vous disposez. C’était aussi l’un des sujets d’une discussion lancée cette semaine par Andrej Karpathy sur les réseaux sociaux [1], qui a cumulé des millions de vues en quelques jours. Je pense qu’il a raison sur l’essentiel, alors je veux parcourir son post avec vous, niveau par niveau, et vous donner mon avis, car je vois la forme un peu différemment de lui, avec un sommet qui se divise en deux.
Karpathy écrit que l’écart est désormais « less 'two groups of people speaking past each other' and more a sharp funnel », c’est-à-dire moins deux groupes qui ne se comprennent pas qu’un entonnoir étroit. Son calcul simple est le suivant. Environ 6 milliards de personnes « have barely come in contact with LLMs at all », elles n’ont presque jamais été en contact avec des LLM. Environ 1 à 2 milliards sont des « casual and infrequent users of free-tier ChatGPT-like products », des utilisateurs occasionnels de produits gratuits de type ChatGPT. Ce groupe « sees derpy chatbots and treats them a bit like a better Google search », il voit des chatbots un peu maladroits et les traite comme un meilleur moteur de recherche Google. Il y range aussi « even many professionals outside of math&code », de nombreux professionnels hors mathématiques et programmation, dirigeants compris, qui comprennent le sujet intellectuellement mais seulement de seconde main. Viennent ensuite environ 20 millions de personnes qui utilisent des LLM de pointe dans leur métier, en mathématiques et en programmation, et qui « see first-hand that large, complex projects that used to take them weeks/months can now be completed by agents with a prompt », qui voient de leurs propres yeux des agents boucler en un prompt des projets qui leur prenaient des semaines ou des mois. Tout en haut, il place les quelque 5 000 personnes « with access to frontier-grade systems internally », qui ont accès en interne aux systèmes les plus avancés, où l’on voit des « swarms of thousands of agents collaborating over weeks on software mega projects », des essaims de milliers d’agents qui collaborent pendant des semaines sur des méga-projets logiciels [1].
Il explique aussi pourquoi l’entonnoir a cette forme, et ce que je trouve le plus utile, c’est que les capacités atteignent leur sommet (« peaks ») dans un travail numérique, vérifiable automatiquement et qui rapporte aussi de l’argent aux labs, au-delà de la simple question du niveau d’accès dont vous disposez.
Je suis d’accord avec l’essentiel de ce que dit Karpathy. Je parlerais simplement d’une pyramide d’utilisateurs, puisque chaque niveau est un groupe plus petit posé sur celui du dessous, et je diviserais la dernière partie de son entonnoir en deux. Pour moi, il y a une vraie différence entre les personnes qui utilisent les modèles frontière publics actuels et celles qui, dans les labs, utilisent des méga-modèles internes qui vont dans la direction de l’AGI, ce qui veut simplement dire ici des modèles bien plus puissants que tout ce à quoi vous avez accès, quel que soit le nom qu’on leur donne. Cela donne cinq niveaux, que je vais parcourir avec vous de bas en haut.
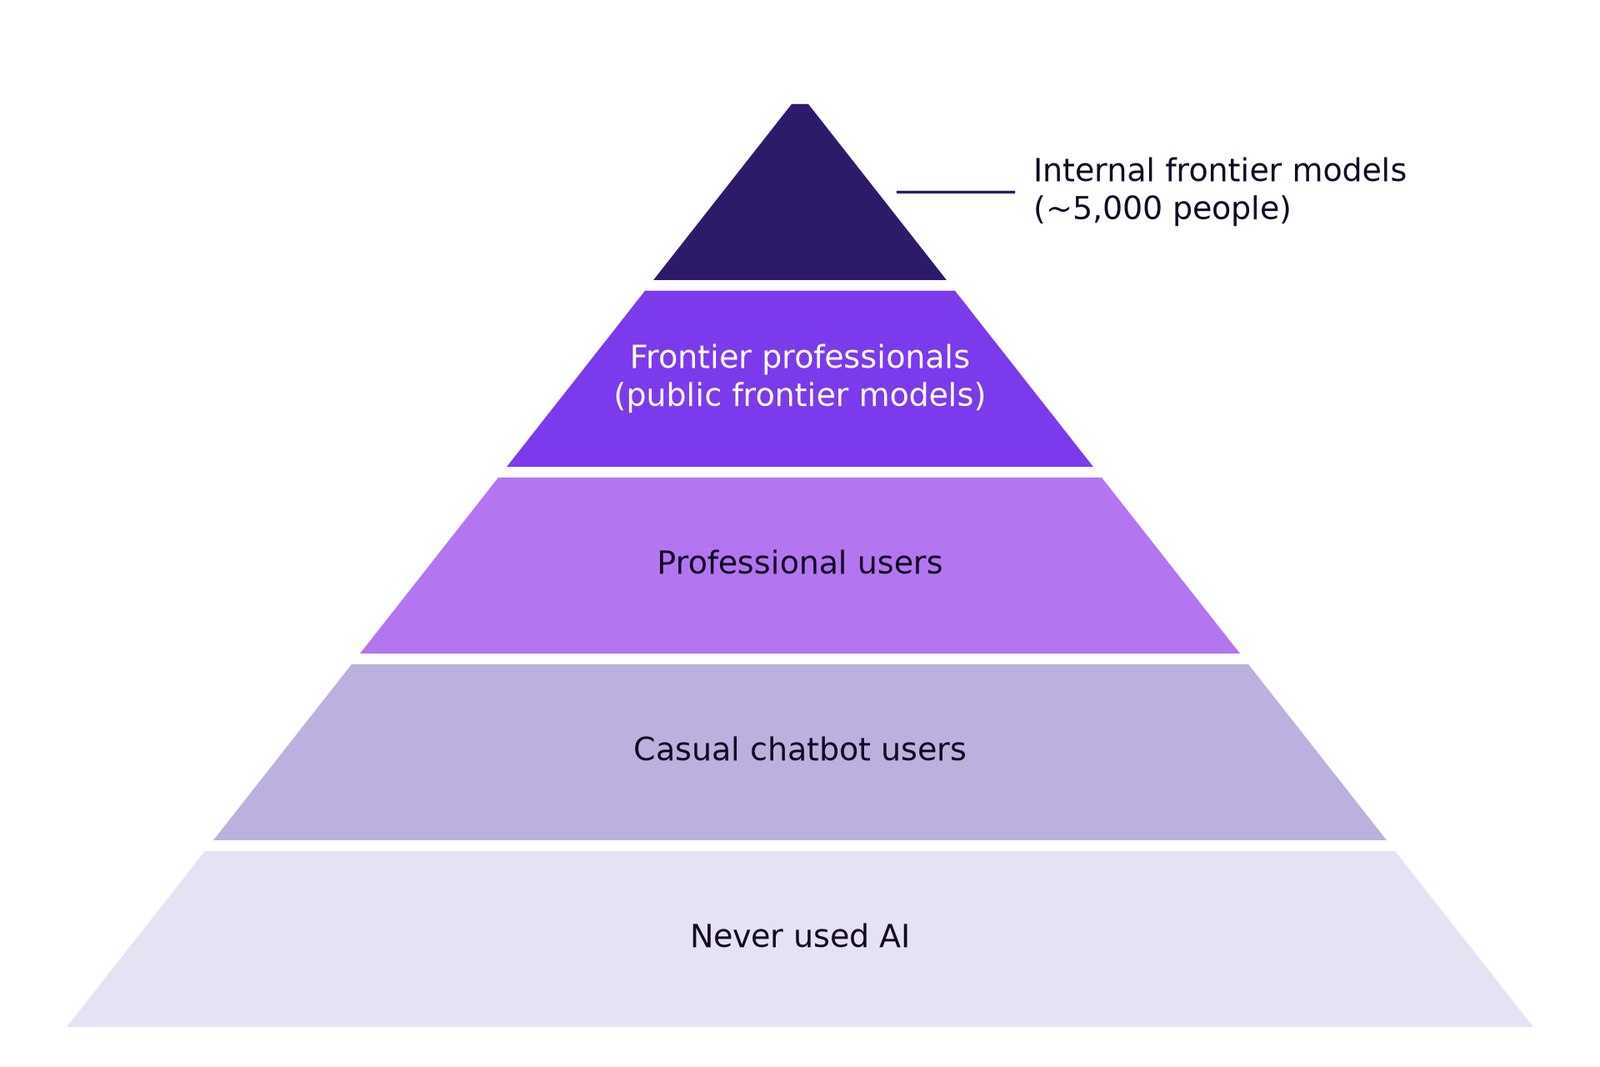
Image de l’auteur.
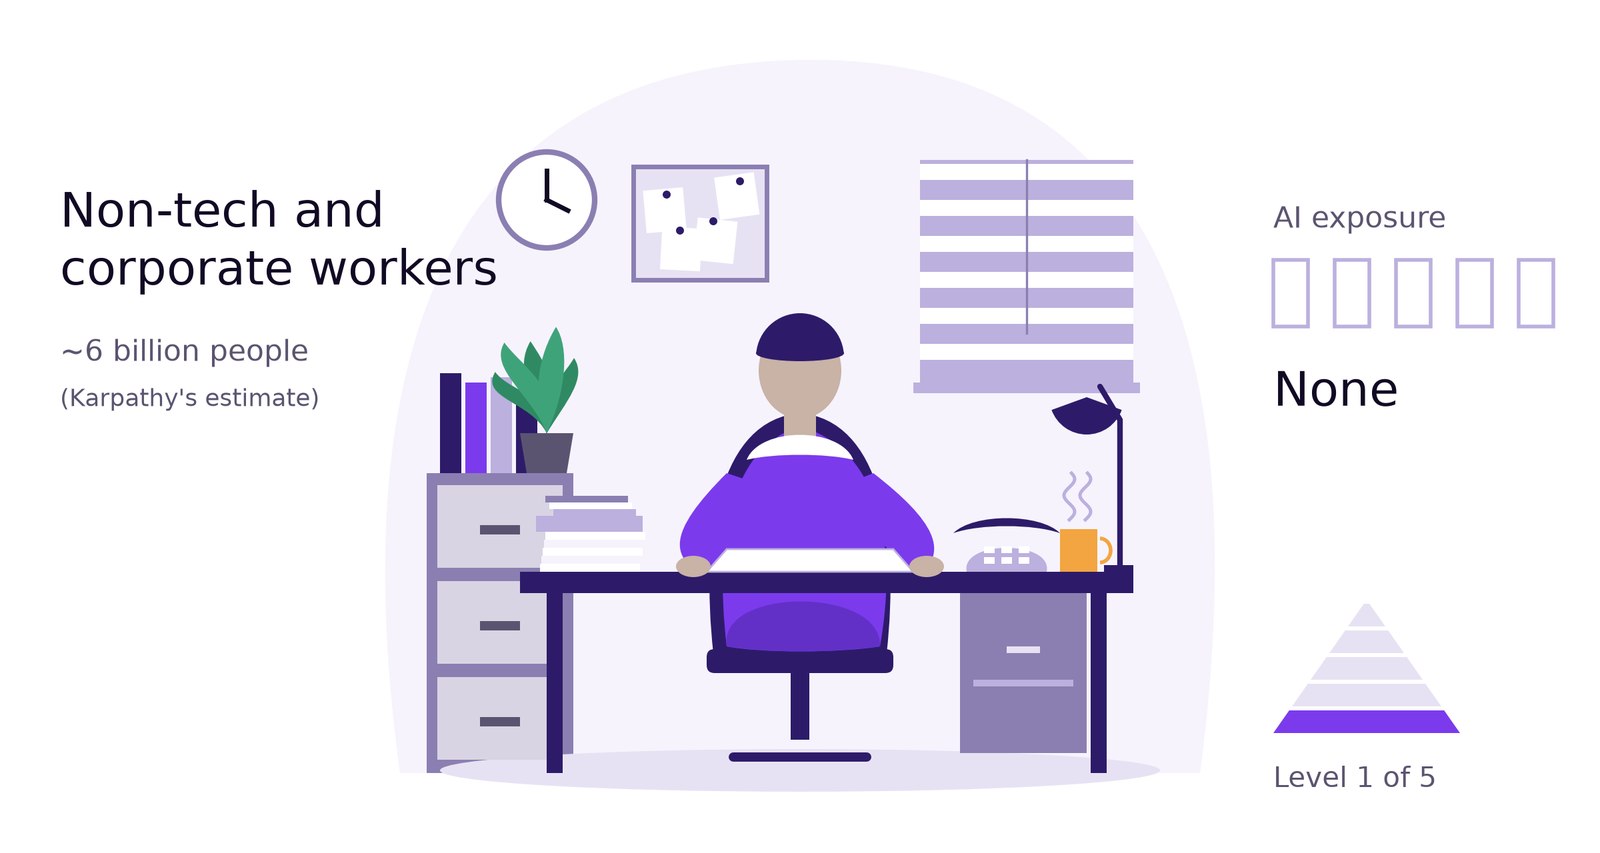
Image de l’auteur.
Je ne viens pas du monde de la tech. J’ai grandi dans une boulangerie, dans une région très rurale d’Allemagne, et je prends cette toute petite population comme exemple. Surtout quand on parle des emplois ordinaires là-bas, pas des emplois mieux payés, les gens n’ont en général jamais vraiment été en contact avec quoi que ce soit. Je ne parle pas d’emplois à cent mille euros, et pour donner un ordre d’idée, cent mille euros, c’est beaucoup d’argent dans l’Allemagne rurale. Dans la Silicon Valley peut-être pas, mais là d’où je viens, si. Ce que les gens savent de l’IA vient surtout de la presse à sensation, de la Bild-Zeitung allemande, avec toute la folie autour de l’IA et des drones IA, et ils en sont donc un peu intimidés, ce que je comprends honnêtement.
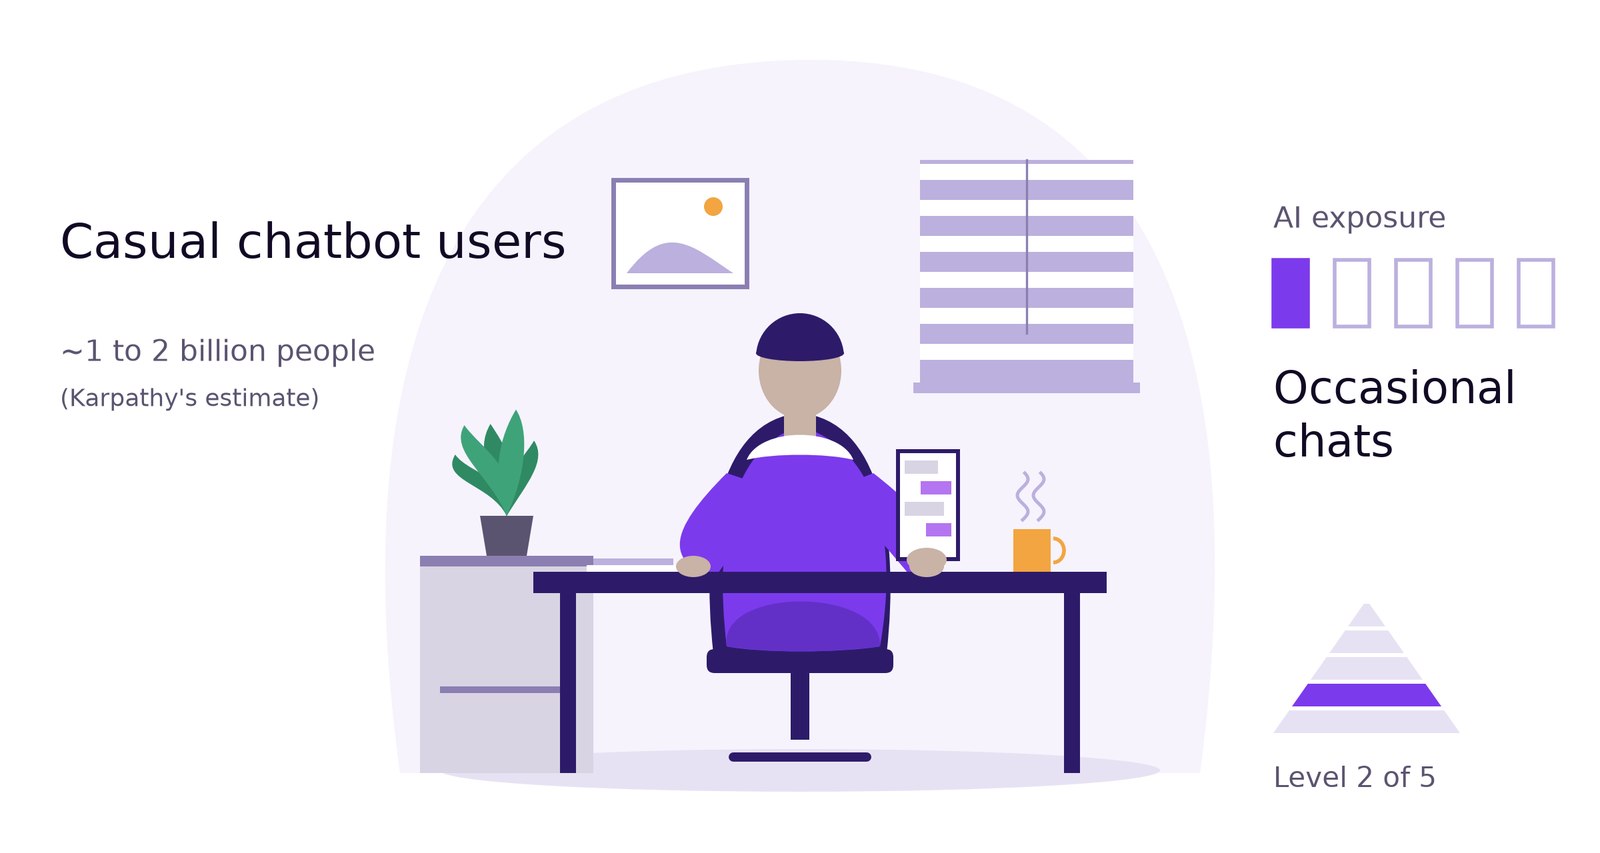
Image de l’auteur.
Il y a ensuite tout un groupe de personnes, en général dans la trentaine ou la quarantaine, qui ont utilisé ChatGPT à un moment donné. Si l’on parle seulement de ChatGPT, je dirais aussi qu’environ 20 % des gens de ma région d’origine l’ont essayé, ce qui est proche du chiffre de Karpathy. C’est bien sûr mon propre échantillon anecdotique, et j’ai beaucoup de personnes du secteur high-tech dans mon cercle social, donc c’est loin de la population mondiale, mais vu d’où je viens, cela semble plutôt raisonnable. Pour la plupart d’entre eux, l’IA est le chatbot maladroit que décrit Karpathy, quelque chose à qui ils ont posé quelques questions un jour.
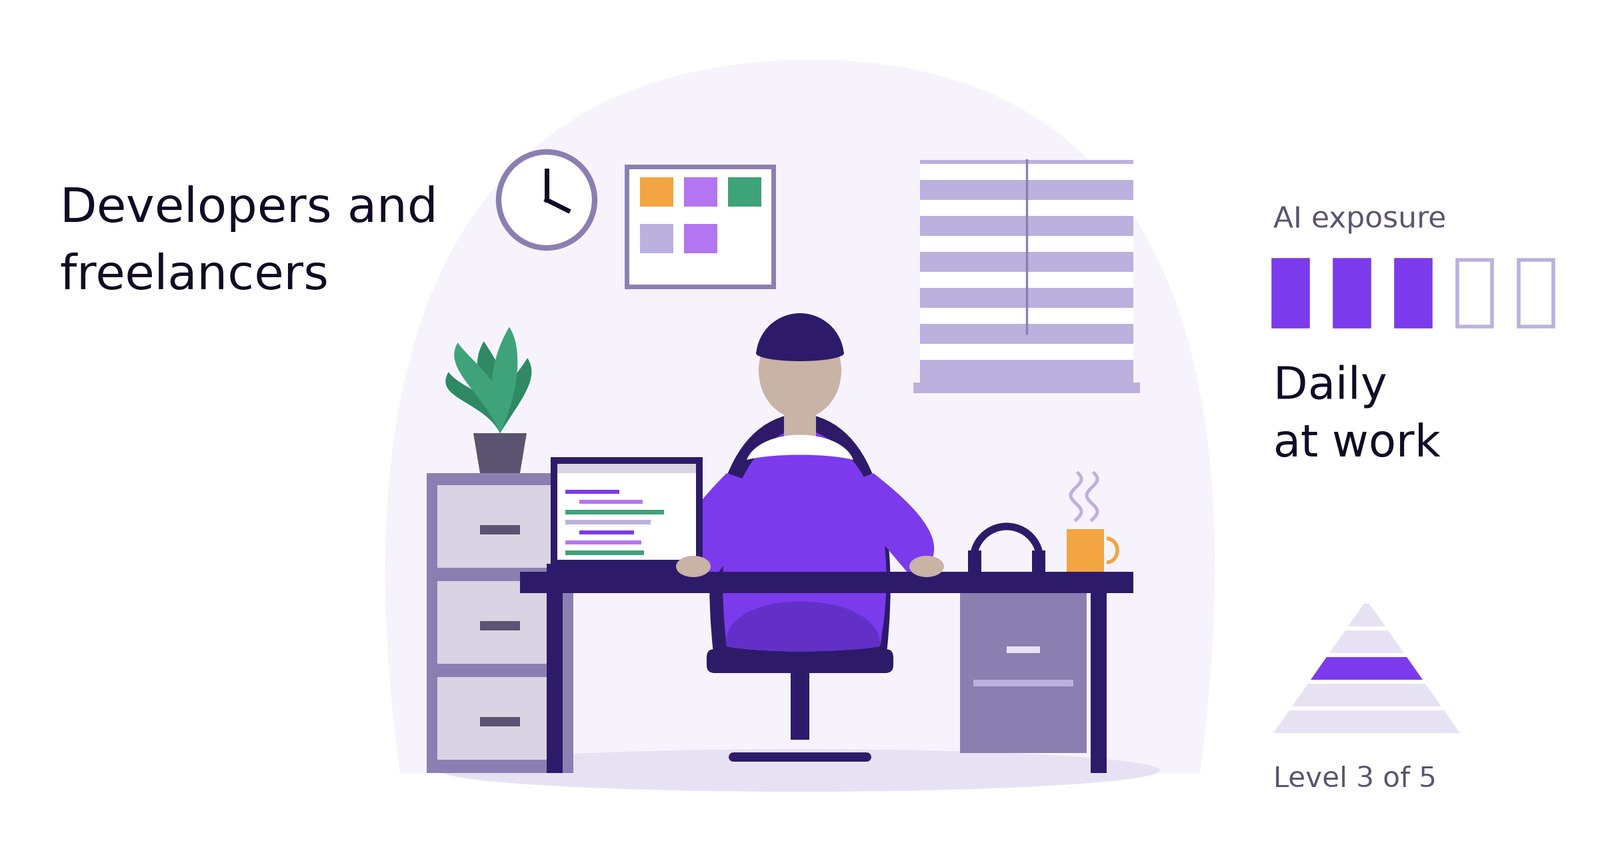
Image de l’auteur.
Le troisième niveau, ce sont les utilisateurs professionnels. J’échange chaque jour avec beaucoup de développeurs et de programmeurs, et en général les bons ont tous utilisé des LLM et deviennent pas à pas vraiment bons, au moins pour le code. Je passe aussi beaucoup de temps avec des freelances, et quand ils n’ont aucune restriction, ils se lancent, l’utilisent et lui trouvent de bons domaines d’application. Ils n’ont pas besoin de suivre quinze formations différentes et un programme de montée en compétences d’abord, ils lisent des articles et essaient des choses jusqu’à en tirer de la valeur. Pour moi, c’est l’un des points clés de tout ce sujet, la grande différence entre les entreprises d’un côté et les startups et indépendants de l’autre.
Je fais beaucoup de missions de conseil avec JadenX, y compris pour de grandes entreprises, et ce que j’ai constaté, c’est que dans les entreprises, et notamment les entreprises réglementées, les gens ont en général un an à un an et demi de retard dans ce qu’ils utilisent et dans leur maîtrise, par rapport aux véritables cracks de mon entourage quotidien, mes contacts sur X et mes amis. Et je ne les compare même pas aux 5 000 tout en haut, je parle de bonnes personnes qui utilisent ces modèles dans une mesure raisonnable et qui en tirent de la valeur.
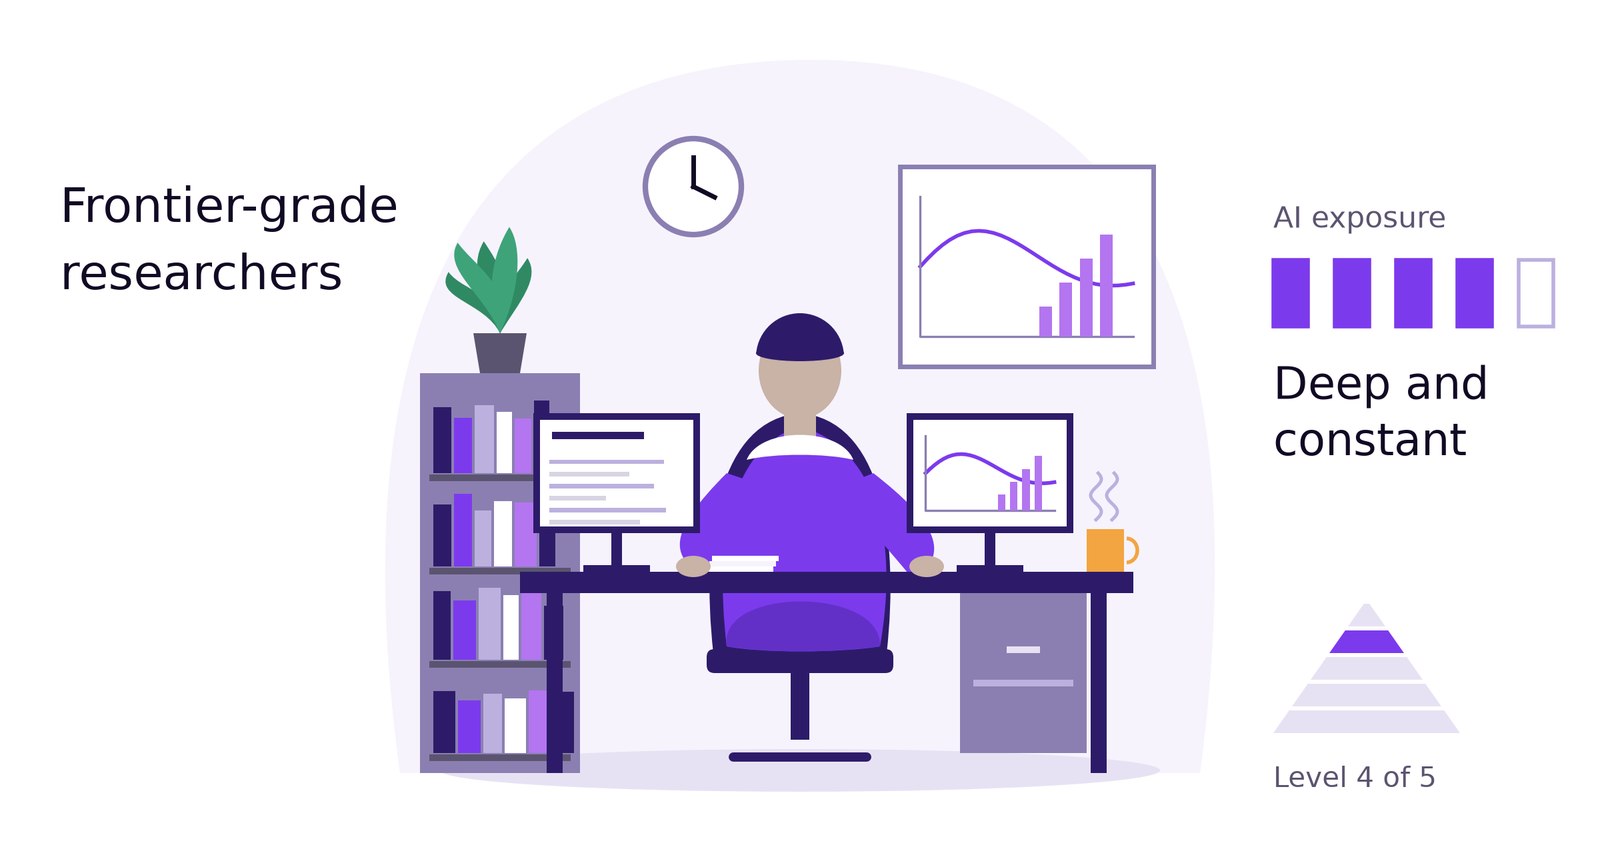
Image de l’auteur.
Le niveau supérieur de Karpathy, c’est là que naissent les méga-projets logiciels, les zero days (des failles de sécurité que personne n’a encore trouvées ni corrigées), les cyberattaques et les défenses à la vitesse de la machine, et la science nouvelle. Mais il existe aussi des personnes qui font une science vraiment de pointe avec des LLM sans faire partie de ces grandes organisations, et c’est le niveau que j’ajouterais. J’ai un parcours académique, et dans mon réseau, pas mal de personnes surpassent complètement leurs collègues universitaires en qualité et en rythme, parce qu’elles savent intégrer rapidement les LLM dans leurs processus de recherche. Je ne parle pas d’articles « slop », c’est-à-dire de textes médiocres produits à la chaîne par un modèle, assemblés dans ChatGPT puis soumis à des revues pour rien. Je parle de personnes qui utilisent correctement ces modèles dans leur recherche, avec beaucoup de succès, alors que les 80 % restants dans ces domaines disent en général : oh non, je ne peux pas faire ça.
À mon avis, ce n’est le plus souvent pas un problème d’IA pour des domaines comme les sciences sociales, ou même l’informatique appliquée, car les modèles publics disponibles suffisent pour y faire de la science de pointe. Dans une grande partie de la science actuelle où l’on travaille de manière statistique, il y a aujourd’hui un énorme avantage à bien les utiliser. Je n’écris plus beaucoup d’articles moi-même, mais je suis en contact avec beaucoup de personnes qui le font et qui en tirent quelque chose.
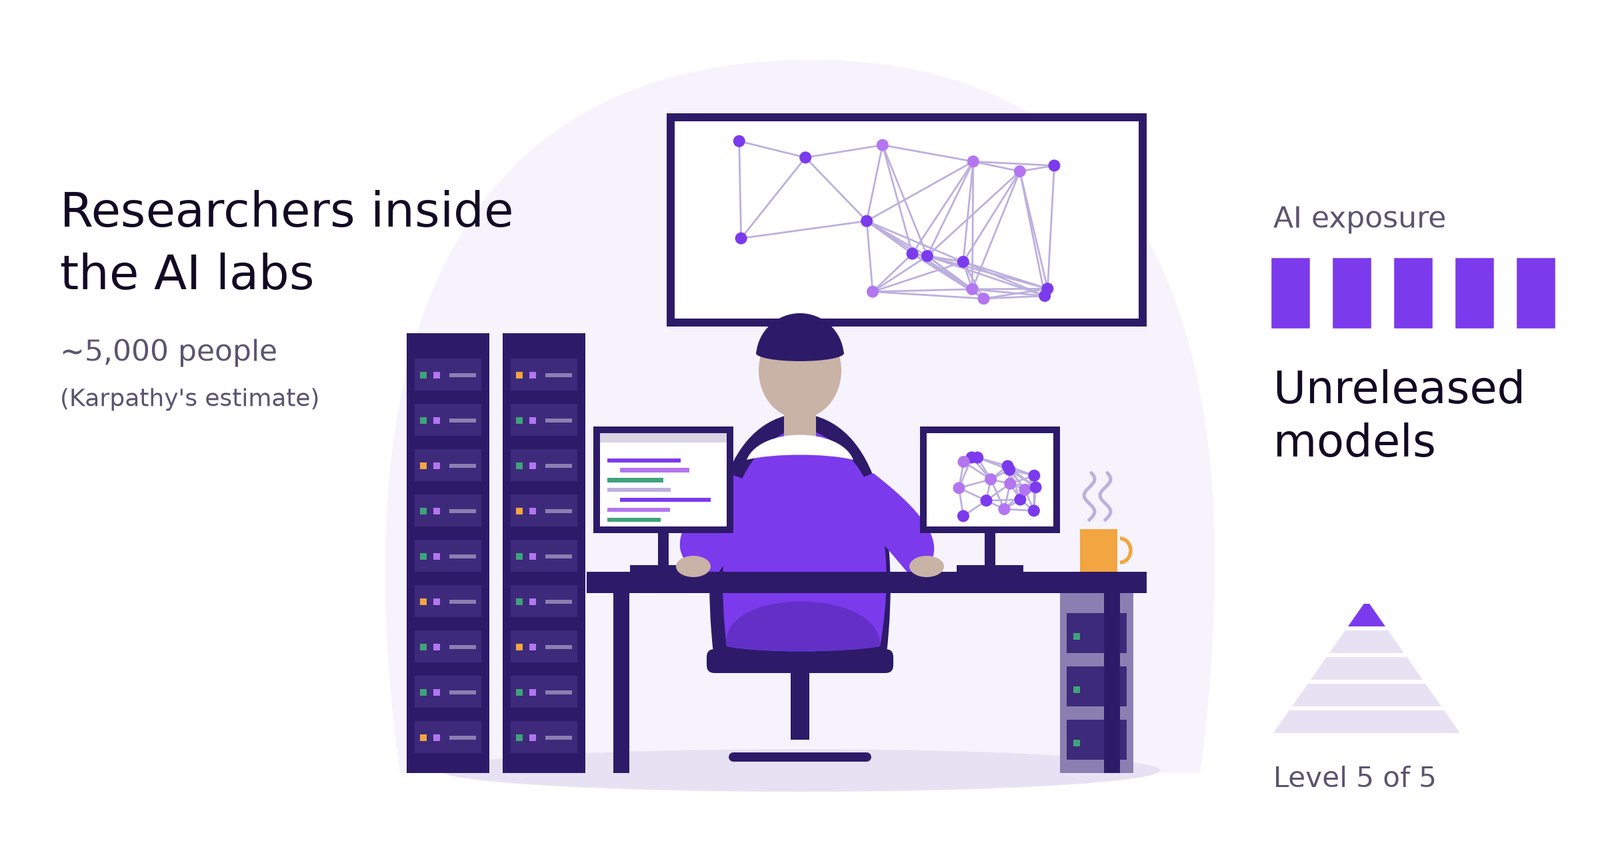
Image de l’auteur.
Il y a enfin le sommet, les quelque 5 000 personnes dont parle Karpathy et qui disposent des meilleurs modèles au monde, des méga-modèles internes qui vont dans la direction de l’AGI. Si vous cherchez à résoudre P vs NP, l’un des grands problèmes ouverts de l’informatique, ou à trouver des zero days à grande échelle, il vous faut bien sûr des modèles plus puissants que les modèles publics. Cette partie est réelle et je ne dis pas que Karpathy se trompe là-dessus, je pense simplement que l’essentiel du travail qui compte pour vous et moi se passe un niveau en dessous.
Ce que je recommande vraiment à tout le monde, c’est de viser l’avant-dernier niveau. Vous ne pouvez pas influencer les modèles auxquels vous avez accès, cela reste malheureusement entre les mains de très peu d’acteurs centralisés, et les gouvernements et la politique jouent aussi un rôle. Mais il existe des modèles très, très puissants que vous pouvez utiliser dès aujourd’hui dans vos processus, pour faire de la science et pour rendre ce monde meilleur, aussi étrange que cela paraisse. Alors utilisez-les et allez-y, rien ne devrait vous en empêcher. Oui, vous ne trouverez probablement pas avec eux les plus grandes failles de sécurité du monde avant tout le monde, mais vous pouvez avoir un impact scientifique de très bon niveau, et il en va de même pour votre travail quotidien.
Si vous voulez parler de la place que vous ou votre entreprise occupez sur cette pyramide, contactez-moi via JadenX.
[1] Andrej Karpathy, post sur X sur le fossé croissant dans la compréhension commune des capacités des LLM, 11 oct. 2026. https://x.com/karpathy/status/2109361546505966046. Le 14 oct. 2026, il comptait environ 6,35 millions de vues et 42 800 likes, et la discussion sur Hacker News [2] avait 716 points. Les parts de la population mondiale calculées par Karpathy lui-même, qu’il qualifie de calcul de coin de table : environ 75 % pour les 6 milliards, environ 20 % pour les 1 à 2 milliards, 0,2 % pour les 20 millions et environ 0,00006 % pour les 5 000.
[2] Discussion du post sur Hacker News, consultée le 14 oct. 2026. https://news.ycombinator.com/item?id=50047422
À propos de cet article : j’ai dicté mon avis sur le post de Karpathy, et un agent IA a transformé la dictée en ce brouillon, que j’ai ensuite retravaillé. Des agents IA ont aussi aidé pour la recherche, en rassemblant le post, la discussion sur Hacker News et les chiffres d’engagement. Les opinions sont les miennes. Ce texte est traduit de l’original anglais.
Cet article a d’abord été publié sur Medium.
Si vous cherchez à savoir où se situe votre équipe sur cette pyramide, ou si vous voulez que les modèles frontière publics changent vraiment vos processus, parlez-moi chez JadenX.